本册沿第二讲 B 段拆开同一台灰度数字 CNN:两组 Conv/ReLU/Pool,随后 Flatten→32→10。读完要把前向的形状变化和反向的参数共享对应起来。
按眼前的问题读:核对局部乘加看第 2 节,共享参数怎样收齐反馈看第 3 节,步长与感受野看第 4 节,完整接口看第 5 节,平移检验看第 6 节。第 1 节先提供整机地图;BatchNorm 的补充在册末按需查阅。
动手选择:LAB 01 · 学会一个卷积核 核对窗口与共享梯度;LAB 02 · 小 CNN 与图像平移 比较图像平移前后的预测;LAB 08 · 从真实响应到遮挡对照 读取真实响应并做遮挡对照。可先读保存结果,再选择一项条件修改;不要求把几项训练全部重跑。
1. 先认清机器,再区分结构和学习数值
课件与图解:先看我们要拆开的这台小CNN · 每次读附近,不同位置共用权重 · 人规定连接方式,训练调整具体测量
第一遍先沿模块向下读:图像怎样变成十个分数?第二遍只看输出形状:哪一步减少空间位置,哪一步只是换一种排列?
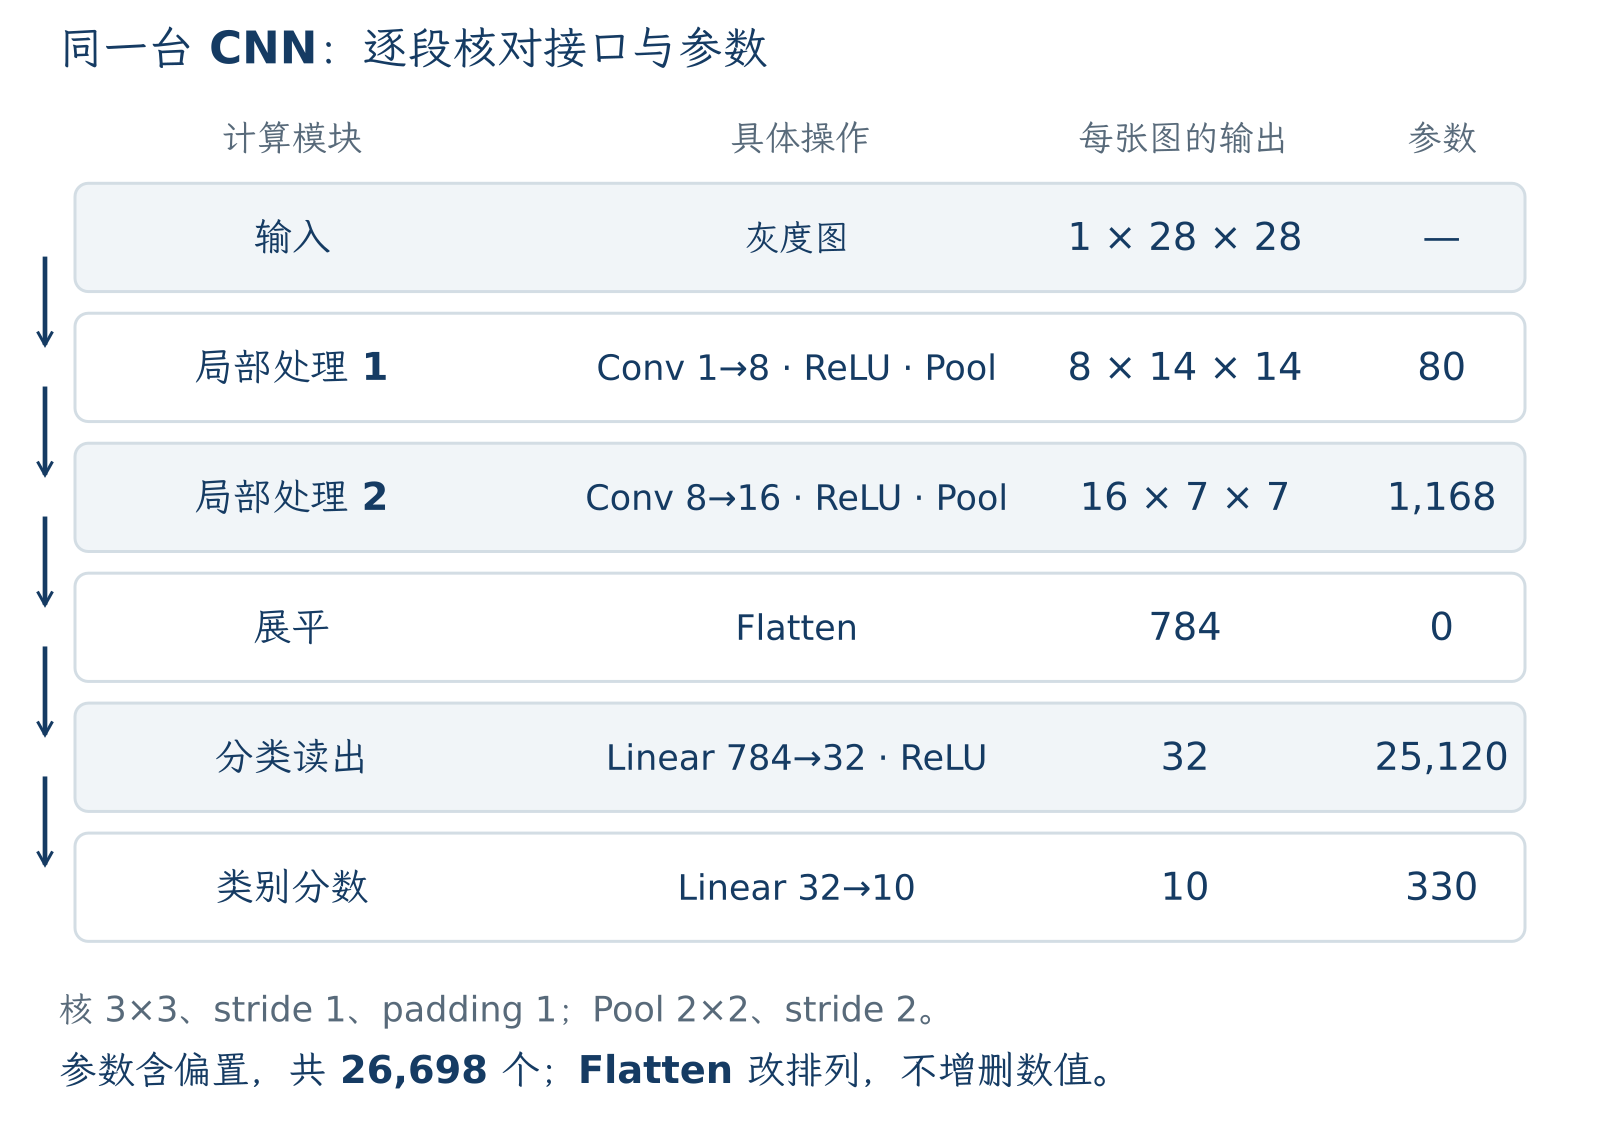
图中两组局部处理都含 Conv、ReLU、Pool。池化只缩小宽高,不改变通道数;Flatten 把 16×7×7 个值按固定顺序排成 784 维。类别标签在出口与十个分数形成损失,反馈再经读出和局部模块回到卷积权重。完整逐算子账本在第 5 节,便于把卷积和池化各自的作用拆开核对。
局部与共享是两个不同约束:一个输出只读附近窗口,限定读取范围;窗口移到另一处仍使用同一组核权重,限定哪些连接共用参数。人决定核大小、步长、通道数和共享方式,训练决定核中的具体正负数值。给出局部连接,不等于已经手工指定“检测哪种边缘”。更远的关系要由后续层继续组合。
先预测与核对:在模块图上标出有参数的操作,再口头把其中一层卷积展开为两个窗口;分别说出“由设计固定”和“可由标签反馈调整”的对象。核对:窗口位置可以不同,权重对象只有同一份。下一节把大图缩小到四个乘积,核对这个对象究竟算什么。
2. 一个输出、多个通道与多套 filter
课件与图解:四个乘积相加,产生一个输出 · 移动的是窗口,共用的仍是同一个核 · 一个filter读取全部输入通道 · 多套filter,保留多种局部响应
取 3×3 输入 [[0,1,2],[3,4,5],[6,7,8]],核为 [[0,1],[2,3]],步长 1、不补零。左上窗口与核逐项相乘:0×0+1×1+3×2+4×3=19。四个乘积只产生一个输出;向右、向下移动同一核,得到输出 [[19,25],[37,43]]。一次前向中改变的是读取的输入,核数值不改变。这里沿用深度学习框架常见的不翻转核的计算约定。
有多个输入通道时,一套 filter 含每个输入通道的一张核切片。选定输出位置,各通道先做局部乘加,再把贡献相加;Slides 的 RGB 缩例在该位置得到 1+6+1=8。它是另一个形状算例,不是把上一张 3×3 灰度输入直接变成 RGB。
张量 [N,Cin,H,W] 中 N 是图片数,Cin 是每张图的通道数;标准卷积权重 [Cout,Cin,Kh,Kw] 的每一套 filter 读取全部输入通道。于是输入 [2,3,5,5]、权重 [4,3,3,3]、stride=1、padding=0,得到 [2,4,3,3]。求和消去的是同一 filter 内的输入通道轴,多套 filter 分别留下多个输出通道,图片轴不会被混合。
先预测与核对:先补出 25、37、43,再标出上述三个张量中数字 2、3、4 的不同含义。下一问题是:同一核在多处使用,各处错误怎样改变同一份参数?
3. 路径贡献先相加,再追问反馈来自哪里
课件与图解:两个窗口的贡献,汇总到同一对核权重 · 只有类别标签,局部窗口怎样收到反馈? · 重复同一学习循环,核逐步形成目标响应
先找对象:图中有两个使用位置,但只有一份 K。两个位置各自收到反馈之后,究竟应改哪一份参数?
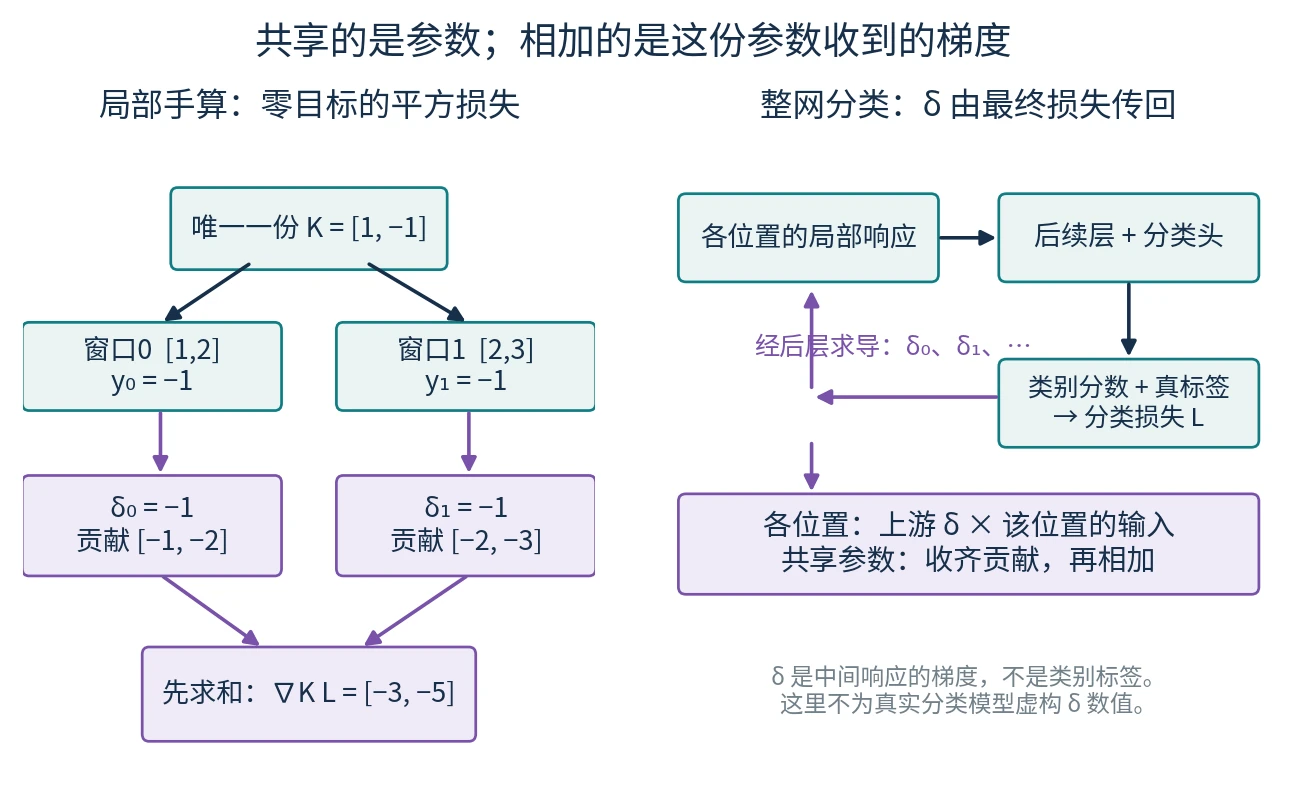
左图:把一次更新算闭合。 X=[1,2,3],K=[1,−1],两个窗口输出 y₀=y₁=−1,目标均为 0。使用求和损失 L=½(y₀²+y₁²)=1,不再除以窗口数;上游反馈 δᵢ=∂L/∂yᵢ=−1。
| 旧核上的路径 | 对 k₁ 的贡献 | 对 k₂ 的贡献 |
|---|---|---|
| 窗口 0 | −1×1=−1 | −1×2=−2 |
| 窗口 1 | −1×2=−2 | −1×3=−3 |
| 先求和 | −3 | −5 |
η=0.05 时,统一更新为 K′=[1.15,−0.75];再前向得到 y′=[−0.35,0.05],新损失 0.0625。如果算完第一个窗口就改核,第二个窗口算的就不再是同一次旧参数前向的导数。
右图:保留局部公式,换清反馈来源。 真实分类只有类别标签,没有给每个中间窗口指定“正确图案”。最终类别损失经后续 ReLU、池化、卷积和分类头传回 δ₀、δ₁,它们可以不同,也不是标签本身。局部公式仍是 ∂L/∂k₁=1δ₀+2δ₁、∂L/∂k₂=2δ₀+3δ₁。1D 核只缩小了计算对象;此处没有给真实 3×3 分类模型虚构梯度数值。
差分核学习页 换了一项实验。 LAB 01 的核学习以差分响应为监督,核逐渐趋近 [1,−1];目标已从刚才的 [0,0] 换掉。这段训练轨迹不能接在上表后面,也不等于图像分类已经成功。
先预测与核对:独立算 k₂ 的两份贡献与新损失,然后沿右图指出 δ 从哪里来。下一节先固定这些权重,只改变窗口的合法起点。
4. 窗口起点决定尺寸,层叠与池化改变空间信息
课件与图解:输出尺寸,可以用合法窗口起点数出来 · 步长2,只计算每隔一格的窗口 · 层叠后,一个局部响应能联系更远的输入 · 池化保留一种统计,舍弃部分细节
先看一条轴,再扩展到二维。 下图的每一行是一处窗口起点,右侧是它唯一对应的输出地址。
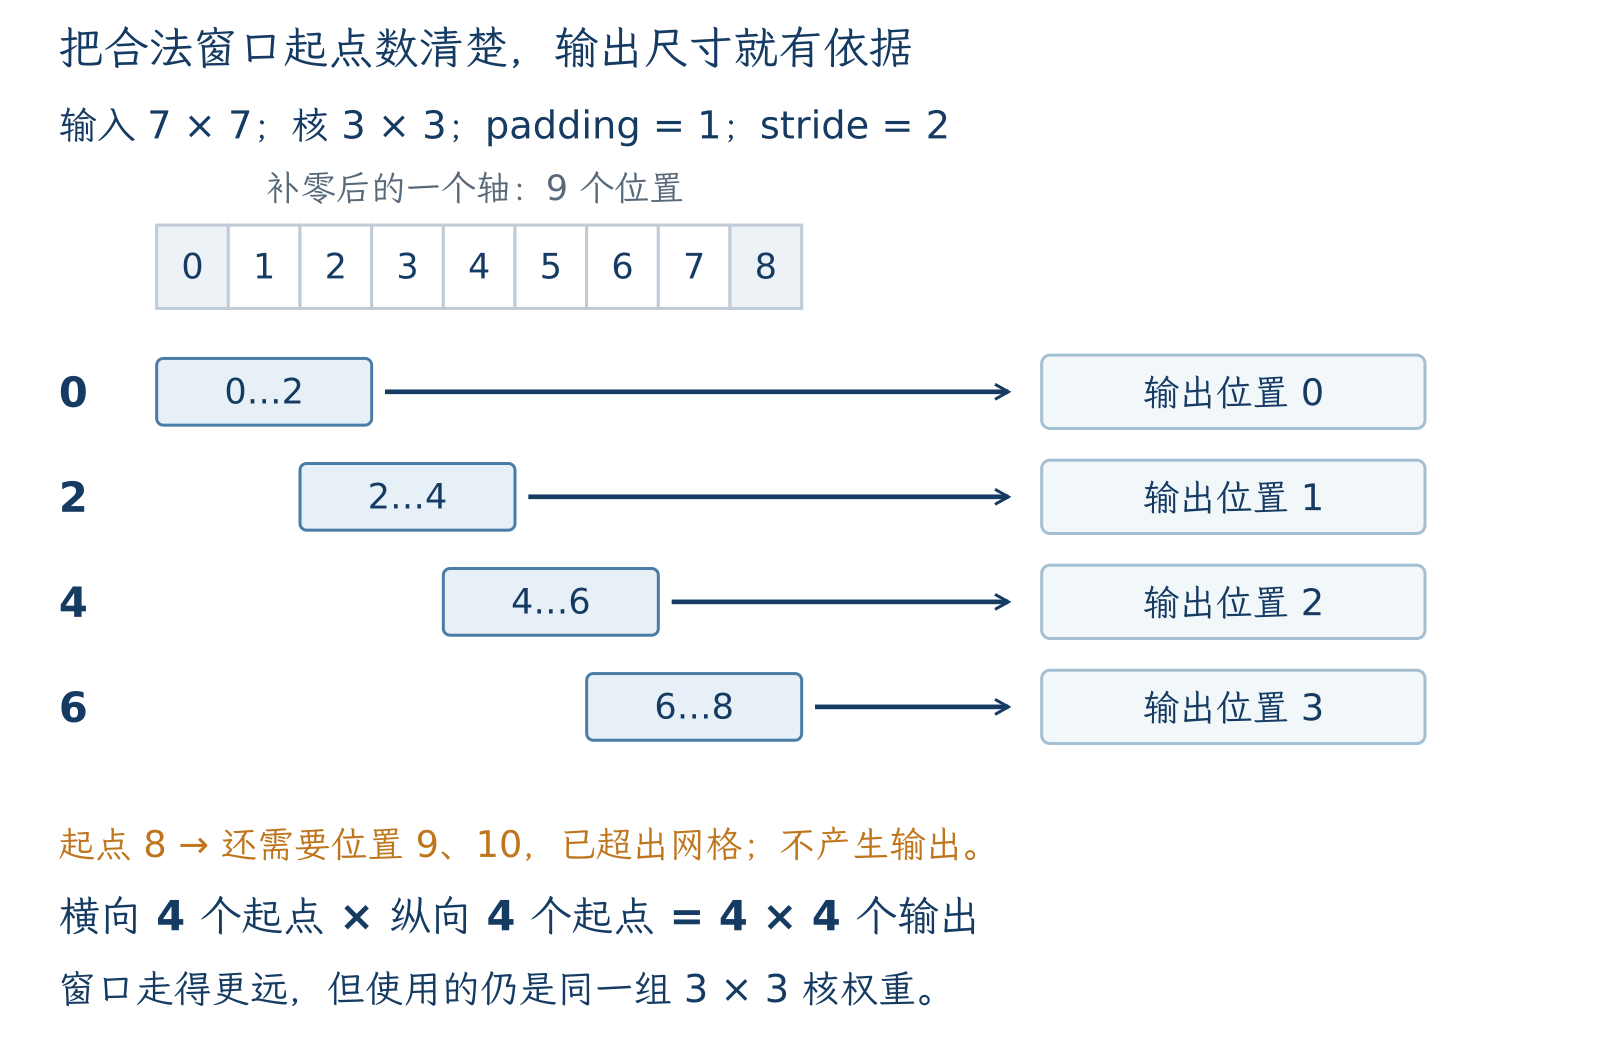
7×7 输入用 3×3 核,四边补一圈 0(P=1),计算网格为 9×9。步长 1 时每轴有 7 个合法起点,输出 7×7;保持输入、核、补零和核权重不变,只把步长改为 S=2。现在每轴从 0 开始按 2 移动,合法起点是 0、2、4、6。起点 6 的三格仍在 9 格计算网格内;再到 8 时窗口会越界,所以不生成第五个输出。每轴有 4 个输出,二维合起来就是 4×4;变化的是计算哪些窗口,不是换了一套权重。每轴输出数可写为 floor((n+2p−k)/s)+1,这里不使用空洞卷积。补零规定边界外的值,并未增加真实观测。
层叠扩大一个输出可能依赖的输入范围。为隔离 stride 的作用,感受野递推页 使用独立三层算例:核宽都为 3,stride 依次为 1、2、1。从范围 r=1、相邻输出间隔 j=1 开始,逐层先算 r′=r+(k−1)j,再算 j′=js,得到 (r,j)=(3,1)、(5,2)、(9,2)。第三层新增的两个邻居间隔已是原图的两格,所以覆盖范围从 5 扩大到 9。这不是本课小 CNN 的逐层结构。
本课 CNN 采用 2×2、stride=2 的最大池化,每个通道分别保留局部峰值;宽高减半,通道数不变。多个响应变成一个统计,窗口内精确位置与其他值不能全部恢复。理论覆盖范围说明存在计算路径,不保证范围内每个像素对当前响应都有非零影响。
先预测与核对:只把 stride 改成 3,先列起点再计算每轴输出数;核对为 0、3、6,输出 3×3。随后做三层范围递推,解释最大池化与仅改变采样起点分别丢掉了什么。接下来把这些空间操作放回真正训练过的同一台小 CNN。
5. 从真实响应到 784 维,形状和参数逐项对上
课件与图解:真实特征图里,仍能看见响应在哪里 · 沿同一台小CNN,核对三个关键接口
这次看真实数值。 固定官方 MNIST test 0(标签 7),让它经过已经训练好的同一台 CNN。先找:哪些通道的亮处相近?哪些通道在同一位置几乎没有响应?
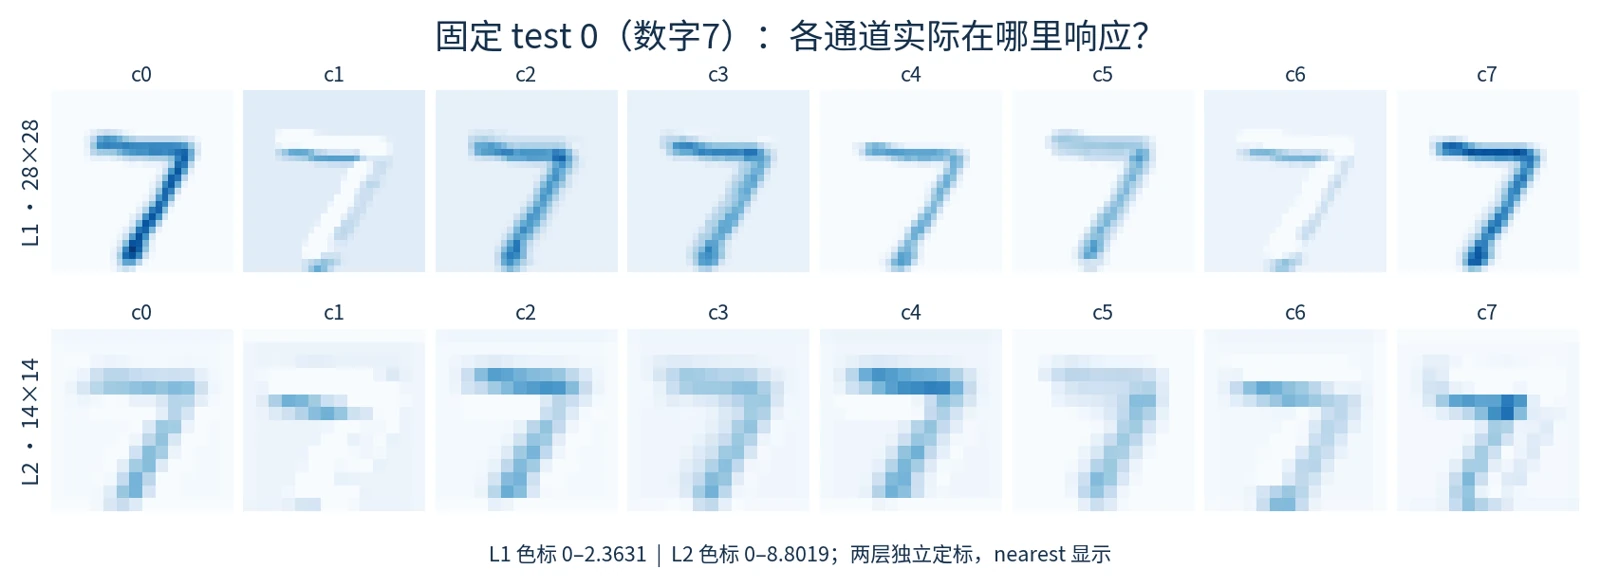
第一行是 ReLU 后、pool1 前的全部 8 个 28×28 通道;第二行是 ReLU 后、pool2 前 16 个 14×14 通道中的前 8 个。通道保留不同响应,空间格保留响应发生在哪里。 这些图还不足以给通道命名为某类物体检测器,同通道的三个固定输入比较紧接这一观察问题;它仍不足以建立语义命名。
读图条件:输入 uint8/255;每层跨 test 0/1/2 的所有通道共用 Blues 色标,L1 为 [0,2.3630995750427246],L2 为 [0,8.801921844482422],nearest 显示。两层独立定标,不能凭“哪层更蓝”比较绝对幅值。主讲金框表示理论输入支持范围,不是因果归因。
再把图放回形状账本。
| 操作后,每张图 | 形状 | 本操作可训练参数(含偏置) |
|---|---|---|
| Conv 1→8,3×3,p=1,stride=1 / ReLU | 8×28×28 | 80 |
| MaxPool 2×2,stride=2 | 8×14×14 | 0 |
| Conv 8→16,3×3,p=1,stride=1 / ReLU | 16×14×14 | 1168 |
| MaxPool 2×2,stride=2 | 16×7×7 | 0 |
| Flatten | 784 | 0 |
| Linear 784→32 / ReLU | 32 | 25120 |
| Linear 32→10 | 10 | 330 |
总参数 26,698。Flatten 按固定顺序重排 16×7×7 个值,没有删值;前面的池化已舍弃过部分细节。十个输出是类别分数,训练时再与标签形成损失。
先预测与核对:遮住参数列,用“输出数×每个输出的权重数+偏置”核对参数最多的 Linear 层,再解释为什么 Flatten 参数数为零。保持这个模型,下一节检验图像移动后类别分数是否稳定。
来源:既有 cnn-plain-state.pt,最小验证交叉熵选择 epoch 6。本图重新排版已保存的前向数组,未重新训练。完整身份、色标及通道值见响应清单;LAB 08 可重新前向核对。
6. 响应能随位置移动,分类分数就一定不变吗?
课件与图解:响应跟着移动,不等于类别分数保持不变 · 只移一格,同一条纹会被采成另一组数 · 同一模型加上增强,哪些结果改变了? · 回到同一台CNN,解释预测与学习
共享卷积在不同位置使用相同规则。固定同一份参数,在 stride=1 的内部区域,输入平移可带来对应的响应平移,这叫等变。先保留原输入与原响应,移动输入后预测响应的新位置,再揭示比较。有限边界、稀疏采样、池化和后续读出仍可能改变整网结果;“响应随输入移动”和“最终类别分数不变”是不同的主张,后者要另做检验。
采样相位页 固定采样位置 0、2、4、6。交替序列 [0,1,0,1,0,1,0,1] 被采成 [0,0,0,0],周期平移一格后被采成 [1,1,1,1]。若先两格平均,两种相位都变成 0.5,同时丢掉条纹细节。这个构造例只说明采样相位的风险,分类表现要在真实模型与指定协议上另外检查。
平移对照页 读取既有四条件实验,固定数据划分、样本量、验证选择规则和指定的 right_2px 测试。每行应先在同一模型内部比较有无训练增强:
| 模型与训练设置 | 原图测试准确率 | 右移 2px 测试准确率 |
|---|---|---|
| MLP,无增强 | 92.11% | 66.39% |
| MLP,有增强 | 89.94% | 84.21% |
| CNN,无增强 | 95.33% | 84.64% |
| CNN,有增强 | 95.81% | 93.84% |
本次 CNN 的指定平移测试从 84.64% 升到 93.84%,原图从 95.33% 升到 95.81%;MLP 的原图准确率却下降。证据支持这套协议中的具体比较,不能推广为增强改善所有模型、所有指标,更不能把有无增强的不同检查点混称同一参数快照。未增强 CNN 的原图 9533/10000、右移 8464/10000 已与现有检查点前向复核一致。
先预测与核对:选出直接支持“CNN 加增强后右移测试改善”的两格,计算提高 9.20 个百分点,再给出不能推出的结论。最后沿 CNN 学习闭环页 复述:局部表示→Flatten 读出→类别损失→各位置反馈→共享权重求和更新。这个失败说明必须在完整网络和固定协议下检查结构主张。第二讲随后比较深度、分支、连接和成本;分布变化与适应的按需补充见第二讲 CLS 08;可迁移表示与学习信号进入第三讲。
把本段主线连起来
课件与图解:本段起点;逐页入口见上方各节。
请沿同一台 26,698 参数的 Flatten CNN 讲清两个方向。前向:局部乘加、通道汇总、空间采样、展平与类别读出。反向:最终标签形成损失,后层传来 δ,每个共享位置贡献“δ×局部输入”,汇总后才更新。
四种证据要分开:窗口小算例核对计算;零目标例核对一次共享更新;差分目标记录检验核学习;既有 MNIST 记录检验分类与指定平移。不要互相替代。完整共享梯度动手见 LAB 01 · 学会一个卷积核,真实检查点的响应与遮挡操作见 LAB 08 · 从真实响应到遮挡对照。
课堂核对:先预测,再运行
课件与图解:本段起点;逐页入口见上方各节。
下面只用标准库核对 2D 乘加、零目标共享梯度与参数账单。先预测每个窗口输出,再写出两条梯度路径。代码对同一旧核收齐梯度后只更新一次;它没有运行完整 CNN 训练,也不会产生新的准确率。
查看代码 · 单元 19
from math import isclose

image = [[0, 1, 2], [3, 4, 5], [6, 7, 8]]
kernel = [[0, 1], [2, 3]]
out = [[sum(image[r+a][c+b]*kernel[a][b] for a in range(2) for b in range(2))
        for c in range(2)] for r in range(2)]
assert out == [[19, 25], [37, 43]]
print('二维输出:', out)

X, K, target = [1.0, 2.0, 3.0], [1.0, -1.0], [0.0, 0.0]
def forward(k):
    return [sum(X[i+j]*k[j] for j in range(2)) for i in range(2)]
def loss(k):
    return 0.5*sum((y-t)**2 for y, t in zip(forward(k), target))
y = forward(K)
delta = [a-b for a, b in zip(y, target)]
paths = [[delta[i]*X[i+j] for j in range(2)] for i in range(2)]
grad = [sum(row[j] for row in paths) for j in range(2)]
assert K == [1, -1] and y == [-1, -1] and grad == [-3, -5]
assert isclose(loss(K), 1.0)
eta = 0.05
new_K = [k-eta*g for k, g in zip(K, grad)]
assert all(isclose(a, b) for a, b in zip(new_K, [1.15, -.75]))
assert all(isclose(a, b, abs_tol=1e-12) for a, b in zip(forward(new_K), [-.35, .05]))
assert isclose(loss(new_K), .0625)
print('各窗口梯度贡献:', paths, '总梯度:', grad)
print('新核:', new_K, '新输出:', forward(new_K), '新损失:', loss(new_K))

counts = {'conv1': 8*(1*3*3+1), 'conv2': 16*(8*3*3+1),
          'linear1': 32*(16*7*7+1), 'linear2': 10*(32+1)}
assert 16*7*7 == 784 and sum(counts.values()) == 26698
print('参数账单:', counts, '总数:', sum(counts.values()))课件与图解:本段起点;逐页入口见上方各节。
再改一个条件:仍从旧核 [1,−1] 出发,只改学习率,先预测新损失是否还会下降。请把新输出标为零目标构造例,不覆写 LAB 01 · 学会一个卷积核 的差分目标记录。然后不借用 δ=−1 的特例,用符号解释只有类别标签时 δ₀、δ₁ 怎样来到共享核。
架构支撑:BatchNorm 的统计与 affine 参数
对输入 $X\in\mathbb R^{N\times C\times H\times W}$,BatchNorm2d 在每个通道内先规范化,再作可学习变换:
$$\hat x=\frac{x-\mu_c}{\sqrt{\sigma_c^2+\epsilon}},\qquad y=\gamma_c\hat x+\beta_c.$$
$\mu_c,\sigma_c^2$ 是所选统计;$\gamma_c,\beta_c$ 是每通道各一个的 affine 参数。使用当前 batch 时,统计汇总同通道的 $N,H,W$ 位置。因此同一张图的响应也会依赖 batch 同伴。一个与主讲一致的精确构造:单通道、每图一个位置,固定当前图的激活 $x=3$;同伴为1时均值2、方差1,同伴为5时均值4、方差仍为1。固定 $\gamma=1,\beta=0$,当前图输出便从 $+1/\sqrt{1+\epsilon}$ 变为 $-1/\sqrt{1+\epsilon}$。BatchNorm2d 公式、统计维度与 buffers。
运行统计不是可学习参数。 训练模式下可以估计当前 batch 统计,并把估计积累为 running buffers;推理模式通常读取保存统计。$\gamma,\beta$ 由优化器的梯度步骤改变,buffers 的滑动积累不需要参数梯度。因此 requiresgrad=False、nograd、eval 控制不同对象。具体框架配置见 LAB03/LAB05。
先在单通道构造中固定当前值3,比较同伴1和5;然后问模型是否采用当前 batch 统计。这个小构造解释依赖关系,不声称真实图像分类已经发生相同变化。
课程导航
第二讲导读与完整索引 · 继续 CLS 04 · 加深与残差
在 Deepnote 返回 CLS 00 · 第二讲导读。静态课件链接返回对应主题;需保留原 Slides 停点时,请在新标签页打开材料。