LAB 01 · 学会一个卷积核
返回第二讲 · 局部乘加与共享反馈 · 第二讲导读与学习材料
一个核在多个位置使用,更新时听谁的意见? 这本材料把局部乘加、共享梯度和框架实现接起来;不需要先训练图像分类器。
| 想解决的问题 | 去哪里、怎样做 | 先看哪个输出 |
|---|---|---|
| 四个输出为什么共用一组权重 | 第1节 → 第3节;先运行“准备与使用”的导入代码,再运行各节代码 | response 与各位置梯度贡献的和 |
| 输入通道求和、输出通道堆叠有什么区别 | 文末“从循环到 Parameter”;这个代码块自带导入,可单独运行 | Input / Weight / Output、注册参数和三项误差 |
| 拟合对响应是否等于找到唯一核 | 文末“输出都拟合对了……”;独立运行 | 常数输入与新探针的响应差、设计矩阵的秩 |
课堂先选中间一项。 写出默认输出形状,再只把 C_IN=2 改为 3,其余三个量保持 C_OUT=3, KH=2, KW=2。重新运行同一个独立代码块:输出通道数和空间形状应保持,核参数与每个输出的求和项会变化。用输出和参数表检查预测。完成后再决定是否读第3节的完整梯度推导。
本册参考图是已保存的本地结果;你在副本中运行的输出单独记录,不覆盖或混称为课件原结果。
主路径:1 → 2 → 3 → 6。 把前向局部乘加、参数共享和反向梯度连成一条链;4、5、7 为深入阅读。
我们要回答:卷积相比普通全连接层究竟排除了哪些函数?同一个 kernel 在许多位置被调用,更新时听谁的意见?框架源码为什么只剩一次函数调用?
给二维隐藏层保留空间索引,线性映射可写作 \[ Y_{i,j}=b_{i,j}+\sum_{a,b}V_{i,j,a,b}X_{i+a,j+b}. \] 重索引还没有减少参数。要求各位置采用同一规则,令 $V_{i,j,a,b}=K_{a,b}$;要求局部连接,再将窗口外权重设为零。这是对函数类的约束:如果绝对位置携带任务信息,此先验可能有代价。
目标
从手算输出进入多通道,再把共享梯度写成公式和代码;改变stride与边界,检验等变条件。
准备与使用
本册可独立从头运行;跨册文件依赖在相应准备节单独说明。需要 Python 3.10+ 与 numpy matplotlib torch ipython;保存/检查 notebook 另需 nbformat matplotlib-inline。安装命令:
python -m pip install numpy matplotlib torch ipython nbformat matplotlib-inline
保存图与文末记录来自此前 Python 3.12 / PyTorch 2.14.0+cpu 的本地执行。你自己的运行环境版本由下一代码块打印;本次整理未重跑这些训练。图轴使用英文,正文提供中文读图说明。缺依赖时再安装,已有环境不必重复安装;课堂按开头任务入口运行,不必 Run all。
本材料改编自 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola 的 Dive into Deep Learning。D2L 正文 CC BY-SA 4.0,示例代码 modified MIT,许可随完整包 licenses/ 保存。我们补充多通道梯度、采样反例、受控实验、真实 PyTorch 状态语义;不要把教学小实现视为框架底层实现。
查看代码 · 单元 8
from pathlib import Path
import copy, hashlib, inspect, json, math, platform, time
import numpy as np
import matplotlib.pyplot as plt
import torch
from torch import nn
from torch.nn import functional as F
from IPython.display import display, Markdown

torch.manual_seed(20260921)
torch.set_num_threads(2)
torch.use_deterministic_algorithms(True)
OUT=Path('results'); OUT.mkdir(exist_ok=True)
FIG=Path('figures'); FIG.mkdir(exist_ok=True)
BLUE,GOLD,TEAL,RED='#002676','#FDB515','#00897B','#B83A3A'
plt.rcParams.update({'font.size':11,'axes.spines.top':False,'axes.spines.right':False,
                     'figure.dpi':110,'savefig.facecolor':'white'})
def savefig(fig,name):
    fig.savefig(FIG/f'{name}.png',dpi=160,bbox_inches='tight')
    fig.savefig(FIG/f'{name}.svg',bbox_inches='tight')
def table(headers,rows):
    display(Markdown('| '+' | '.join(headers)+' |\n| '+ ' | '.join(['---']*len(headers))+' |\n'+
                     '\n'.join('| '+' | '.join(map(str,row))+' |' for row in rows)))
print('PyTorch',torch.__version__,'/ Python',platform.python_version(),'/ device CPU')
1. 一个输出:先算 19,再追踪共享
深度学习的 Conv2d 默认实现互相关,不翻转 kernel。以下四个输出用了同一组参数;这不是四个独立的神经元权重副本。
左上角是 $0\times0+1\times1+3\times2+4\times3=19$。核翻转会改变固定权重的输出;对可学习模型,卷积与互相关可通过权重重参数化对应,不能把固定核的差异也说成不存在。
查看代码 · 单元 11
from numpy.lib.stride_tricks import sliding_window_view
image=np.arange(9,dtype=np.float64).reshape(3,3)
kernel=np.array([[0.,1.],[2.,3.]])
patches=sliding_window_view(image,kernel.shape)
response=np.einsum('ijab,ab->ij',patches,kernel)
assert np.array_equal(response,[[19.,25.],[37.,43.]])
fig,axes=plt.subplots(1,3,figsize=(9,2.7))
for ax,a,title in zip(axes,[image,kernel,response],['Input','One shared kernel','Response']):
    ax.imshow(a,cmap='Blues')
    for (i,j),v in np.ndenumerate(a):
        ax.text(j,i,f'{v:g}',ha='center',va='center',color='white' if v>a.max()*.6 else BLUE)
    ax.set(title=title,xticks=[],yticks=[])
savefig(fig,'lab01-shared-correlation');plt.show()
print(response)
保存结果|四个窗口,同一个核
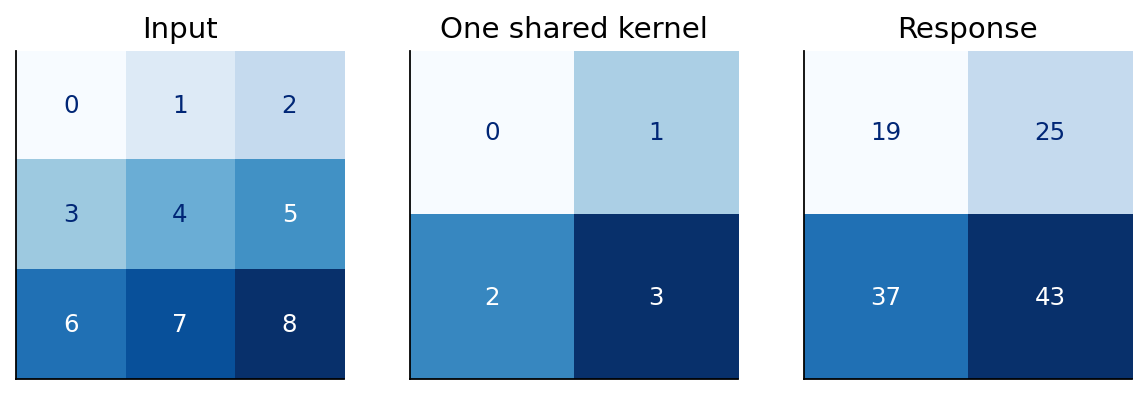
先用左上窗口算出19,再在图上找到产生25的窗口:变的是输入片段,核没有变。要检验这件事,改一个输入元素前先圈出所有覆盖它的窗口,预测哪些输出会改变。
2. 多通道:对输入通道求和,对输出通道堆叠
\[ Y_{n,o,i,j}=b_o+\sum_{c,a,b}K_{o,c,a,b}X_{n,c,i+a,j+b}. \]
每个输出通道有一组覆盖所有输入通道的核。输入 RGB 三通道不意味着输出也必须为三通道。以下 NumPy 实现保留所有轴,与 PyTorch F.conv2d 对照。
Conv2d(3,16,3) 的权重 shape 是 (16,3,3,3);加 16 个 bias 共 448 参数。改变输入空间分辨率不会改变这 448 个参数,却会改变计算和中间激活内存。
查看代码 · 单元 15
rng=np.random.default_rng(20260921)
X=rng.normal(size=(2,3,6,7));K=rng.normal(size=(4,3,3,2));b=rng.normal(size=4)
P=sliding_window_view(X,(3,2),axis=(-2,-1))
Y_numpy=np.einsum('ncijab,ocab->noij',P,K)+b[None,:,None,None]
Y_torch=F.conv2d(torch.from_numpy(X),torch.from_numpy(K),torch.from_numpy(b))
np.testing.assert_allclose(Y_numpy,Y_torch.numpy(),rtol=1e-12,atol=1e-12)
conv=nn.Conv2d(3,16,3,padding=1)
assert sum(p.numel() for p in conv.parameters())==448
print('NumPy vs PyTorch max error:',np.abs(Y_numpy-Y_torch.numpy()).max())
print('weight:',tuple(conv.weight.shape),'bias:',tuple(conv.bias.shape),'total parameters:',448)
print('32x32 output:',tuple(conv(torch.zeros(1,3,32,32)).shape))
print('64x64 output:',tuple(conv(torch.zeros(1,3,64,64)).shape))
3. 共享权重的梯度:每个位置贡献,再加到一起
设 $\delta=\partial L/\partial Y$,对 valid、stride 1 的卷积有 \[ \frac{\partial L}{\partial K_{o,c,a,b}} =\sum_{n,i,j}\delta_{n,o,i,j}X_{n,c,i+a,j+b}. \]
我们用 $L=\sum Y\delta$ 固定上游梯度,隔离本层链式法则。先构造每个位置对同一个权重的贡献热图,再验证完整多通道梯度。loss 采用 mean 或 sum 时,上游 $\delta$ 的尺度也会变;这不是梯度公式矛盾。
共享使不同位置对同一探测规则积累证据,但相邻 patches 高度相关,不能直接称为 $H\times W$ 个独立训练样本。
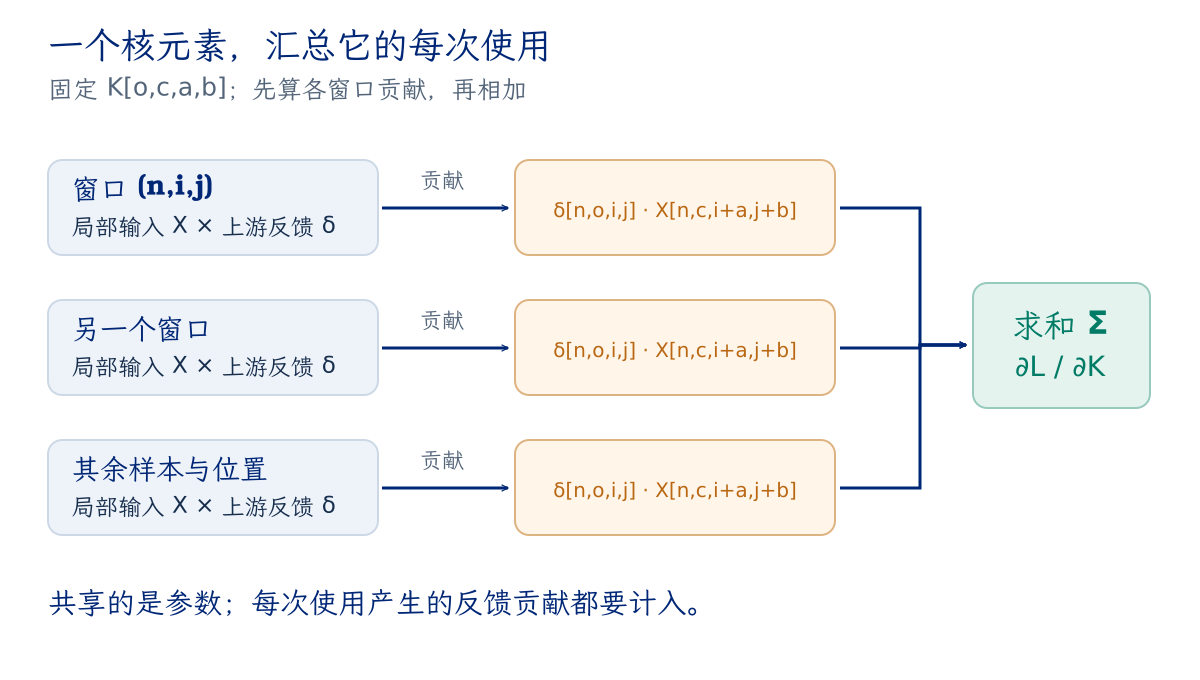
先沿一条支路读。 固定同一个 K[o,c,a,b],每个窗口贡献的是 δ[n,o,i,j] × X[n,c,i+a,j+b],最后对样本和位置求和。这里没有对固定的输出通道 o 再求和。
预测再核对: 若把代码中的 delta 整体乘2,核梯度应怎样变?保留输入与权重、只改这一项并重跑第3节;图上的每个贡献与总和应同比变化。第4节依赖这里的 x,w,y,delta,不能直接跳跑。
查看代码 · 单元 18
torch.manual_seed(20260921)
x=torch.randn(2,2,5,6,dtype=torch.float64)
w=torch.randn(3,2,3,2,dtype=torch.float64,requires_grad=True)
y=F.conv2d(x,w);delta=torch.randn_like(y)
(y*delta).sum().backward()
manual=torch.zeros_like(w)
for n in range(x.shape[0]):
    for o in range(w.shape[0]):
        for c in range(w.shape[1]):
            for a in range(w.shape[2]):
                for b_ in range(w.shape[3]):
                    manual[o,c,a,b_] += (delta[n,o]*x[n,c,a:a+y.shape[2],b_:b_+y.shape[3]]).sum()
torch.testing.assert_close(manual,w.grad)
contributions=delta[:,0]*x[:,0,:y.shape[2],:y.shape[3]]
fig,axes=plt.subplots(1,2,figsize=(9,3.4),layout='constrained')
limit=float(contributions.abs().max())
for n,ax in enumerate(axes):
    im=ax.imshow(contributions[n],cmap='RdBu_r',vmin=-limit,vmax=limit)
    ax.set(title=f'Sample {n}',xlabel='Output column',ylabel='Output row')
fig.suptitle('Per-position contributions to the shared weight K[0,0,0,0]')
fig.colorbar(im,ax=axes,shrink=.8);savefig(fig,'lab01-gradient-contributions');plt.show()
print('Sum over samples and positions:',float(contributions.sum()))
print('Autograd weight gradient:',float(w.grad[0,0,0,0]))
gradient_error=float((manual-w.grad).abs().max())
print('Full gradient maximum difference:',gradient_error)
保存结果|先看局部贡献,再看总和
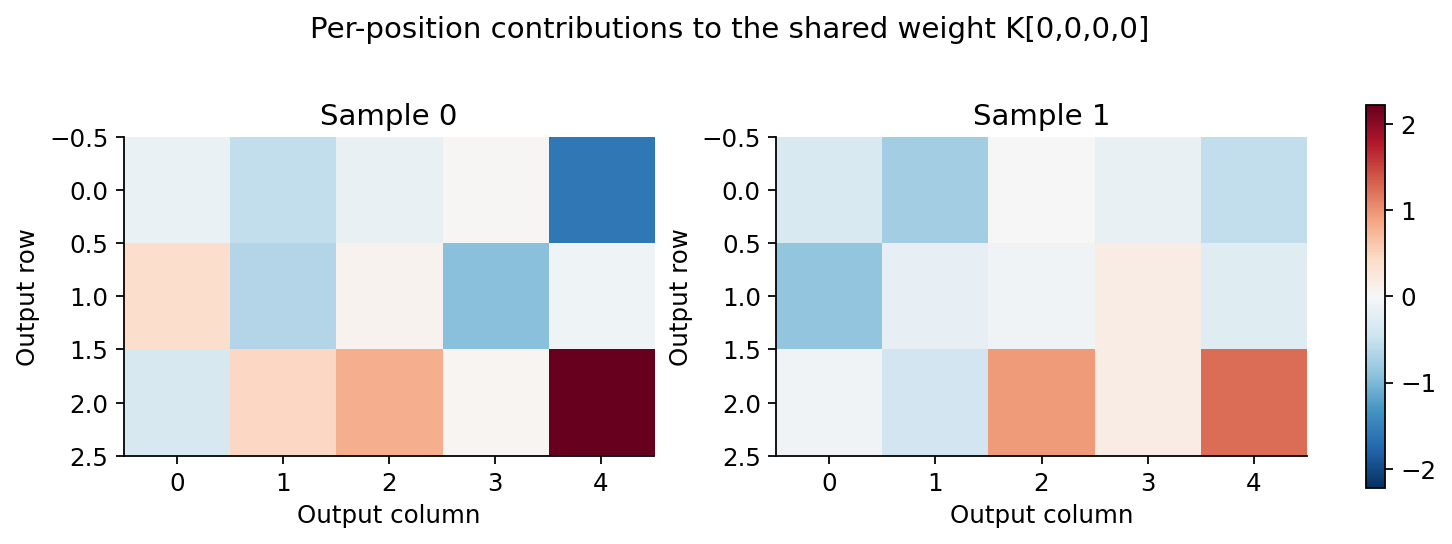
两图使用同一对称色标;正负贡献可能抵消。先判断哪一块贡献的符号与相邻位置不同,再核对代码打印的 Sum over samples and positions 与 Autograd weight gradient。一张热图的峰值不是最终参数更新量。
4. 深入:滑窗也可以变成矩阵乘法
unfold 把每个局部窗口摊成一个列向量。空间扫描转换为许多列、所有 filter 转换为矩阵的行,前向就是一次矩阵乘法。这是「卷积与线性代数」的桥,不是声明底层 backend 一定显式构造这个大矩阵。显式 unfold 会复制重叠窗口,可能增加内存。
查看代码 · 单元 22
columns=F.unfold(x,kernel_size=(3,2))
Y_matrix=(w.detach().reshape(3,-1)@columns).reshape_as(y)
torch.testing.assert_close(Y_matrix,y)
matrix_gradient=torch.einsum('nol,nkl->ok',delta.flatten(2),columns).reshape_as(w)
torch.testing.assert_close(matrix_gradient,w.grad)
print('Input:',tuple(x.shape),'unfold:',tuple(columns.shape),'kernel matrix:',tuple(w.reshape(3,-1).shape))
print('Input entries:',x.numel(),'unfold entries:',columns.numel())
5. 深入:从例子学习核,更新的仍是同一个参数
给随机输入配上 [1,-1] 的目标响应,用均方误差学习两个参数。已知算子恢复让我们能知道正确答案;真实分类只提供最终类别,不规定某一层必须成为边缘核。
更新放在 torch.no_grad() 中避免记录参数更新的计算图。它与 model.eval() 是不同操作;LAB 03 将用 BatchNorm 验证。
查看代码 · 单元 25
torch.manual_seed(20260921)
inputs=torch.randn(32,1,8,8)
targets=F.conv2d(inputs,torch.tensor([[[[1.,-1.]]]]))
learner=nn.Conv2d(1,1,(1,2),bias=False)
losses=[]
for step in range(60):
    learner.zero_grad(set_to_none=True)
    loss=F.mse_loss(learner(inputs),targets);loss.backward()
    with torch.no_grad(): learner.weight-=.15*learner.weight.grad
    losses.append(float(loss.detach()))
print('Learned kernel:',learner.weight.detach().flatten().tolist())
assert torch.max(torch.abs(learner.weight.detach().flatten()-torch.tensor([1.,-1.])))<1e-5
fig,ax=plt.subplots(figsize=(6,3));ax.semilogy(losses,color=BLUE)
ax.set(xlabel='Update',ylabel='MSE',title='Recover a known operator');savefig(fig,'lab01-learned-kernel');plt.show()
保存结果|学回一个已知算子
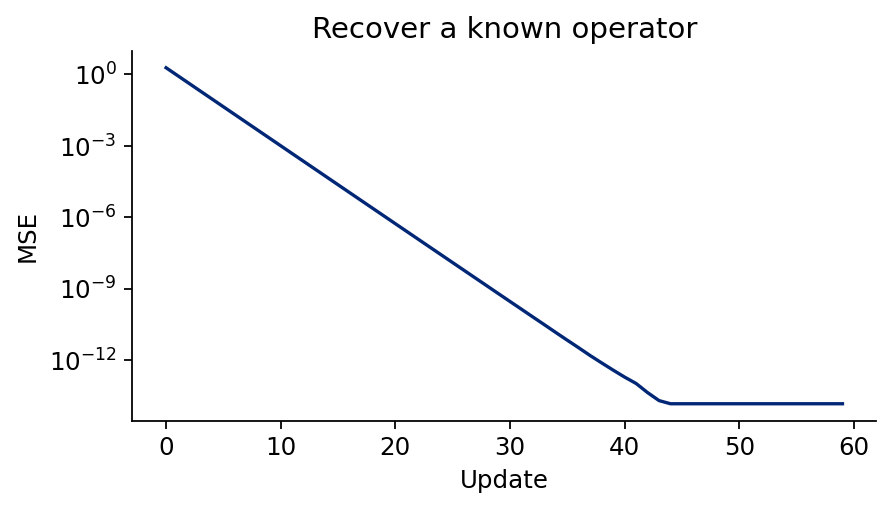
纵轴是对数 MSE,曲线记录60次参数更新。先看误差的量级变化,再核对最终两个核值是否接近 [1,-1]。目标响应是我们事先用已知核构造的;这个实验不表示真实分类网络必须学成某个指定边缘核。课堂无需为读此图重跑这段训练。
6. 平移、边界与 stride:检验先验的准确边界
尺寸公式中的 $p$ 是每侧 padding: \[ H_{out}=\left\lfloor\frac{H+2p-d(k-1)-1}{s}\right\rfloor+1. \]
不能整除也可以运行,框架向下取整。用 circular padding 把边界也变成周期结构,stride 1 应满足 f(roll(x,1)) = roll(f(x),1)。stride 2 后,输入移动 2 像素对应输出移动 1 格;输入移动 1 像素改变采样相位,没有整数输出平移与之对应。
下面零填充反例使用非对称核,让边界差异可被观察。平移等变是表示跟着移动,分类不变是输出保持相同,不能互换。
查看代码 · 单元 29
H,p,d,k,s=8,1,1,3,3
expected=(H+2*p-d*(k-1)-1)//s+1
actual=F.conv2d(torch.randn(1,1,H,H),torch.ones(1,1,k,k),stride=s,padding=p).shape[-1]
assert expected==actual==3
torch.manual_seed(20260921)
z=torch.randn(1,1,8,8);weight=torch.randn(1,1,3,3)
def circular(z,s=1): return F.conv2d(F.pad(z,(1,1,1,1),mode='circular'),weight,stride=s)
errors={
 'periodic stride1 / input shift1 / output shift1':float((circular(z.roll(1,-1))-circular(z).roll(1,-1)).abs().max()),
 'periodic stride2 / input shift2 / output shift1':float((circular(z.roll(2,-1),2)-circular(z,2).roll(1,-1)).abs().max()),
 'periodic stride2 / input shift1 / output shift1':float((circular(z.roll(1,-1),2)-circular(z,2).roll(1,-1)).abs().max()),
 'zero pad stride1 / circular input shift1':float((F.conv2d(z.roll(1,-1),weight,padding=1)-F.conv2d(z,weight,padding=1).roll(1,-1)).abs().max()),
}
assert list(errors.values())[0]<1e-10 and list(errors.values())[1]<1e-10
table(['Condition','Maximum absolute difference'],[[k,f'{v:.6g}'] for k,v in errors.items()])
7. 读真实 PyTorch 源码:Module → functional → backend
下面的文本来自当前运行环境的 inspect,不是我们伪写的框架源码。Conv2d 保存参数、stride、padding、groups 等配置;forward 转交 _conv_forward。非零 padding 模式先 F.pad;数值运算转交 F.conv2d,其后的 CPU/CUDA kernel 不在这段 Python wrapper 中。
读源码时应把两种问题分开:数学如何定义,模块如何管理状态并调用 backend。
查看代码 · 单元 32
source_record={'torch':torch.__version__,'git_version':torch.version.git_version,
               'file':inspect.getsourcefile(nn.Conv2d)}
print(json.dumps(source_record,indent=2))
print(inspect.getsource(nn.Conv2d.forward))
print(inspect.getsource(nn.Conv2d._conv_forward))
summary={'hand_output':response.tolist(),'rgb_conv_parameters':448,'shared_gradient_max_error':gradient_error,
         'equivariance_errors':errors,'learned_kernel':learner.weight.detach().flatten().tolist(),
         'source':source_record,'execution':'local CPU; complete notebook'}
(OUT/'lab01-results.json').write_text(json.dumps(summary,indent=2))
带走的问题
- 如果每个位置拥有独立 kernel,哪些梯度还会相加,哪些不再相加?
- 为什么减小参数量不等价于保证更好的泛化?为自己的研究数据举一个位置相关的反例。
- 输入分辨率加倍时,参数、MAC 和激活内存各如何变化?哪些结论依赖 stride 和通道数不变?
可以让 AI 修改实现,但先写下你预计变的量与应保持不变的量,再用数值对照检验。
既有实验的执行记录(沿用)
以下为既有本地执行记录,重组时沿用来源与原数值;本轮未重跑这一源实验。
本地 CPU / PyTorch 2.14.0+cpu,所有单元按顺序执行。
| 检查 | 实测 |
|---|---|
| 手算输出 | [[19,25],[37,43]] |
| 3→16、3×3、带bias参数 | 448 |
| 手算共享梯度与autograd最大差 | 1.78e-15 |
恢复目标 [1,-1] 的核 |
[0.9999999403953552, -0.9999999403953552] |
周期边界下,stride=1配输入/输出各移1格误差为0;stride=2配输入移2格/输出移1格也为0。stride=2配输入移1格时误差为7.4331,给出不兼容采样相位的具体反例;随机输入下的误差数值不是普遍常数。
协议与来源沿革
历次备课记录与原数值表保留在。本实验使用前文明确的当前协议与模型身份;历史数值不与新运行合并。
返回 CLS 00 · 第二讲导读
历史实验再读 1 · 从循环到 Parameter:同一个核怎样进入自动微分?
先预测。 前文已用 NumPy 向量化核对多通道卷积,也算过共享梯度。本节补上中间一层:把旧课的显式双循环真正包进 nn.Module,让 nn.Parameter 管理同一份权重。输入通道应该 sum,输出通道应该 stack;如果把二者交换,会错在数值还是形状?先写下 (C_in,H,W)=(2,4,5)、(C_out,C_in,k_h,k_w)=(3,2,2,2) 的输出形状。
修改参数再运行。 先执行默认值,再把开头四项改为 C_IN=3, C_OUT=1, KH=1, KW=3。观察输入通道贡献、完整输出、注册的参数名,以及显式循环与 F.conv2d 的前向/梯度误差。代码只做一次求导,不做参数更新,不依赖前文变量。
历史来源与改写。 Spring26 Lecture3-1_convnet,project 03ca31da-8b5e-4562-82d0-0898f6eb7b7a,notebook 3560ca0d49804f409f2db00795b76ae5;Fall25 同源 Lecture4-5_convnet,project f60a1775-066c-48b1-a0c1-181c392044b6,notebook b8161140028a4cf1aa9ec9f78da119d0。保留旧课/D2L 的 corr2d 双循环、Parameter、通道 sum/stack 思路;本次补 dtype/device 一致的分配、输入通道检查,以及共享同值参数的框架和梯度核对。范围限于单样本、valid、stride 1、groups 1。
查看代码 · 单元 42
import torch
from torch import nn
from torch.nn import functional as F

torch.set_num_threads(2)
C_IN, C_OUT, KH, KW = 2, 3, 2, 2  # 再试:3, 1, 1, 3
assert 1 <= C_IN <= 4 and 1 <= C_OUT <= 4
assert 1 <= KH <= 4 and 1 <= KW <= 5

def corr2d_loop(x, kernel):
    kh, kw = kernel.shape
    h, w = x.shape[0] - kh + 1, x.shape[1] - kw + 1
    result = x.new_zeros((h, w))
    for i in range(h):
        for j in range(w):
            result[i, j] = (x[i:i+kh, j:j+kw] * kernel).sum()
    return result

def multi_in(x, kernels):
    assert x.shape[0] == kernels.shape[0]  # 防止 zip 静默截断通道
    return sum(corr2d_loop(xc, kc) for xc, kc in zip(x, kernels))

class LoopConv2d(nn.Module):
    def __init__(self, cin, cout, kh, kw):
        super().__init__()
        values = torch.arange(cout*cin*kh*kw, dtype=torch.float64)
        self.weight = nn.Parameter(values.reshape(cout, cin, kh, kw) / 20)
        self.bias = nn.Parameter(torch.linspace(-0.2, 0.2, cout, dtype=torch.float64))
    def forward(self, x):
        return torch.stack([multi_in(x, k) for k in self.weight]) + self.bias[:, None, None]

x = torch.arange(C_IN*4*5, dtype=torch.float64).reshape(C_IN, 4, 5) / 10
layer = LoopConv2d(C_IN, C_OUT, KH, KW)
y = layer(x)
ref_weight = layer.weight.detach().clone().requires_grad_()
ref_bias = layer.bias.detach().clone().requires_grad_()
y_ref = F.conv2d(x[None], ref_weight, ref_bias)[0]
torch.testing.assert_close(y, y_ref)
upstream = torch.linspace(-1, 1, y.numel(), dtype=x.dtype).reshape_as(y)
(y * upstream).sum().backward()
(y_ref * upstream).sum().backward()
torch.testing.assert_close(layer.weight.grad, ref_weight.grad)
torch.testing.assert_close(layer.bias.grad, ref_bias.grad)
parts = torch.stack([corr2d_loop(xc, kc.detach()) for xc, kc in zip(x, layer.weight[0])])
print('Input:', tuple(x.shape), 'Weight:', tuple(layer.weight.shape), 'Output:', tuple(y.shape))
print('Registered parameters:', [(name, tuple(p.shape)) for name, p in layer.named_parameters()])
print('For output[0,0,0], one contribution per input channel:', parts[:, 0, 0].tolist())
print('Their sum + bias:', float(parts[:, 0, 0].sum() + layer.bias[0].detach()))
print('Full output:\n', y.detach())
HISTORY_RESULT = {
    'output_shape': list(y.shape),
    'parameters': sum(p.numel() for p in layer.parameters()),
    'forward_max_error': float((y.detach()-y_ref.detach()).abs().max()),
    'weight_grad_max_error': float((layer.weight.grad-ref_weight.grad).abs().max()),
    'bias_grad_max_error': float((layer.bias.grad-ref_bias.grad).abs().max()),
}
print('Checks:', HISTORY_RESULT)
核对与解释。 默认输出是 (3,3,4),参数是 24 个核权重加 3 个偏置。sum 消去输入通道轴,stack 建立输出通道轴;它们承担不同操作。默认和建议的替代设置下,三项误差都应只有浮点舍入量。nn.Parameter 的作用是注册参数;能求导来自前向操作仍保留计算图。参数登记、梯度计算、优化器更新是三件事。
边界与追问。 这不是 PyTorch 的底层高性能实现,也没有证明一次正确梯度会降低任意损失。把 zip 的通道检查删掉再给错通道数,为什么可能得到“能运行但少算”的结果?把前向中的权重 .detach() 后,哪一项核对会失败?请先预测,再在副本中试验。
历史实验再读 2 · 输出都拟合对了,卷积核就一定被唯一找到了吗?
先预测。 前文用随机输入恢复 [1,-1];旧课也有从目标响应学习边缘核。现在去掉训练,仅检查信息是否足够:如果观察到的输入全是常数图,[1,-1] 与 [2,-2] 能否被输出区分?在没有独立输入的情况下,“输出误差为零”能否证明找回了唯一真实核?
修改参数再运行。 DELTA 改变候选核的差异,BRIGHTNESS 改变常数图的亮度。默认后再试 DELTA=2.5, BRIGHTNESS=3.0。代码显示两个输入、两组响应、窗口设计矩阵的秩。所有数据是明确构造的小张量,无训练、无数据下载。
历史来源与改写。 承接 Spring26 project 03ca31da-8b5e-4562-82d0-0898f6eb7b7a / notebook 3560ca0d49804f409f2db00795b76ae5(Lecture3-1_convnet)以及 Fall25 project f60a1775-066c-48b1-a0c1-181c392044b6 / notebook b8161140028a4cf1aa9ec9f78da119d0 的“学习卷积核”。本段是针对核恢复结论新写的不可辨识反例;不复用旧课训练日志,不把构造输出称为历史训练结果。
查看代码 · 单元 46
import torch
from torch.nn import functional as F

torch.set_num_threads(2)
DELTA, BRIGHTNESS = 1.0, 1.0  # 再试:2.5, 3.0
assert BRIGHTNESS != 0 and abs(DELTA) <= 100
constant = torch.full((1, 1, 2, 5), BRIGHTNESS, dtype=torch.float64)
probe = torch.tensor([[[[0., 1., 0., 1., 0.], [1., 0., 1., 0., 1.]]]], dtype=torch.float64)
k1 = torch.tensor([[[[1., -1.]]]], dtype=torch.float64)
k2 = k1 + DELTA * torch.tensor([[[[1., -1.]]]], dtype=torch.float64)
y1, y2 = F.conv2d(constant, k1), F.conv2d(constant, k2)
p1, p2 = F.conv2d(probe, k1), F.conv2d(probe, k2)
A_constant = F.unfold(constant, (1, 2))[0].T
A_probe = F.unfold(probe, (1, 2))[0].T
null_direction = torch.tensor([1., -1.], dtype=torch.float64)
torch.testing.assert_close(y1, y2)
torch.testing.assert_close(A_constant @ null_direction, torch.zeros(A_constant.shape[0], dtype=torch.float64))
rank_constant = int(torch.linalg.matrix_rank(A_constant))
rank_combined = int(torch.linalg.matrix_rank(torch.cat([A_constant, A_probe])))
assert rank_constant == 1 and rank_combined == 2
if DELTA != 0:
    assert not torch.allclose(p1, p2)
print('K1:', k1.flatten().tolist(), 'K2:', k2.flatten().tolist())
for name, inp, a, b in [('Constant observations', constant, y1, y2), ('New alternating probe', probe, p1, p2)]:
    print('\n' + name, '\ninput:\n', inp[0, 0])
    print('K1 response:\n', a[0, 0], '\nK2 response:\n', b[0, 0])
HISTORY_RESULT = {
    'constant_response_max_gap': float((y1-y2).abs().max()),
    'probe_response_max_gap': float((p1-p2).abs().max()),
    'constant_design_rank': rank_constant,
    'combined_design_rank': rank_combined,
    'unknown_kernel_values': k1.numel(),
}
print('\nChecks:', HISTORY_RESULT)
核对与解释。 默认常数图的两组输出都为 0;新探针的响应最大差为 1。原窗口只有一种方向 [b,b],只能约束两个核值的和;沿 [1,-1] 改变核,原观察完全不变。加入非恒定探针后,此例的设计矩阵才达到秩 2。
边界与讨论。 这是无偏置、线性、无噪声的两参数问题。满列秩能保证这个线性参数问题的唯一性;它不保证有噪声时估计稳定,更不保证深层分类网络的参数唯一。把 DELTA=0 设为对照:两组核相同,新探针也不应制造差异。解释“恢复目标算子”时,应说明输入提供了哪些约束,而非只报告训练误差。