本册承接第二讲 C 段:能写出更深的网络,为什么还不等于训练得好?先区分表达、优化和泛化,再看恒等旁路如何改变参数化,并用同深度比较判断证据。
课堂后先读:第 4 节找训练退化现象,第 5 节沿残差的两条路径手算,第 6 节读 ImageNet 配对验证表。第 1–3 节补齐 LeNet、系统规模和 AlexNet 的历史条件;末尾短代码核对残差数值与百分点差。
结构练习:进入 LAB 03 · 架构实验室,找分支/残差相关小节。先检查相加接口,再提出一个只改变连接方式的比较;写清实际运行了什么,不能用机制算例替代模型训练结果。
1. 卷积已经能学,新的困难为什么出现?
课件与图解:LeNet说明:端到端卷积学习早已存在 · 可以写出更深网络,不代表它容易训练
LeNet 已把局部共享、下采样与监督训练用于字符识别,因此 2012 年的转折不是第一次发明卷积或端到端学习。自然图像有更多类别、尺度、视角、背景和更大数据规模,需要把这条路线扩大。
更多层可能组合出更复杂的表示,但能写出函数,不等于从随机起点就容易训练出有用参数。反馈沿多层局部导数传播,初始化、激活尺度与结构都会影响有效调整。观察到深层网络表现不好时,要先分开“函数族能否表达”“训练是否找到好参数”“新样本是否泛化”,不能仅用层数替代诊断。
先预测与核对:分别给“可以表示某个解”和“这次训练找到这个解”写一句需要的证据。下一节先固定端到端监督目标,分清表达能力、优化与泛化;随后看扩大数据和计算怎样支持这条训练链。
2. 能写出计算图,还要检查训练能否找到解
增加深度先扩大了可表达的函数关系,但不保证同一个优化流程能找到已有的好解。如果浅网络已能实现某个映射,给更深网络加恒等层可以保留该映射;现实训练是否找到这样的参数,要用训练曲线检查,不能只凭包含关系证明。
面对性能下降,分三步判断:模型类是否含有需要的函数;当前训练是否拟合好训练集;拟合的函数是否在留出样本泛化。后面的 ResNet 证据将分别使用训练退化观察和同深度验证比较。
2006 年 DBN 的逐层生成学习完整解释已归 历史参考;它与这里的监督分类目标不同,不作为继续学习残差的前置。
3. AlexNet:系统条件与结果必须一起读
课件与图解:AlexNet把数据、算力与训练方法组织成一个可扩展系统 · 2012年的结果显示了路线转折,也要保留比较口径
AlexNet 把大量类别标注、GPU 张量计算、非线性、增强、正则与优化组织在一起,使更大规模的监督表示学习可行。把结果只归因于“层数增加”会遗漏这些同时存在的条件;系统成功也不是对单一因素的独立消融。
主讲沿原论文 Table 2 使用同年 2012 竞赛分类任务的 test top-5 错误率,保留一位小数:
| 比较对象 | test top-5 error | 必须保留的口径 |
|---|---|---|
| 最佳非 CNN 系统 | 约 26.2% | 同年任务参照 |
| 仅比赛训练数据的 CNN 集成 | 约 16.4% | 集成,不是单个网络 |
| 含额外 ImageNet 监督预训练的集成 | 约 15.3% | 训练数据条件不同 |
top-5 错误判断真实类别是否未进入前五个预测,不能写成 top-1 准确率。16.4% 与 15.3% 不是“同一个单网络又多训练一点”的直接对照,后者还涉及额外数据;这里按表中显示精度保留一位小数。
先预测与核对:为每个百分比补上数据、模型数量与指标三个标签,再说一句这张表不能隔离的因素。规模化路线取得进展以后,新的问题出现:更深的普通网络是否至少能把训练集拟合得更好?
4. 训练本身退化,为什么不能只说过拟合?
课件与图解:更深的普通网络,为什么连训练误差也更高? · 存在一个好解,不等于训练过程容易找到它
先只看左图。 同一 CIFAR-10 任务中,56 层普通网络的训练误差比 20 层更高。这还能只解释成“训练集拟合太好”吗?
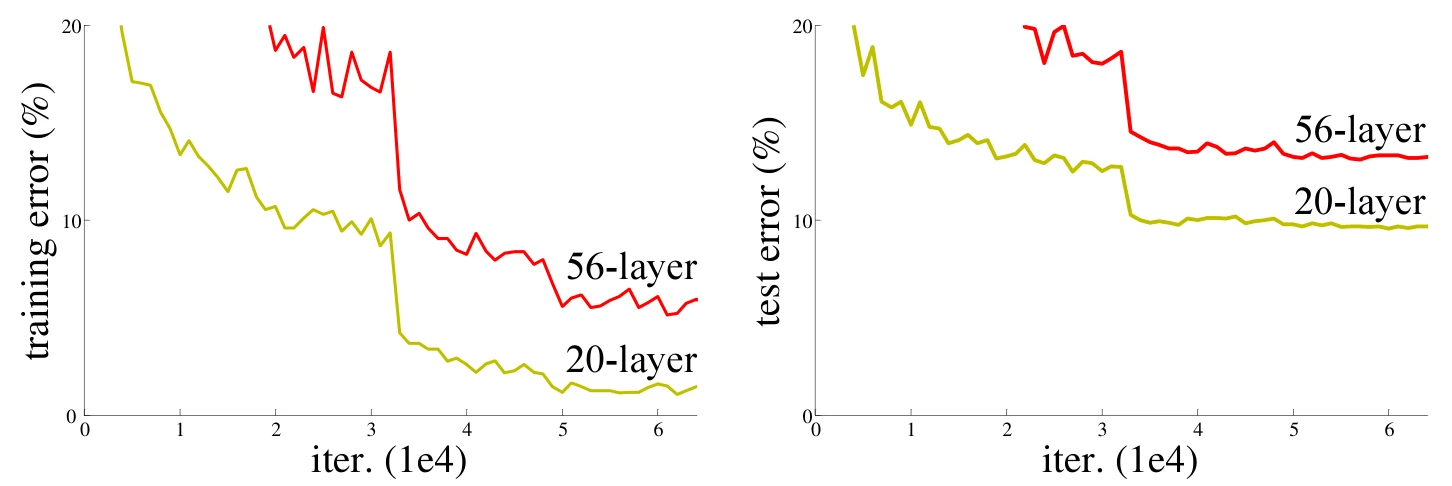
复用 Slides 已保存的 ResNet 原论文 Figure 1。左侧为训练误差,右侧为测试误差;横轴迭代单位为 10⁴。这里展示原图,未生成或重跑曲线。
先排除一个不完整解释。 56 层连训练集本身也拟合得更差,因此仅说“过拟合”不够。这指向优化困难,但也不能凭这一张图断言原因就是梯度消失;原研究已使用归一化等措施,并讨论了这个简单解释的不足。
再提出一个可以构造的问题。 若新增层能保持输入表示,较深模型原则上就能包含浅层模型的行为:浅层做原来的事,新增部分先什么也不改。可是存在这个候选解,不代表随机起点和训练容易找到它。
于是设计问题变得具体:能否让“先保留已有表示”对应一组更直接的参数选择,让新增部分只学习需要改变的内容?
先预测与核对:各用一句话区分“更深模型能表达好解”和“这次训练找到好解”。图上哪条曲线说明后者遇到了困难?下一节直接写出保持路径。
5. 先保留、再修正;反馈也逐路径相加
课件与图解:先保留已有表示,再学习需要改变的部分 · 残差相加以后,反馈也有一条直接路径
先读结构,再代入数值。 保持路径把 h 送到相加处,分支给出修正 F(h)。不要把 F(h) 当成另一个完整输出 y。
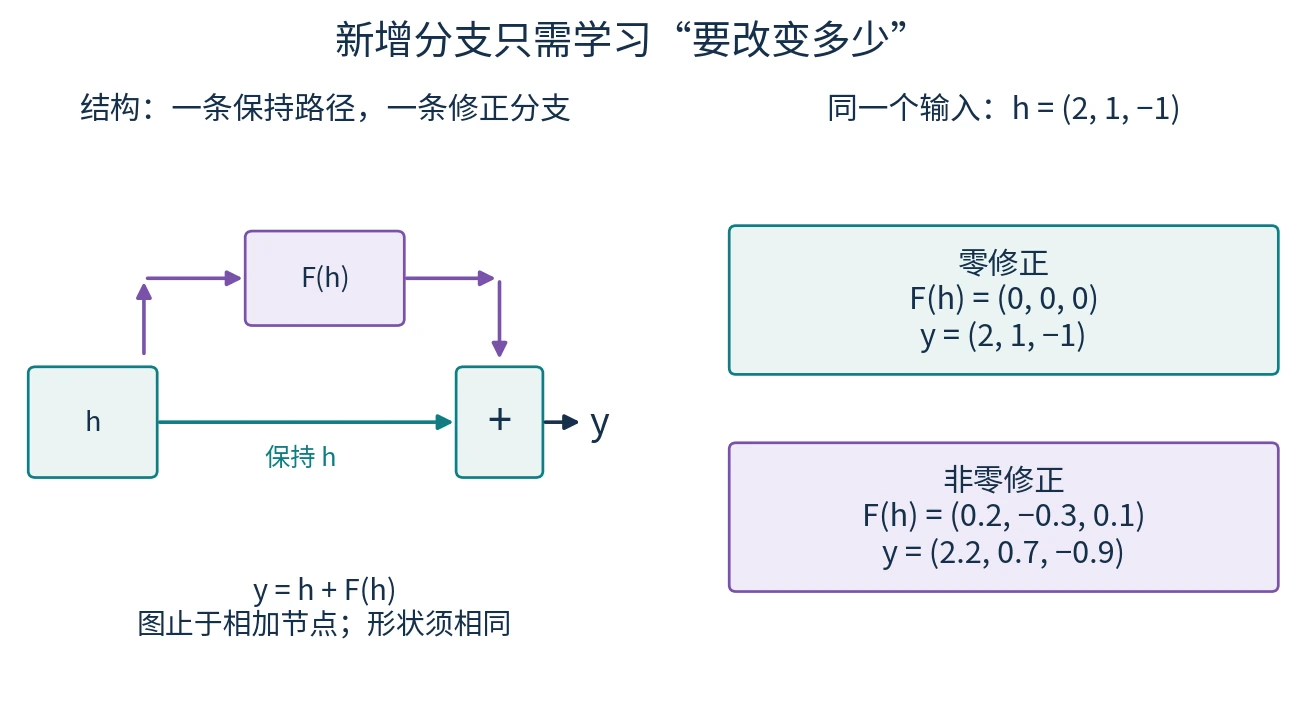
这里两路形状相同,且停在相加节点,没有相加后激活。因此 F(h)=0 会严格保留 h;修正为 (0.2,−0.3,0.1) 时,逐项得到 (2.2,0.7,−0.9)。修正可以正也可以负,也不要求永远很小。形状不同需先匹配。
沿同一结构反向走一次。 为方便手算,换成标量 x=2、F(x)=0.2x,输出 y=2.4。若上游 ∂L/∂y=1:
| 路径 | 局部导数 | 给 x 的反馈 |
|---|---|---|
| 直达 x | 1 | 1 |
| 分支 F(x)=0.2x | 0.2 | 0.2 |
| 汇总 | 1+0.2 | 1.2 |
这仍是上一册的原则:每条路径先算贡献,再相加。它不是梯度永不消失的保证——若 F(x)=−x,总反馈为 1−1=0;若相加后接 ReLU,还需乘该点的 ReLU 导数。向量例中的 −1 在相加后 ReLU 下也会被截断。
先预测与核对:遮住图右侧输出,先算零修正与非零修正,再算两种标量分支的总反馈。局部机制给出了预期;要判断连接方案是否帮助实际训练,还得读同深度、同协议的结果。
6. 同深度配对,验证表不能冒充训练曲线
课件与图解:连接改了,怎样检验它是否有用?
先固定数据与评价协议,再横向比较同深度 plain 与 residual。以下是 ResNet 原论文 Table 2:ImageNet validation top-1 error,10-crop,越低越好。
| 深度 | plain | residual | 错误率减少(百分点) |
|---|---|---|---|
| 18 层 | 27.94% | 27.88% | 0.06 |
| 34 层 | 28.54% | 25.03% | 3.51 |
先遮住最后一列,用同一行的两个数相减。34 层的差是 3.51 个百分点,不是相对减少 3.51%;它支持这套设置中残差连接相对 plain 的验证表现改善。表中 18 层差别小,提醒我们结构效果要结合具体设置读取。
这张表回答不了什么? 它没有给出训练拟合降低了多少。前节 CIFAR-10 Figure 1 的 20/56 层训练退化,与这里 ImageNet 18/34 层验证比较不是同一组实验轨迹。若要继续追问优化过程,应另读原论文 ImageNet Figure 4 或 CIFAR-10 Figure 6 的训练/测试曲线;跨深度也不能宣称计算量相同。
把证据写成一句话:在 ImageNet、10-crop 评价下,同为 34 层,改变连接方式后验证错误率从 28.54% 降到 25.03%;解释训练机制还需要训练行为的证据。然后改写一次:只看 18 层行时,你的结论力度应怎样变化?
下一步在 DenseNet 对比页 比较相加与拼接:前者合并同形数值,后者保留来源的通道组,也带来通道增长与激活存储。
把本段主线连起来
本册的连续问题是:端到端监督卷积学习怎样扩大?增加深度为何会连训练拟合都变差?恒等路径怎样改变参数化?同深度配对是否支持连接方案?旧表示相加与通道拼接怎样改变访问和存储?
AlexNet 的 test top-5、ResNet 的训练观察与 validation top-1 各自标明数据和协议。构造残差向量与两路导数仅验证局部计算。DBN 的生成目标在历史参考独立保存,不混作监督 CNN 的训练步骤。
课堂核对:先预测,再运行
课件与图解:先保留已有表示,再学习需要改变的部分 · 残差相加以后,反馈也有一条直接路径 · 连接改了,怎样检验它是否有用?
以下核对只用标准库。先算向量修正与两条反馈,再读取明确标注的文献验证数值,计算百分点差。代码不会训练 ImageNet 模型,表中数字是原论文报告值,不是此代码测出的性能。
查看代码 · 单元 19
from math import isclose

h = (2.0, 1.0, -1.0)
zero = (0.0, 0.0, 0.0)
correction = (0.2, -0.3, 0.1)
add = lambda a, b: tuple(x+y for x, y in zip(a, b))
assert add(h, zero) == h
assert all(isclose(a, b) for a, b in zip(add(h, correction), (2.2, .7, -.9)))
print('零修正:', add(h, zero), '非零修正:', add(h, correction))
print('若相加后加ReLU:', tuple(max(0, v) for v in add(h, zero)))

x, upstream = 2.0, 1.0
for slope in [0.2, -1.0]:
    y = x+slope*x
    direct, branch = upstream, upstream*slope
    total = direct+branch
    print('F斜率=', slope, 'y=', y, '两路贡献=', (direct, branch), '总反馈=', total)
assert isclose(upstream*(1+.2), 1.2)
assert upstream*(1-1) == 0

# 文献报告:ImageNet validation top-1 error, 10-crop;不是本代码训练输出。
reported_validation_error = {18: {'plain': 27.94, 'residual': 27.88},
                             34: {'plain': 28.54, 'residual': 25.03}}
for depth, row in reported_validation_error.items():
    print(depth, '层验证错误率减少(百分点):', round(row['plain']-row['residual'], 2))
assert isclose(reported_validation_error[34]['plain']-reported_validation_error[34]['residual'], 3.51)
print('此表不能代替训练曲线。')课件与图解:本段起点;逐页入口见上方各节。
运行后完成一句证据句:“在 ____ 数据、____ 指标、____ 评价设置下,同为 ____ 层时,改变 ____ 后观察到 ____;这还不能直接说明 ____。”然后用训练误差退化例检验自己的解释是否把优化和泛化混在一起。
课程导航
第二讲导读与完整索引 · 继续 CLS 06 · 现代骨干与公平比较
在 Deepnote 返回 CLS 00 · 第二讲导读。静态课件链接返回对应主题;需保留原 Slides 停点时,请在新标签页打开材料。