图像怎样成为分数,标签怎样形成损失,错误又怎样改变参数?本册沿第二讲 A 段,把这三个接口接成一次可以自己算完的学习过程。
跟着课堂继续:第 3–4 节读“分数→损失→求导→更新”,第 6 节读训练/验证曲线;想补足“为什么要学习表示”,先读第 1–2 节。末尾短代码只用 Python 标准库,可逐项核对手算,不需要下载数据或训练模型。
动手选一个问题:到 LAB 06 · 表示、损失与学习步长 改一次步长,比较更新前后损失;想读真实训练记录,到 LAB 02 · 小 CNN 与图像平移 找曲线与检查点选择。完成后带回一句判断:我改变了什么,哪一项记录支持我的解释?
1. 像素更接近,为什么不一定更像?
课件与图解:Learning to See:图像怎样成为可以学习的表示? · 同为自行车,为什么像素可以差别这么大? · 同类竖线平移一格,像素距离却比异类横线更远 · 给每个类别一套权重,就得到可调整的评分规则
先猜:下面两张候选图,哪张和查询的像素更接近?哪张仍属于“竖线”?
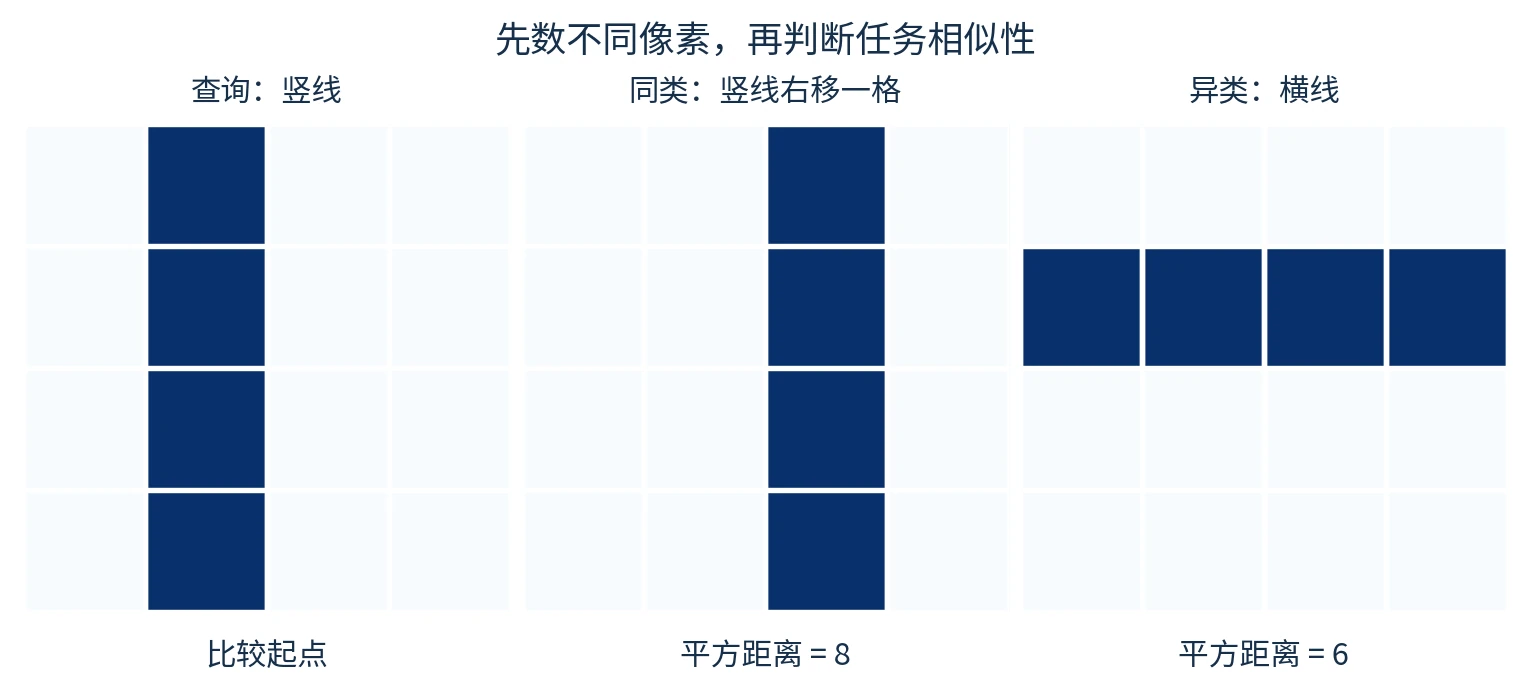
逐格核对。 三张图都只有 4 个亮像素。两条竖线不重叠,8 格不同,平方距离为 8;横竖线共享交点,只有 6 格不同,距离为 6。像素更近的候选,反而属于另一形状类别。
这个反例否定的是“像素距离小就总是任务相似”。它没有证明像素永远无用。同样,识别自行车时可以容忍位置变化,定位自行车时却不能把位置丢掉。保留什么,取决于要回答什么。
再算一个分数。 输入 x=(2,1),B 类权重 w=(1,−1)、b=0,得到 s_B=2−1=1。每类一行权重,合起来就是 s=Wx+b:输入由样本给出,W、b 留给训练调整。后面暂用三类分数 (2,1,0) 继续核对概率。
先预测与核对:圈出图中的 8 格与 6 格差异,再算 B 类分数。只要计算没错,评分规则就能应用;可是原坐标若根本分不开,继续调权重还有用吗?
图为主讲像素距离例的精确二值构造,不是模型分类结果。
2. 两灯任务:改变坐标,才改变可分性
课件与图解:恰好亮一盏:为什么一条直线分不开? · 只堆线性层还不够:让负响应归零会怎样? · 两个ReLU,给刚才的两灯任务一个可核对的解 · 换一组坐标,同一任务变得线性可分
任务是“恰好亮一盏”为正类;全灭与全亮为负类。先看四个样本搬到新坐标后,谁的位置变了,谁的标签没变。
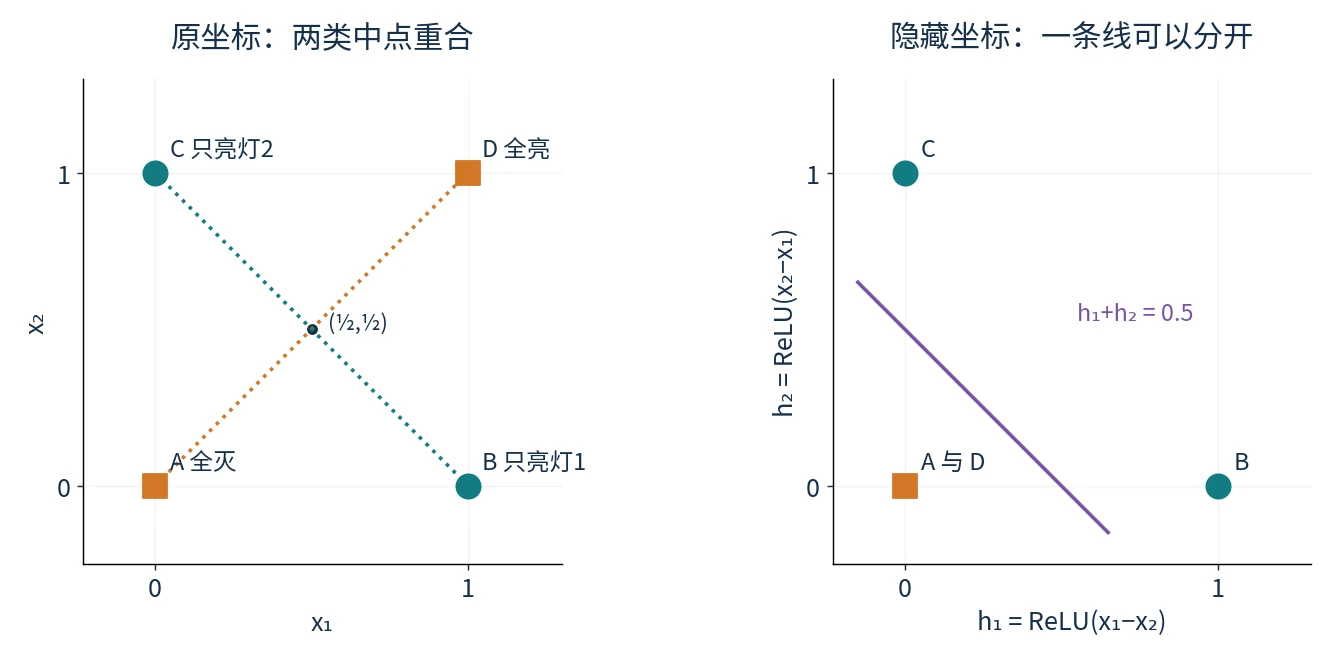
左图为什么分不开? 两个正类的中点与两个负类的中点都是 (½,½)。仿射分数在中点等于两端平均,因此一条直线不可能把两组严格分到两侧。增加训练轮次不会消除这个表达限制;只叠仿射层也仍是仿射函数。
右图具体改了什么? 插入 ReLU(z)=max(0,z),取 h₁=ReLU(x₁−x₂)、h₂=ReLU(x₂−x₁)。两个方向的正差变成新坐标:
| 样本 | 原坐标 (x₁,x₂) | 标签 | 新坐标 (h₁,h₂) | h₁+h₂−0.5 |
|---|---|---|---|---|
| A 全灭 | (0,0) | 负 | (0,0) | −0.5 |
| B 只亮灯1 | (1,0) | 正 | (1,0) | +0.5 |
| C 只亮灯2 | (0,1) | 正 | (0,1) | +0.5 |
| D 全亮 | (1,1) | 负 | (0,0) | −0.5 |
样本身份与标签没变;A、D 被映到同一个隐藏坐标。此时 h₁+h₂>0.5 就能分类。
先预测与核对:遮住表格后两列,先算 D 与 C,再指认图中两点。这里的权重是手工给出的可行解,证明结构能表达规则;还没有证明随机起点会训练出该解。下一步先解决训练所需的接口:怎样把分数与真实标签接起来?
3. 分数变概率,标签才决定损失
课件与图解:分数2、1、0,怎样变成一组类别概率? · 都预测成狗,为什么给猫20%与1%需要不同的损失?
回到暂存的分数 s=(2,1,0)。Softmax 定义 pc=exp(sc)/Σⱼexp(sⱼ)。计算时三项共同减去最大值 2,得到 exp(0)、exp(−1)、exp(−2),再除以总和,概率约为 (0.6652,0.2447,0.0900)。共同加减一个常数不改变相对概率;只改某一类分数则会改变归一化后的所有概率。
真实类别 y 到来后,单样本交叉熵是 L=−ln p_y。若真实类别为猫,猫概率为 60%、20%、1%,损失分别约为 0.51、1.61、4.61。后两次即使都被判成狗,准确率都记错,损失仍区分对真标签的支持程度。Softmax 概率由全部分数共同决定,损失读取其中真标签对应的一项。
先预测与核对:先预测把三个分数都加 10,概率是否变化;再比较猫概率从 1% 升到 20% 时损失的方向。核对:概率不变;损失下降。损失表达训练追求什么,下一步还需要知道参数怎样影响它。
4. 同一个标量例子,分开求导和更新
课件与图解:固定当前位置,导数告诉我们参数往哪边改 · 输出的反馈,怎样变成权重的反馈? · 先对当前计算求导,再统一更新参数
为了看清求导,暂换成一个明确的构造回归例:输入 x=2,目标 t=0,预测 y=wx,损失 L=½(y−t)²=2w²。它不是上一节猫狗分类的训练结果。
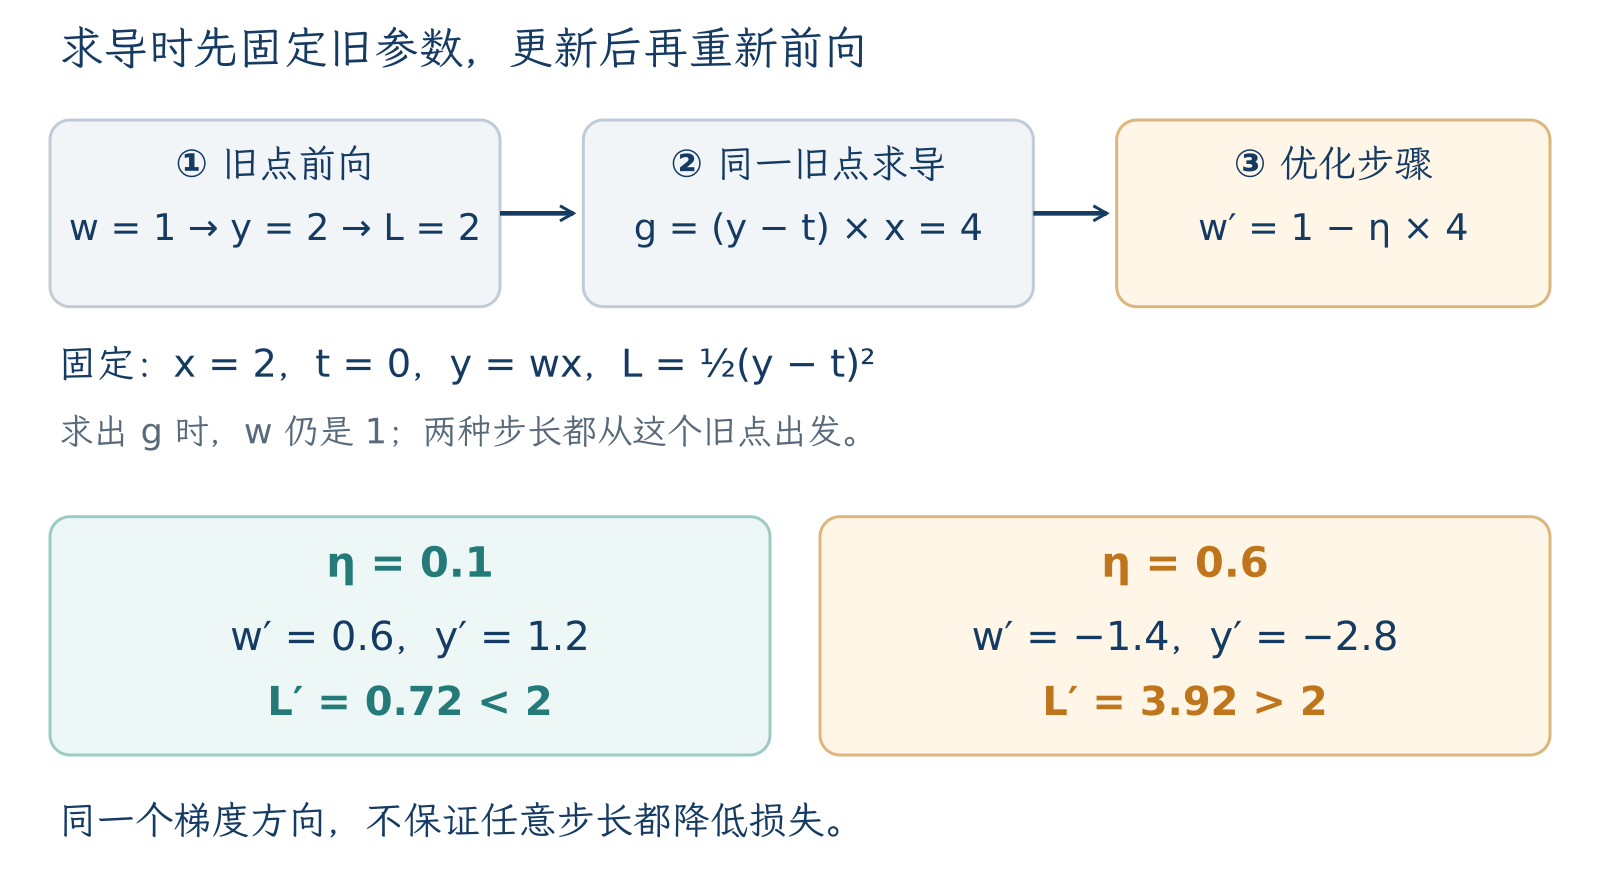
先看上排:求导尚未改参数。再遮住下排损失,分别算两种步长的新权重、新预测,最后揭开结果核对。
链式法则给出 ∂L/∂w=(∂L/∂y)(∂y/∂w)=(y−t)x=2×2=4。第一个 2 是损失对输出的反馈,第二个 2 是乘法对权重的局部导数 x;它们数值相同,来源不同。反向传播只产出梯度,优化步骤才执行 w′=w−ηg=1−0.1×4=0.6。之后重新计算 y′=1.2、L′=0.72,才算闭合一次更新。
先预测与核对:逐行写下参数是否已经改变;用有限差分 [L(1+ε)−L(1−ε)]/(2ε) 核对 g。再预测把 η 改为 0.6 是否仍下降。核对:w′=−1.4,L′=3.92,反而高于 2。局部下降方向与合适的步长是两个问题。接下来把一次更新放进小批量循环。
5. 一个 epoch,参数可以更新很多次
课件与图解:看完12个样本,参数已经更新了4次
12 个训练样本洗牌后,每批 3 个,恰好形成 4 批。每一批都完成前向、求导和更新,所以一个 epoch 包含 4 个 step:θ₀→θ₁→θ₂→θ₃→θ₄。后面一批在新的参数处计算梯度,不能把整个 epoch 描述成“先用 θ₀ 算完四批梯度,最后只更新一次”。
epoch 统计数据走过几遍,step 统计参数更新几次。若改成每批 4 个,本例一个 epoch 是 3 个 step;这只是计数变化,不能单凭步数说哪种 batch 泛化更好。这里样本数可整除批量大小;实际不整除时还要声明如何处理最后一批。
先预测与核对:在四个批次旁分别写上它读取的参数 θ₀、θ₁、θ₂、θ₃,并标出每次更新发生的位置。核对:同一批前向和反向对应同一组旧参数。训练循环闭合后,新的问题是:所有数据都能参与这个循环吗?
6. 数据的职责不同,曲线才有解释
课件与图解:训练、验证与测试的职责 · 训练曲线与泛化判断
| 数据 | 可以影响什么 | 阅读时要问什么 |
|---|---|---|
| 训练集 | 损失、梯度和参数更新 | 训练本身是否拟合改善? |
| 验证集 | 配置、轮次与检查点选择 | 按哪一个指标选方案? |
| 测试集 | 方案锁定后的独立评价 | 是否在评价后又据此调参? |
验证不对这些样本反向更新权重,但仍参与方案选择,不能冒充完全未参与选择的最终测试。
读本课曲线。 CNN/无增强的历史记录中,最小验证交叉熵为 0.1610109955072403,位于 epoch 6,所以按这个指标选择第 6 轮检查点。训练 train_online_loss 是一轮内随 batch 更新累计的损失;val_loss 是轮末固定当时模型的评估值。它们不是在同一组参数时刻计算,两条损失都在下降,不能只按高低关系判为过拟合。若训练拟合改善而验证变差,才有需要进一步调查的泛化信号;若训练也不好,仅说过拟合便解释不全。
数据协议保持原记录:官方 60,000 个 MNIST 训练样本按 seed=20260908 排列,前 12,000 个训练,位置 50,000:60,000 的 10,000 个验证;官方 10,000 个测试样本用于最终评价。指定右移测试属于另外的分布变化检查。这里读取保存结果,不要求重训;原始结果 JSON 与 LAB 02 · 小 CNN 与图像平移 保留可追溯数值。
做完要能判断:把“更新 w”“选择第 6 轮”“报告最终准确率”分别放回三栏,再说清训练损失下降为什么还不够。接下来进入 CNN:类别错误怎样经后层回到局部的共享参数?
把本段主线连起来
课件与图解:本段起点;逐页入口见上方各节。
请用五句连贯的话复述:任务决定哪些变化可以忽略;表示影响分类是否容易;分数与标签形成损失;反向传播求梯度、更新步骤改参数;独立评价检验是否能处理新样本。
本册的二值距离、两灯、Softmax 与标量回归是各自明确的小算例,不能拼成一次已经运行的图像训练。两灯给出表达能力的证据;标量例给出一次更新的证据;MNIST 曲线来自既有实验记录。完整的基础动手与记录模板见 LAB 06 · 表示、损失与学习步长。
课堂核对:先预测,再运行
课件与图解:本段起点;逐页入口见上方各节。
下面只用 Python 标准库,独立核对两灯、Softmax、标量更新和批次计数,不下载数据、不训练图像模型。先填预测:(1,1) 的隐藏值是什么?梯度算完 w 是否还是 1?η=0.6 的新损失是否下降?运行后的数值是这段小算例的输出,不是新的 MNIST 结果。
查看代码 · 单元 19
from math import exp, log, isclose

relu = lambda z: max(0.0, z)
lamps = [(0, 0), (1, 0), (0, 1), (1, 1)]
hidden = [(relu(a-b), relu(b-a)) for a, b in lamps]
predicted = [int(sum(h) > 0.5) for h in hidden]
assert hidden == [(0, 0), (1, 0), (0, 1), (0, 0)]
assert predicted == [0, 1, 1, 0]
print('两灯隐藏值:', hidden, '预测:', predicted)

def softmax(scores):
    z = [exp(s-max(scores)) for s in scores]
    return [v/sum(z) for v in z]
p = softmax([2, 1, 0])
assert all(isclose(a, b) for a, b in zip(p, softmax([12, 11, 10])))
print('概率:', [round(v, 4) for v in p])
print('猫概率0.6/0.2/0.01的损失:', [round(-log(q), 4) for q in [.6, .2, .01]])

x, target, w = 2.0, 0.0, 1.0
loss = lambda weight: 0.5*(weight*x-target)**2
y = w*x
g = (y-target)*x
assert w == 1.0 and g == 4.0  # 求导尚未改变参数
eps = 1e-6
fd = (loss(w+eps)-loss(w-eps))/(2*eps)
assert isclose(fd, g, rel_tol=1e-8)
for eta in [0.1, 0.6]:
    new_w = w-eta*g  # 两次都从同一旧点w=1开始比较
    print('eta=', eta, 'w新=', round(new_w, 4), 'y新=', round(new_w*x, 4), 'L新=', round(loss(new_w), 4))
assert isclose(loss(w-.1*g), .72)
assert isclose(loss(w-.6*g), 3.92)
assert 12//3 == 4 and 12//4 == 3
print('12个样本,batch=3: 4 steps;batch=4: 3 steps。')课件与图解:本段起点;逐页入口见上方各节。
运行后写三行:哪个输出验证了手算?哪个结论只是这个构造例成立?下一项需要什么独立证据?不要把“η=0.1 在这里下降”写成所有训练任务的默认最优步长。到 LAB 06 · 表示、损失与学习步长 继续时,保留“先预测—记录输出—解释差异”的顺序。
课程导航
第二讲导读与完整索引 · 继续 CLS 03 · 同一台 CNN
在 Deepnote 返回 CLS 00 · 第二讲导读。静态课件链接返回对应主题;需保留原 Slides 停点时,请在新标签页打开材料。