LAB 12 · Source、Norm 与 Tent
返回第二讲 · Source、Norm 与 Tent 参考 · 网页阅读版 · 第二讲导读
降低预测熵,会降低真实错误吗? 本册是适应研究的独立选读,承接 CLS08 第 7–9 节,不属于第二讲动态计算的默认课堂实验。
先读第 2 节三臂表和结果图,再读第 3 节的预测时点:Source 固定源统计;Norm 使用当前 batch 统计;Tent 在相同统计设置上更新 BN affine。每次比较先问“变了哪一项”,再谈改善。
模型是 DigitsMultiExitBN-integration-20260918-lcde-r1 的最终出口,与 LAB11 使用相同数据划分、训练代码和 seed;本册从头独立重建,不读取 LAB11 文件。保存状态哈希可核对模型身份。原始视觉 TTT 的旋转辅助任务与这里的熵目标不同。
可先读 2026-09-18 保存结果,无需运行。独立重算需 numpy torch scikit-learn matplotlib,会重新训练源模型并运行全部流;这些 digits 条件不是 Tent 论文基准复现。
先读这次保存运行,再作预测
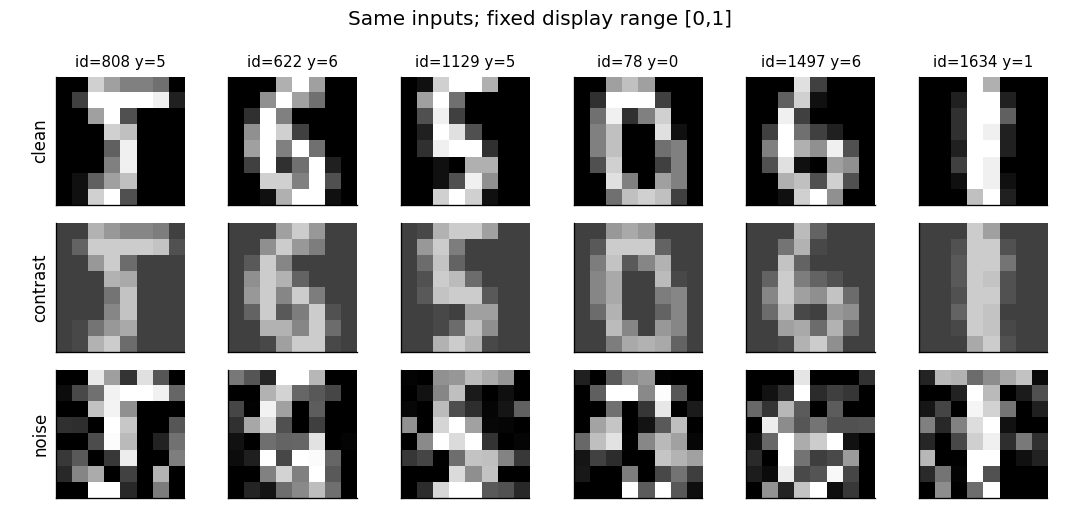
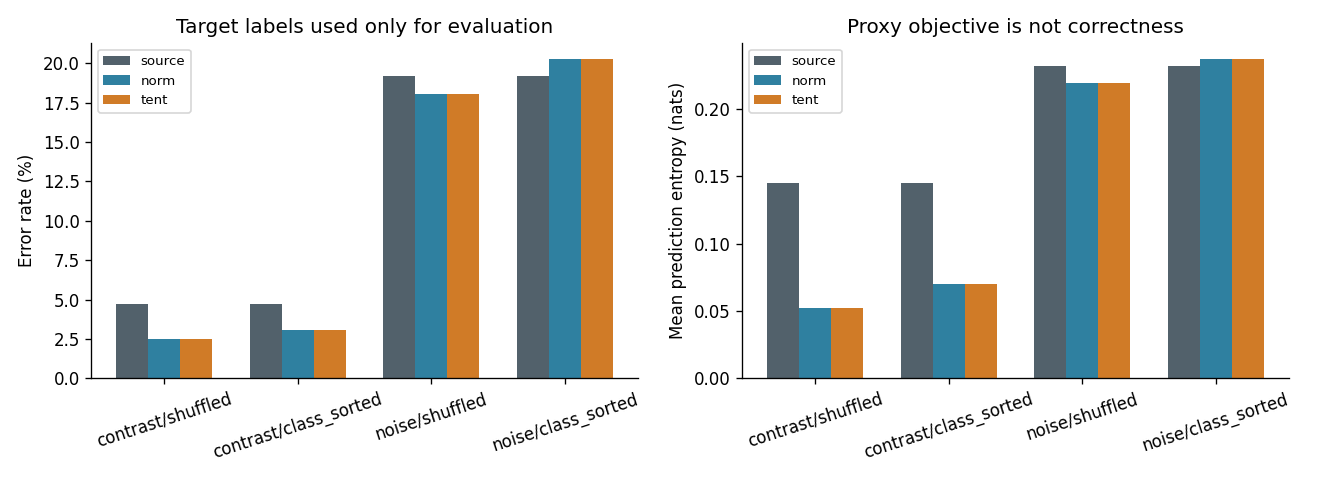
在固定噪声、类别分段的流中,source 准确率为 80.83%,norm 与 Tent 都为 79.72%;在打乱顺序的同一噪声图像上,source 为 80.83%,norm 与 Tent 为 81.94%。顺序改变没有重新抽噪声。
本次 Tent 与 norm 在四个预设情境中得到相同分类结果。 熵发生了很小变化、BN affine 确实更新,但没有观察到额外的分类改善。source→Tent 的改善或下降不能全部归因于熵梯度;这里必须先考察 batch 统计的影响。另一个严格对照是:单步、每批重置、报告更新前预测时,episodic Tent 与 norm 数值相同。
1. 固定输入、模型身份和允许使用的信息
划分、源训练和 checkpoint 选择与 本讲 LAB 11 完全相同。训练数据有标签;目标适应函数只接收图像及顺序,不接收目标标签。评价在所有预测完成后调用标签。两种事先固定的变化:clip(0.55*x+0.25,0,1) 与 clip(x+Normal(0,0.30),0,1),后者按 sample ID 固定噪声。它们是这批 digits 上的教学变化,不是 ImageNet-C 标准实现。
按相同 test ID 组成四个流:两种 corruption,各用固定随机顺序和按类别分段顺序。类别分段是研究者用标签离线构造的压力测试,不能声称实际部署已获得标签;适应算法仍只收到图像。batch=32(最后一批 8),每个 scenario/arm 从同一源 checkpoint 重置。Tent 默认每批 1 步 SGD lr=0.01、无 momentum,固定参数,未用目标标签调参。持续模式保留批间 affine 更新;额外 episodic 对照每批重置模型与优化器。
查看代码 · 单元 7
LAB_ID='LAB14-E'

from pathlib import Path
from copy import deepcopy
import csv, hashlib, json, platform, sys, time
import numpy as np
import torch
from torch import nn
import torch.nn.functional as F
import sklearn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt
SEED = 20260918
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(1)
torch.use_deterministic_algorithms(True)
OUTPUT = Path('outputs') / LAB_ID
OUTPUT.mkdir(parents=True, exist_ok=True)
plt.rcParams.update({'figure.dpi':120, 'font.size':10, 'axes.spines.top':False, 'axes.spines.right':False})
def save_json(name, obj):
    (OUTPUT/name).write_text(json.dumps(obj,ensure_ascii=False,indent=2))
def save_csv(name, rows):
    with (OUTPUT/name).open('w',newline='') as f:
        w=csv.DictWriter(f, fieldnames=list(rows[0])); w.writeheader(); w.writerows(rows)
def digest_array(a): return hashlib.sha256(np.ascontiguousarray(a).tobytes()).hexdigest()
def print_table(rows, cols=None):
    cols=cols or list(rows[0]); print(' | '.join(cols)); print(' | '.join(['---']*len(cols)))
    for row in rows:
        print(' | '.join(f'{row[c]:.5f}' if isinstance(row[c],float) else str(row[c]) for c in cols))
cpu_lines=Path('/proc/cpuinfo').read_text().splitlines() if Path('/proc/cpuinfo').exists() else []
cpu_name=next((line.split(':',1)[1].strip() for line in cpu_lines if line.startswith('model name')),platform.processor())
environment={'python':sys.version.split()[0],'torch':torch.__version__,'numpy':np.__version__,
             'sklearn':sklearn.__version__,'cpu':cpu_name,'platform':platform.platform(),
             'torch_threads':torch.get_num_threads(),'device':'cpu','dtype':'float32',
             'seed':SEED,'exclusive_hardware':False}
save_json('environment.json',environment)
print(json.dumps(environment,ensure_ascii=False,indent=2))
教师本地保存输出 · 2026-09-18
{
  "python": "3.12.14",
  "torch": "2.14.0+cpu",
  "numpy": "2.3.5",
  "sklearn": "1.8.0",
  "cpu": "INTEL(R) XEON(R) PLATINUM 8573C",
  "platform": "Linux-6.18.44-x86_64-with-glibc2.39",
  "torch_threads": 1,
  "device": "cpu",
  "dtype": "float32",
  "seed": 20260918,
  "exclusive_hardware": false
}
查看代码 · 单元 9
dataset = load_digits()
X = torch.tensor(dataset.images[:,None,:,:] / 16.0, dtype=torch.float32)
y = torch.tensor(dataset.target, dtype=torch.long)
all_ids = np.arange(len(y))
trainval_ids, test_ids = train_test_split(all_ids, test_size=0.2, random_state=SEED, stratify=y.numpy())
train_ids, val_ids = train_test_split(trainval_ids, test_size=0.25, random_state=SEED, stratify=y.numpy()[trainval_ids])
assert not (set(train_ids)&set(val_ids) or set(train_ids)&set(test_ids) or set(val_ids)&set(test_ids))
assert len(train_ids)+len(val_ids)+len(test_ids)==len(y)
split_manifest={'dataset':'sklearn.datasets.load_digits; 1797 real 8x8 images; pixel/16',
                'counts':{'train':len(train_ids),'validation':len(val_ids),'test':len(test_ids)},
                'train_ids':train_ids.tolist(),'validation_ids':val_ids.tolist(),'test_ids':test_ids.tolist(),
                'input_sha256':digest_array(X.numpy()),'labels_sha256':digest_array(y.numpy()),
                'split_policy':'stratified random by sample, NOT writer-disjoint', 'test_labels':'evaluation only'}
save_json('split-manifest.json',split_manifest)
print('Split:',split_manifest['counts'])
教师本地保存输出 · 2026-09-18
Split: {'train': 1077, 'validation': 360, 'test': 360}
查看代码 · 单元 11
MODEL_ID = 'DigitsMultiExitBN-integration-20260918-lcde-r1'
class DigitsMultiExitBN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1=nn.Conv2d(1,4,3,padding=1,bias=False)
        self.bn1=nn.BatchNorm2d(4)
        self.early=nn.Linear(4*4*4,10)
        self.conv2=nn.Conv2d(4,16,3,padding=1,bias=False)
        self.bn2=nn.BatchNorm2d(16)
        self.fc=nn.Linear(16*4*4,32)
        self.final=nn.Linear(32,10)
    def forward(self,x):
        h=F.avg_pool2d(F.relu(self.bn1(self.conv1(x))),2)
        early=self.early(h.flatten(1))
        h=F.relu(self.bn2(self.conv2(h)))
        final=self.final(F.relu(self.fc(h.flatten(1))))
        return early,final

def train_source():
    torch.manual_seed(SEED)
    model=DigitsMultiExitBN()
    optimizer=torch.optim.Adam(model.parameters(),lr=0.003)
    order_generator=torch.Generator().manual_seed(SEED+1)
    best_loss=float('inf'); best_state=None; best_epoch=None; history=[]
    for epoch in range(1,51):
        model.train()
        order=torch.as_tensor(train_ids)[torch.randperm(len(train_ids),generator=order_generator)]
        total=0.0
        for ids in order.split(64):
            optimizer.zero_grad(set_to_none=True)
            early,final=model(X[ids]); loss=0.35*F.cross_entropy(early,y[ids])+F.cross_entropy(final,y[ids])
            loss.backward(); optimizer.step(); total += loss.item()*len(ids)
        model.eval()
        with torch.no_grad():
            ve,vf=model(X[val_ids]); val_loss=F.cross_entropy(vf,y[val_ids]).item()
        history.append({'epoch':epoch,'train_weighted_loss':total/len(train_ids),
                        'validation_final_ce':val_loss,'validation_early_acc':(ve.argmax(1)==y[val_ids]).float().mean().item(),
                        'validation_final_acc':(vf.argmax(1)==y[val_ids]).float().mean().item()})
        if val_loss < best_loss:
            best_loss=val_loss; best_state=deepcopy(model.state_dict()); best_epoch=epoch
    model.load_state_dict(best_state); model.eval()
    return model,history,best_epoch
source_model,train_history,best_epoch=train_source()
source_state=deepcopy(source_model.state_dict())
state_hash=hashlib.sha256(b''.join(k.encode()+v.cpu().numpy().tobytes() for k,v in sorted(source_state.items()))).hexdigest()
save_csv('source-training.csv',train_history)
# Transparent JSON state is a local convenience; notebook always reconstructs from readable code.
save_json('source-state.json',{k:v.tolist() for k,v in source_state.items()})
model_manifest={'model_id':MODEL_ID,'state_sha256':state_hash,'best_epoch':best_epoch,
                'checkpoint_selection':'minimum validation final-exit CE over 50 epochs',
                'train_loss':'0.35*CE(early)+CE(final)','optimizer':'Adam lr=0.003 batch=64',
                'initialization_seed':SEED,'params':sum(p.numel() for p in source_model.parameters()),
                'old_LAB02_dependency':False,'data_split_sha256':hashlib.sha256(json.dumps(split_manifest,sort_keys=True).encode()).hexdigest()}
save_json('model-manifest.json',model_manifest)
print(json.dumps(model_manifest,indent=2))
教师本地保存输出 · 2026-09-18
{
  "model_id": "DigitsMultiExitBN-integration-20260918-lcde-r1",
  "state_sha256": "544bb0f79f5759b66656565e3e4c5a59a5dd8f2893a067d93a7fe331439c685c",
  "best_epoch": 48,
  "checkpoint_selection": "minimum validation final-exit CE over 50 epochs",
  "train_loss": "0.35*CE(early)+CE(final)",
  "optimizer": "Adam lr=0.003 batch=64",
  "initialization_seed": 20260918,
  "params": 9856,
  "old_LAB02_dependency": false,
  "data_split_sha256": "6f705c12f1651f0c5b871f8ff65f4241bdbc1ffbd61a5f0fc56ac95bbb0cf129"
}
2. 三个臂究竟改变了什么?
| 臂 | 用于归一化的统计 | running buffers | 梯度更新 | 预测时点 |
|---|---|---|---|---|
| source | 源训练 running mean/var | 保留并冻结 | 无 | 该次 forward |
| norm | 当前目标 batch | track_running_stats=False,mean/var 置 None;计数器保留但不递增 |
无 | 该次 forward |
| Tent | 当前目标 batch | 与 norm 相同 | 仅两个 BN 的 weight/bias(40 个标量) | 每批更新前的 logits |
同一目标 batch 同时参与估计统计与预测,因而不是逐样本独立预测。所有臂卷积与分类头固定;norm 不做 affine 更新;Tent 只有 affine 被允许求梯度。没有把 buffers 禁用写成“更新 running 统计”。
官方 forward_and_adapt 先得到 outputs,再计算熵、反传、step,返回的仍是该次更新前 outputs。下面对应这个时点;不额外前向测更新后效果,也不暗中忽略其成本。每臂完成后比较参数/buffer,并断言只有允许状态发生变化。
查看代码 · 单元 15
BATCH=32; TTA_LR=.01
sample_noise=np.stack([np.random.default_rng(SEED+int(s)*17).normal(0,.30,(1,8,8)) for s in test_ids])
target_inputs={'contrast':torch.clamp(.55*X[test_ids]+.25,0,1),
               'noise':torch.clamp(X[test_ids]+torch.tensor(sample_noise,dtype=torch.float32),0,1)}
orders={'shuffled':np.random.default_rng(SEED+77).permutation(len(test_ids)),
        'class_sorted':np.argsort(y[test_ids].numpy(),kind='stable')}
save_json('tta-protocol.json',{'batch':BATCH,'learning_rate':TTA_LR,'steps_per_batch':1,'optimizer':'SGD; momentum=0',
 'corruptions':{'contrast':'clip(0.55*x+0.25,0,1)','noise':'clip(x+N(0,0.30),0,1); seed=SEED+sample_id*17'},
 'prediction_timing':'logits from forward before this batch optimizer.step()',
 'reset':'same source checkpoint for each scenario and arm; episodic resets each batch',
 'label_use':'only post-prediction evaluation; class_sorted stress order constructed offline with labels',
 'target_input_hashes':{k:digest_array(v.numpy()) for k,v in target_inputs.items()},
 'orders':{k:v.tolist() for k,v in orders.items()},'test_hyperparameter_tuning':False})
fig,axs=plt.subplots(3,6,figsize=(9,4.3))
for row,(name,inputs) in enumerate([('clean',X[test_ids]),*target_inputs.items()]):
    for j in range(6):
        axs[row,j].imshow(inputs[j,0],cmap='gray',vmin=0,vmax=1);axs[row,j].set_xticks([]);axs[row,j].set_yticks([])
        if row==0:axs[row,j].set_title(f'id={test_ids[j]} y={int(y[test_ids[j]])}',fontsize=9)
    axs[row,0].set_ylabel(name)
fig.suptitle('Same inputs; fixed display range [0,1]');fig.tight_layout();fig.savefig(OUTPUT/'tta-inputs.png');plt.show()
教师本地保存输出 · 2026-09-18
查看代码 · 单元 17
def entropy(logits): return -(logits.softmax(1)*logits.log_softmax(1)).sum(1)
def new_arm(arm):
    model=DigitsMultiExitBN();model.load_state_dict(source_state);model.requires_grad_(False)
    if arm=='source': model.eval(); return model,None
    model.train()
    affine=[]
    for module in model.modules():
        if isinstance(module,nn.BatchNorm2d):
            module.track_running_stats=False;module.running_mean=None;module.running_var=None
            if arm=='tent':
                module.weight.requires_grad_(True);module.bias.requires_grad_(True)
                affine += [module.weight,module.bias]
    opt=torch.optim.SGD(affine,lr=TTA_LR,momentum=0) if arm=='tent' else None
    return model,opt

def adapt_stream(images,order,arm,episodic=False):
    # No labels argument. Source state read-only; each invocation starts independently.
    model,opt=new_arm(arm)
    initial_parameters={n:p.detach().clone() for n,p in model.named_parameters()}
    initial_buffers={n:b.detach().clone() for n,b in model.named_buffers()}
    logits=np.zeros((len(images),10),dtype=np.float32); batch_records=[]
    allowed={'bn1.weight','bn1.bias','bn2.weight','bn2.bias'} if arm=='tent' else set()
    for batch_index,start in enumerate(range(0,len(order),BATCH)):
        if episodic: model,opt=new_arm(arm)
        local=order[start:start+BATCH]; batch=images[local]
        if arm=='tent':
            opt.zero_grad(set_to_none=True)
            _,out=model(batch)
            loss=entropy(out).mean()
            # Save the prediction from before the current update; no extra forward.
            logits[local]=out.detach().numpy()
            loss.backward(); opt.step()
        else:
            with torch.no_grad(): _,out=model(batch)
            logits[local]=out.numpy();loss=entropy(out).mean()
        changed_this_batch=[n for n,p in model.named_parameters() if not torch.equal(p.detach(),initial_parameters[n])]
        assert set(changed_this_batch)<=allowed
        batch_records.append({'batch_index':batch_index,'n':len(local),'entropy_pre_update':float(loss.detach()),
            'affine_delta_l2':float(sum((p.detach()-initial_parameters[n]).square().sum() for n,p in model.named_parameters()).sqrt())})
    deltas={n:float((p.detach()-initial_parameters[n]).abs().max()) for n,p in model.named_parameters()}
    changed=[n for n,d in deltas.items() if d>0]
    buffer_changes=[n for n,b in model.named_buffers() if not torch.equal(b,initial_buffers[n])]
    assert set(changed)<=allowed and not buffer_changes
    if arm=='tent': assert changed and sum(p.numel() for p in model.parameters() if p.requires_grad)==40
    audit={'arm':arm,'episodic':episodic,'changed_parameters':changed,'max_absolute_parameter_deltas':deltas,
           'changed_buffers_during_stream':buffer_changes,
           'running_means_none':{n:m.running_mean is None for n,m in model.named_modules() if isinstance(m,nn.BatchNorm2d)},
           'num_batches_tracked':{n:int(m.num_batches_tracked) for n,m in model.named_modules() if isinstance(m,nn.BatchNorm2d)},
           'trainable_parameter_count':sum(p.numel() for p in model.parameters() if p.requires_grad)}
    return logits,batch_records,audit

# Compute every scenario before calling target labels for evaluation below.
runs={};audits={};batch_rows=[]
for corruption,images in target_inputs.items():
    for order_name,order in orders.items():
        for arm,episodic in [('source',False),('norm',False),('tent',False),('tent',True)]:
            name=f'{corruption}/{order_name}/{arm}'+('-episodic' if episodic else '')
            result,batches,audit=adapt_stream(images,order,arm,episodic)
            runs[name]=result;audits[name]=audit
            batch_rows += [{'run':name,**row} for row in batches]
# At the first batch all affine values coincide: Tent prediction must equal Norm prediction.
for corruption in target_inputs:
    for order_name,order in orders.items():
        idx=order[:BATCH]
        assert np.allclose(runs[f'{corruption}/{order_name}/tent'][idx],runs[f'{corruption}/{order_name}/norm'][idx],atol=1e-6)
        # With per-batch reset and before-update prediction, episodic Tent outputs equal Norm for every batch.
        assert np.allclose(runs[f'{corruption}/{order_name}/tent-episodic'],runs[f'{corruption}/{order_name}/norm'],atol=1e-6)
save_json('parameter-buffer-audit.json',audits);save_csv('batch-trajectories.csv',batch_rows)
print('Passed: only allowed BN affine changed; no running buffers updated; first-batch predictions match Norm;')
print('episodic + one step + before-update predictions match Norm across the whole stream.')
教师本地保存输出 · 2026-09-18
Passed: only allowed BN affine changed; no running buffers updated; first-batch predictions match Norm;
episodic + one step + before-update predictions match Norm across the whole stream.
查看代码 · 单元 19
truth=y[test_ids].numpy();summary=[];prediction_rows=[]
for name,logits in runs.items():
    probs=torch.tensor(logits).softmax(1).numpy();pred=probs.argmax(1)
    ents=entropy(torch.tensor(logits)).numpy(); wrong=pred!=truth
    summary.append({'run':name,'accuracy':float(np.mean(~wrong)),'errors':int(wrong.sum()),
                    'mean_entropy':float(ents.mean()),'wrong_confident_p_ge_09':int(np.sum(wrong&(probs.max(1)>=.9)))})
    for i,sample_id in enumerate(test_ids):
        prediction_rows.append({'run':name,'sample_id':int(sample_id),'target':int(truth[i]),'prediction':int(pred[i]),
              'confidence':float(probs[i].max()),'entropy':float(ents[i]),**{f'logit_{k}':float(logits[i,k]) for k in range(10)}})
save_csv('tta-summary.csv',summary);save_csv('tta-predictions.csv',prediction_rows)
print_table(summary)
fig,axs=plt.subplots(1,2,figsize=(11,4))
labels=[c+'/'+o for c in target_inputs for o in orders]
xx=np.arange(len(labels));colors=['#52616b','#2f80a0','#d07b27']
for i,arm in enumerate(['source','norm','tent']):
    selected=[next(r for r in summary if r['run']==f'{label}/{arm}') for label in labels]
    axs[0].bar(xx+(i-1)*.24,[100*(1-r['accuracy']) for r in selected],width=.24,label=arm,color=colors[i])
    axs[1].bar(xx+(i-1)*.24,[r['mean_entropy'] for r in selected],width=.24,label=arm,color=colors[i])
for ax in axs: ax.set_xticks(xx,labels,rotation=18); ax.legend(fontsize=8)
axs[0].set(ylabel='Error rate (%)',title='Target labels used only for evaluation')
axs[1].set(ylabel='Mean prediction entropy (nats)',title='Proxy objective is not correctness')
fig.tight_layout();fig.savefig(OUTPUT/'tta-comparison.png');plt.show()
comparisons=[]
for label in labels:
    s,n,t=[next(r for r in summary if r['run']==f'{label}/{arm}') for arm in ['source','norm','tent']]
    comparisons.append({'scenario':label,'tent_minus_source_error_pp':100*(s['accuracy']-t['accuracy']),
                        'tent_minus_norm_error_pp':100*(n['accuracy']-t['accuracy']),
                        'tent_minus_norm_entropy':t['mean_entropy']-n['mean_entropy']})
save_csv('tta-differences.csv',comparisons);print_table(comparisons)
教师本地保存输出 · 2026-09-18
run | accuracy | errors | mean_entropy | wrong_confident_p_ge_09
--- | --- | --- | --- | ---
contrast/shuffled/source | 0.95278 | 17 | 0.14519 | 3
contrast/shuffled/norm | 0.97500 | 9 | 0.05240 | 4
contrast/shuffled/tent | 0.97500 | 9 | 0.05233 | 4
contrast/shuffled/tent-episodic | 0.97500 | 9 | 0.05240 | 4
contrast/class_sorted/source | 0.95278 | 17 | 0.14519 | 3
contrast/class_sorted/norm | 0.96944 | 11 | 0.06980 | 5
contrast/class_sorted/tent | 0.96944 | 11 | 0.06979 | 5
contrast/class_sorted/tent-episodic | 0.96944 | 11 | 0.06980 | 5
noise/shuffled/source | 0.80833 | 69 | 0.23194 | 17
noise/shuffled/norm | 0.81944 | 65 | 0.21923 | 20
noise/shuffled/tent | 0.81944 | 65 | 0.21916 | 20
noise/shuffled/tent-episodic | 0.81944 | 65 | 0.21923 | 20
noise/class_sorted/source | 0.80833 | 69 | 0.23194 | 17
noise/class_sorted/norm | 0.79722 | 73 | 0.23695 | 20
noise/class_sorted/tent | 0.79722 | 73 | 0.23695 | 20
noise/class_sorted/tent-episodic | 0.79722 | 73 | 0.23695 | 20
scenario | tent_minus_source_error_pp | tent_minus_norm_error_pp | tent_minus_norm_entropy
--- | --- | --- | ---
contrast/shuffled | -2.22222 | 0.00000 | -0.00007
contrast/class_sorted | -1.66667 | 0.00000 | -0.00002
noise/shuffled | -1.11111 | 0.00000 | -0.00007
noise/class_sorted | 1.11111 | 0.00000 | -0.00001
3. 为什么 episodic 与 norm 会重合?
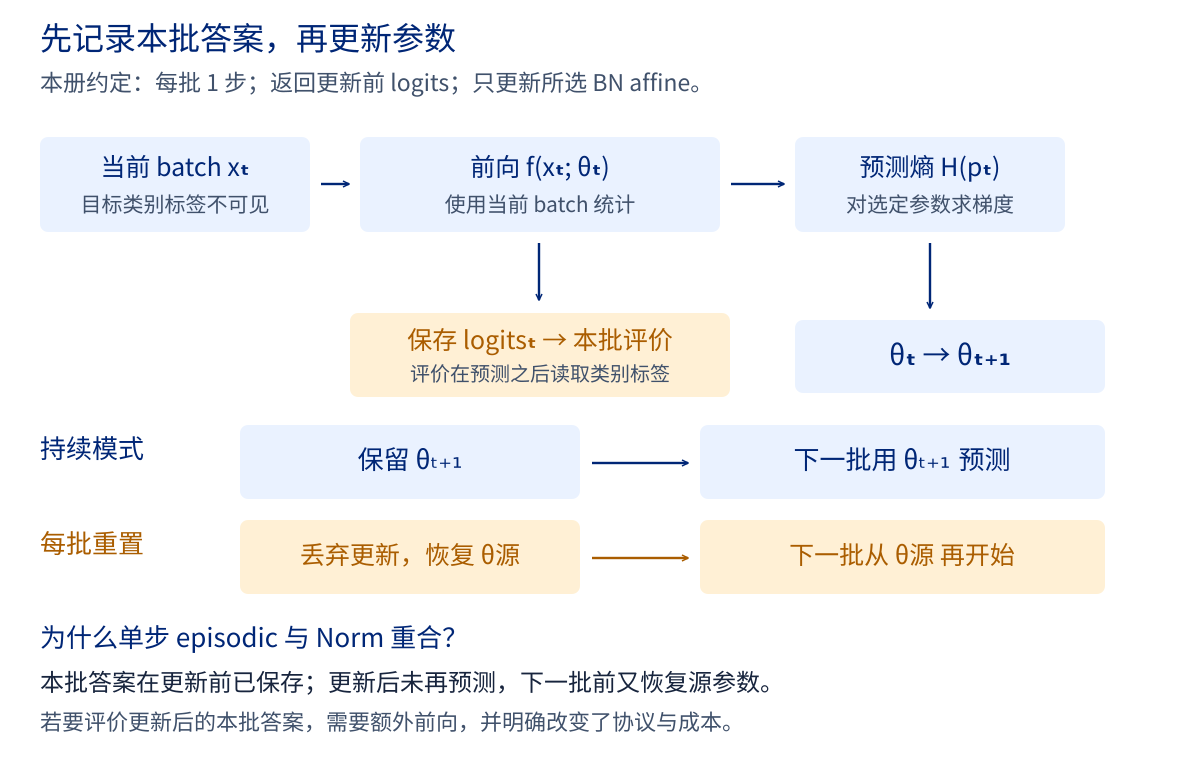
先读箭头,再读结果。 本册每批只走一步,返回该步更新前的 logits。每批先重置时,这次 forward 的 affine 与 Norm 相同;更新发生在答案已被记录之后,又在下一批开始前被丢弃。因此单步 episodic Tent 与 Norm 的逐样本预测重合,正是当前协议的预期结果,不是实现没执行更新。
持续模式保留更新,才可能影响下一批。要考察“本批更新后预测”,必须额外前向;它改变了预测时点和成本,不能把现有保存数值换个标题就算验证。
改变一个条件。 固定每批输入和一次更新,只将“每批重置”改成“持续保留”。第一批预测是否应相同?从哪批起可能不同?对照代码中第一批一致性断言与参数审计回答。
类别分段还会改变当前 batch 统计的代表性。因此先用 Source→Norm 检查统计作用,再用 Norm→Tent 检查额外梯度作用,不能把两者合成一个解释。
查看代码 · 单元 23
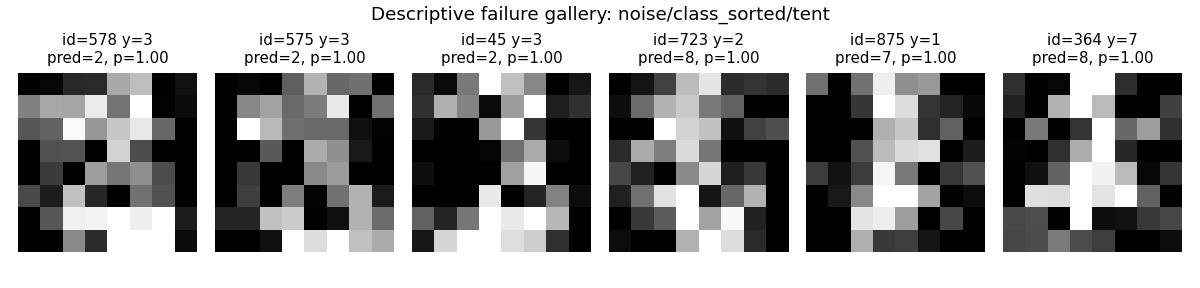
# Inspect actual model mistakes. Prefer cases where Tent is wrong with high confidence.
worst_name=max((n for n in runs if n.endswith('/tent')),key=lambda n:int((runs[n].argmax(1)!=truth).sum()))
logits=runs[worst_name];p=torch.tensor(logits).softmax(1).numpy();pred=p.argmax(1)
wrong=np.flatnonzero(pred!=truth); chosen=wrong[np.argsort(-p[wrong].max(1))[:6]]
corruption=worst_name.split('/')[0]
fig,axs=plt.subplots(1,6,figsize=(10,2.4))
for ax,i in zip(axs,chosen):
    ax.imshow(target_inputs[corruption][i,0],cmap='gray',vmin=0,vmax=1);ax.axis('off')
    ax.set_title(f'id={test_ids[i]} y={truth[i]}\npred={pred[i]}, p={p[i].max():.2f}',fontsize=9)
fig.suptitle('Descriptive failure gallery: '+worst_name,fontsize=11)
fig.tight_layout();fig.savefig(OUTPUT/'tta-failures.png');plt.show()
print('Gallery chosen after evaluation to describe failure, not to select algorithm or report a best run.')
# Logical counterexample; separate from empirical frequency above.
wrong_logits=torch.tensor([[0.,2.,0.]])  # true class 0, predicted class 1
counterexample=[]
for scale in [1.,2.,5.]:
    z=scale*wrong_logits
    counterexample.append({'logit_scale':scale,'prediction':int(z.argmax(1)),
                          'entropy':float(entropy(z)),'correct':bool(z.argmax(1)==0)})
print_table(counterexample);save_csv('exact-entropy-counterexample.csv',counterexample)
教师本地保存输出 · 2026-09-18
Gallery chosen after evaluation to describe failure, not to select algorithm or report a best run.
logit_scale | prediction | entropy | correct
--- | --- | --- | ---
1.00000 | 1 | 0.66557 | False
2.00000 | 1 | 0.17732 | False
5.00000 | 1 | 0.00100 | False
4. 再改一个条件,明确什么会推翻解释
先读现有四种条件,不必运行
保持噪声图像不变,只比较 shuffled 与 class_sorted:Source 都为 80.83%;Norm/Tent 从 81.94% 变为 79.72%。这里没有重新抽噪声,改变的是顺序和 batch 同伴。请指出哪两行支持“统计作用”,哪两行才能检验“额外熵梯度作用”。
完成一个两句解释。 “Source→Norm 显示____;Norm→Tent 显示____。”准确率相同不能单独证明 logits 相同,需结合逐样本记录与状态审计;不要把小熵变化自动改写成分类收益。
再改一个条件
若选择运行:保持样本、噪声与顺序,只把 batch=32 改为 batch=8。运行前预测统计的代表性与结果可能如何变化;运行后同时报告错误、熵和允许更新的参数。没有预设单向答案。根据当前测试标签挑出最好的 batch 或学习率属于开发,不能仍称零标签调参。
保存结果覆盖全部预设条件;失败图是评价后选出的解释样例,总体频率以 360 张完整表为准。logits 缩放反例证明低熵不蕴含正确,与实际失败频率是两种证据。
历史本地执行包含源模型训练、16 个流/臂、参数与 buffers 审计、更新前预测核对及逐样本记录;不表示已在你的 Deepnote 副本重新运行。