CLS 08 · 分布变化与适应
返回第二讲 · 可靠性与适应参考 · 网页阅读版 · 第二讲导读
没有目标标签时,更新会帮忙吗? 这是独立选读材料,供对分布变化、校准和测试时适应感兴趣的同学继续;不属于第二讲默认课堂练习。
若从视觉 TTT 页来到这里,请先分清:原始视觉 TTT 使用训练期已准备的辅助任务;本册 Tent 使用预测熵,更新选定的 BN affine 参数。它们不能共用一份实验结论。
建议先读第 7–9 节:列出 Source/Norm/Tent 各允许改变什么,再看“熵变小”和“分类变好”为何是两个判断;随后在 第二讲 LAB12 · Source、Norm 与 Tent 用保存结果检查。想补概念时回看第 1–6 节;持续数据流见第 10 节。
BN 的公式、同伴构造与参数/buffers 区别见 CLS03 · 同一台 CNN。
1. 先定义哪些变化应该保留答案
一张叶片变亮、背景换色,类别可能不变;若颜色正是病理线索,强烈改色又可能改变问题本身。鲁棒性不是要求模型对所有输入变化都无动于衷,而是在明确的任务语义下,对一组应保留答案的变化仍作正确判断。遇到任务外对象,还可能应拒识,而不是坚持从已有类别选一个。
这条边界来自任务定义,不能由变换代码自动决定。测试时要保留原图、变换参数、处理后的图像及适用类别;没有运行模型,就让读者预测或观察图像,不为它填一组虚构的置信度。参考图解 换环境的现象。
2. 同样改像素,不一定是同一种研究问题
| 变化 | 谁选择变化? | 评价前必须说明 |
|---|---|---|
| 常见 corruption | 预定变换族与强度 | 噪声/模糊等种类、severity、数据来源 |
| 对抗扰动 | 为使模型失败而优化输入 | 范数、$\epsilon$、攻击知识、步数、裁剪范围 |
| 自然分布变化 | 拍摄与采样条件改变 | 场景、类别映射、样本筛选方式 |
FGSM 是 2014 年预印本的前史;PGD 鲁棒训练把指定扰动集合写入目标。ImageNet-A 是自然困难样本,不是给每张图加一个合成像素攻击。可以研究这些条件间的迁移,但“在 corruption 上变好”并不等于“防住所有对抗攻击”。FGSM、ImageNet-A。
3. 改变测试集为何成为研究贡献?
当更高的干净数据准确率无法回答环境变化下的表现,评价本身就需要扩展。ImageNet-C 对常见 corruption 与强度给出可重复条件;ImageNet-P 评价连续轻微扰动下预测变化。两者的正式联合论文为 ICLR 2019,arXiv:1903.12261 于 2019-03-28 提交。更早的 2018-07-04 版本标题是 Common Corruptions and Surface Variations,包含 ImageNet-C 与不同的 surface variation 研究;不能把 ImageNet-P 的完整联合基准回填到 2018。2019正式版本、2018前身。
ObjectNet 则通过拍摄角度、背景与旋转等条件检查识别器对常见图像收集偏差的依赖。作者网站。类别映射、图像来源和评价条件不同,分数不能无条件横比。基准能使某些失败可重复,但任何有限基准都不是所有未来环境的代表。
4. 模型依赖了形状,还是纹理?
让形状与纹理指向不同类别,可以区分两种解释。Geirhos 等的 cue-conflict 研究不是只问“分类对不对”,而是统计选择形状类别还是纹理类别。原文 Sec.3.1 中,在相应条件下,人类观察者形状选择比例为 95.9%,ResNet-50 为 22.1%;后者纹理选择比例为 77.9%。这是论文报告的形状/纹理选择统计,不是通常的分类准确率,也不是课堂展示那一张图的实测预测。原文与实验条件。
一张真实刺激适合先让读者预测,一组受控刺激统计才支持研究结论。不能把指定网络和训练条件下的纹理偏好泛化成“所有 CNN 只看纹理”。与遮挡实验一样,干预应同时有负对照:如果遮挡任何同等面积区域都造成损失,就不能把某一局部当作独有证据。
5. 训练时怎样把威胁集合纳入目标?
这里按“评价发现问题→训练时怎样回应”的问题顺序,回看较早的并行探索。Madry 等工作于 2017 年 6 月首次提交,正式发表于 ICLR 2018;它早于前面讨论的 ICLR 2019 corruption 基准,不能读成后者在历史上催生了前者。
鲁棒优化先在参数固定时,寻找允许集合 $\Delta$ 内使损失大的扰动;再在这些困难输入上更新参数降低损失:$\min_\theta\mathbb E_{(x,y)}[\max_{\delta\in\Delta}\ell(f_\theta(x+\delta),y)]$。内层改变输入,外层改变模型。类别标签仍由训练集提供;这是训练时回应,不是部署时无标签更新。Madry等,ICLR 2018。
PGD 用多步梯度与投影近似内层搜索,投影保证扰动留在指定集合。一次有限攻击没找到失败点,不证明集合内没有失败;随机起点、攻击预算与模型随机性都影响结果。准确率与鲁棒性的取舍也必须落到特定理论或实验条件,不能写成不依任务的自然定律。条件性取舍研究。
参考图解 鲁棒优化的内外两层目标。
6. 置信度、校准和拒识分别回答什么?
准确率问最大分数对应的类别是否正确,校准问置信水平是否匹配经验正确率。ECE 把样本按置信度分箱再比较 bin 内平均置信度和准确率,因此分箱是指标的一部分。一个构造例:四个样本置信度为 0.9、0.9、0.6、0.6,前两个正确、后两个错误。分两箱时 ECE 为 $0.5\times0.1+0.5\times0.6=0.35$;全部放一箱时为 $|0.75-0.50|=0.25$。这是计算关系,不是实测模型排名。校准研究。
拒识还要决定在哪些输入上不回答,并报告拒绝多少与保留样本错多少。校准改善不自动附赠一个可用拒识器,Tent 也不自动提供它。若某个安全约束要求极少漏判,平均 ECE 不能替代该子群的风险评价。
7. 从同一源模型出发,区分三条测试路径
Tent 从分布变化提出另一问:已有模型拿到无标签测试图像后,能否用当前数据调整自身?它首次公开于 2020 年,正式发表于 ICLR 2021。这个设定只有模型与目标输入,没有源训练数据和目标标签。Tent原文。
BN 的两步公式和 batch 同伴构造见 CLS03 架构支撑。这里直接列出相同初始化下的三臂,分别决定统计来源与 affine 参数更新。
| 同源初始化的比较臂 | 本次规范化用什么统计? | $\gamma,\beta$ 怎样处理? |
|---|---|---|
| Source | 固定的源 running mean/variance | 固定 |
| Norm | 当前目标 batch 的统计 | 固定,无梯度更新 |
| Tent | 当前目标 batch 的统计 | 按协议对所选 affine 参数作熵梯度更新 |
估计当前 batch 统计、累积 running buffers、梯度更新参数,是三个不同动作。 默认 BN 的 running buffers 可以由滑动平均积累;本课 Norm/Tent 禁用这些累积 buffers,只使用当前 batch。Source 则保持源 buffers;三臂均从同一源 checkpoint 独立复制。框架中当前 batch 方差与存入 running variance 的估计约定也不同,不能仅凭一个 train() 就概括全部协议。
LAB 12 已使用独立训练并保存的 DigitsMultiExitBN-integration-20260918-lcde-r1;它与 LAB 11 同源,并非无 BN 的旧 LAB02 CNN。模型身份、参数/buffer 审计与运行条件均保留在 Lab。参考图解 BN 与 Source/Norm/Tent 三臂。
8. 没有答案,梯度从哪里来?
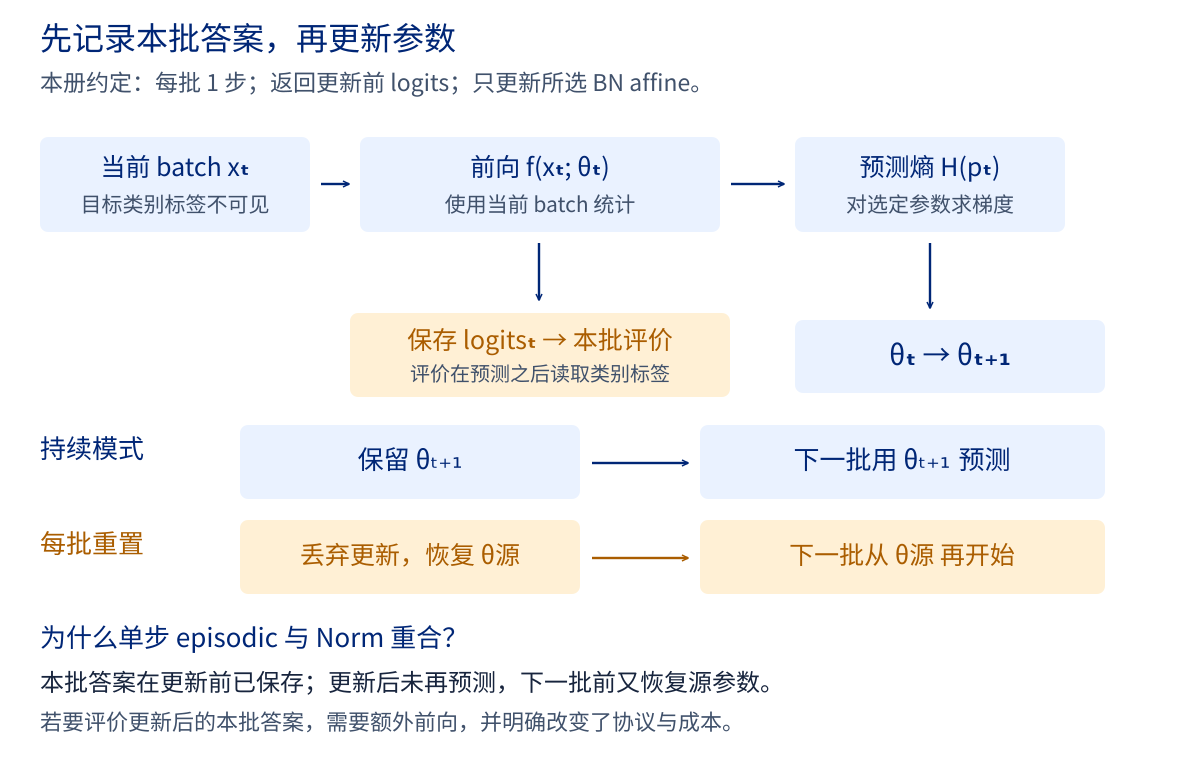
先指认时点。 图中哪一份 logits 已经记入本批评价?更新后的参数能影响本批已保存的答案,还是下一批?
Tent 用预测分布的熵 $H(p)=-\sum_c p_c\log p_c$ 作为可计算目标,对一批图像取平均,只更新协议允许的 BN affine 参数。目标类别标签不进入更新,只在事后评价错误。
本课对应的作者实现先得到 logits,再反传熵并执行 optimizer step,最后返回先前的 logits。因而单步调用返回本批更新前预测。若持续保存参数,本批更新可以影响下一批;若每批重置、每批只走一步且仍报告更新前预测,这份更新没有机会影响被报告的答案,episodic Tent 就会与 Norm 重合。额外做一次更新后前向会改变评价协议,也应计入成本。
本实现中 BN 使用当前 batch 统计,track_running_stats=False,running mean/variance 置为 None;这与用滑动平均累积 running buffers 是不同动作。
改变一个条件。 保持输入和初始参数,分别设想“保留上批参数”和“下批前重置”。你预期从哪一批开始可能出现预测差异?到 LAB12 第 3 节核对保存输出。
9. 代理目标下降,真正目标可能没改善
真实类别为 A,预测从 $(0.1,0.9)$ 变为 $(0.01,0.99)$。自然对数熵从约 0.3251 降至 0.0560,最大概率仍指向错误类别 B。这一精确反例说明“更自信”不逻辑蕴含“更正确”,没有声称已经运行 Tent 得到这条轨迹。若实际实验没有出现这种失败,也应保留真实结果。查看数学反例。
这个问题直接接回最初的监督损失:有标签训练用答案限定更新方向,无标签适应只能借助额外假设。评价时至少同时画熵和错误,并检查源模型是否真正冻结、参数改变是否限于宣称对象。只见 loss 下降不能把适应判为成功。
把反例带回已经保存的实验。 LAB 12 预设的是两类变化(contrast/noise)×两种顺序(shuffled/class-sorted),不是事后挑出一条最有利结果。四种条件下 Norm 与 continual Tent 的汇总准确率均相同;状态审计却确认 BN affine 已改变,熵也有小变化。对 noise,打乱顺序时准确率从 Source 的 80.83% 到 Norm/Tent 的 81.94%;按类别排列时则到 79.72%。先用 Source→Norm 检查统计作用,再用 Norm→Tent 检查额外梯度作用;相同准确率本身不能证明每张图的预测相同。完整四情景和 episodic 对照见 LAB 12 保存结果,参考结果图位于 熵反例与实际观察。
| 预设情景 | Source | Norm | Tent持续 | Tent每批重置 |
|---|---|---|---|---|
| contrast/打乱 | 95.28% | 97.50% | 97.50% | 97.50% |
| contrast/类别分段 | 95.28% | 96.94% | 96.94% | 96.94% |
| noise/打乱 | 80.83% | 81.94% | 81.94% | 81.94% |
| noise/类别分段 | 80.83% | 79.72% | 79.72% | 79.72% |
每情景360张,batch32、末批8,单步SGD学习率0.01,按更新前logits评价。类别分段是使用标签离线构造的压力测试顺序,标签不传入适应函数、不用于调参。此次重新对齐保存预测发现,四情景Norm与持续Tent的argmax差异均为0/360;但每情景有328/360张的logits变化。这个逐样本结论来自缓存核查,不能由相同准确率直接推出。动态前向选择计算路径,这里选择统计并更新参数;两者共享模型身份,却改变不同对象。
10. 从独立 batch 到持续数据流,新风险在哪里?
episodic 每个约定单元重置;continual 让更新跨单元保留。晴天→雨天→晴天中,后一个晴天可能继承雨天的状态。batch 大小、类别是否成段、样本顺序、优化器状态是否重置都会改变实验。类别排序可用于离线压力测试,但排序所用标签不能传给在线更新策略,也不能使用未来样本调当前决策。
CoTTA 关注持续变化中的错误累积与遗忘;EATA 将样本选择、效率与遗忘问题引入适应;SAR 针对更困难的在线条件研究稳定性。这些方法不是三个无条件更好的版本号。CoTTA、EATA、SAR。在本讲 LAB 12 中,先改变一种流条件,记录模型状态、错误、熵与开销;接受“不更新更好”的结果。
11. 到 2026,应该相信哪一部分更新信号?
UnMix-TNS(ICLR 2024)让时序统计与样本混合问题继续可见;COME(ICLR 2025)追问过度自信;BITTA(ICLR 2026)在视觉语言分类适应中指出,固定比例低熵筛选可能保留自信错误,并研究如何利用不同信息的样本。它们承担不同问题,不能堆成一张未经匹配协议的 SOTA 榜。UnMix-TNS、COME、BITTA正式论文。
一个可开始的研究问题是:在相同输入流和延迟预算下,小模型适应是否胜过较大固定模型?竞争解释包括统计匹配、参数更新以及额外计算本身。对照中保留 source、norm、Tent,分别报告延迟与失败群;超参数在独立开发设置确定。若效果只在最终评价标签挑出的最佳学习率上出现,应撤回“无需目标标签即可可靠改善”的结论。
动态前向改变本次计算,TTA 改变参数或统计,拒识改变回答策略;是否保留跨样本状态还取决于协议。这一整套适应参考供研究选读;第二讲收尾另外区分固定图、部署选网、稀疏路由、共享循环与原始视觉 TTT,不把它们称为同一个算法。