CLS 07 · 设备、自动设计与动态计算
返回第二讲 · 成本、选网与动态执行 · 网页阅读版 · 第二讲导读
这本讲义从计算账本为什么不等于设备等待,走到谁在什么时候选择计算。不需要一次读完;顺着课堂正在讨论的问题选一条即可。
| 课堂问题 | 阅读位置 | 可以接着做什么 |
|---|---|---|
| 少算是否更快 | 第 1–4 节 | LAB10:比较两种 shape 的 MAC 与计时排序 |
| 设备怎样影响选网 | 第 5–8 节 | 区分成本目标、搜索空间、部署前选择 |
| 本次输入能否少算 | 第 9–10 节 | LAB11:把动态阈值与固定浅出口一起比较 |
| 路径、状态和参数谁变了 | 第 11–12 节 | 对着 MoE/Loop/TTT 图逐项指出变化对象 |
第二讲 LAB10 · 成本目标与结构选择与第二讲 LAB11 · 何时继续计算都可先读保存结果,再决定是否在自己的副本运行。Source/Norm/Tent 留在可靠性参考中,与原始视觉 TTT 的辅助任务不同。
1. 卷积究竟同时完成哪两件事?
普通卷积用每个输入通道的空间邻域共同产生每个输出通道。若核为 $k\times k$、输入通道 $M$、输出通道 $N$,忽略 bias,每个输出位置需要 $k^2MN$ 次乘加。MobileNet 的 depthwise 先在每个输入通道内做空间过滤,再用 $1\times1$ pointwise 在通道间混合;账目成为 $k^2M+MN$。MobileNet,2017。
取 $k=3,M=32,N=64$,普通卷积为 18,432 MAC,分解后是 $288+2,048=2,336$ MAC,约相差 7.89 倍。若输出有 $H_oW_o$ 个位置,再共同乘上该位置数。各自的参数数目恰等于各自每输出位置的 MAC 数;两种结构的参数数目并不相同,激活大小也不能从参数量推出。
分解限制了可表达的核形式,因此不是任意普通卷积的无损等价变形。7.89 是算术工作之比,绝不是已经测得的手机加速倍数。返回 卷积分解。
2. 为什么先扩展,又线性压回去?
MobileNetV2 的 inverted residual 先把较窄输入扩到更宽的中间通道,在其中做 depthwise 处理,再线性投影回窄空间。低维瓶颈里的非线性可能丢掉信息:例如标量 −1 与 −2 经 ReLU 都变成 0,无法从输出恢复差异。这是数学直觉,不是对真实高维数据流形的完整证明。MobileNetV2。
“线性瓶颈”不意味着整个块没有非线性,而是窄输出投影后不再加同样的截断。shortcut 也只在步幅、通道等形状条件允许时使用。复用 LAB03 的 $1\times1$ 和残差模块时,应保持这些接口明确,不能仅凭图上画一条跳线就默认可相加。
3. 少算乘法,为什么仍可能更慢?
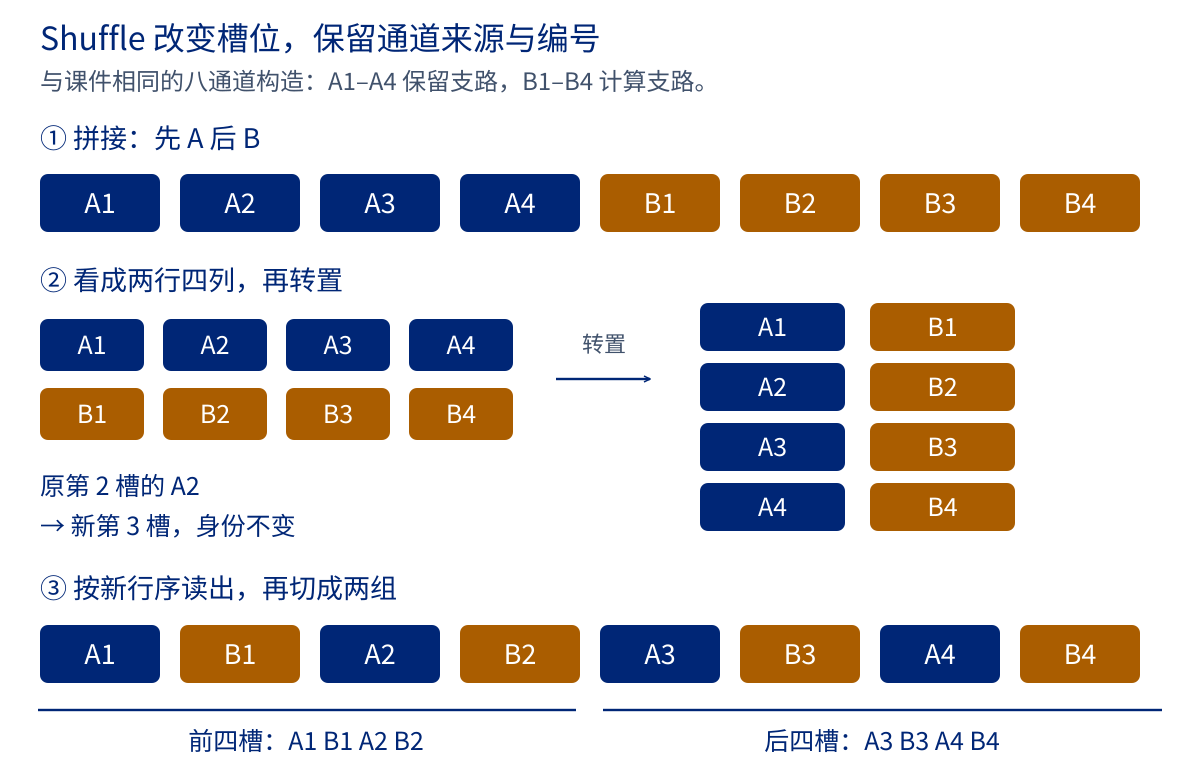
先追踪 A2。 拼接后它在第 2 槽,重排后在第 3 槽;编号与来源不变,改变的是位置。再写出下一次等分前四槽和后四槽各能接触哪些来源。
这张图解释 channel shuffle 的排列,不使用分类结果:两行分别对应支路 A、B,将 2×4 排列转置为 4×2,再按行读出。下面的吞吐表研究另一个问题——通道比例与执行效率;它不是直接测量这次排列带来多少提速。
FLOPs 或乘加次数(multiply–accumulate count)统计算术工作,设备还要读取权重、搬运激活、调度算子与同步。分支很多的网络可能把运算切碎;小算子可能无法填满硬件;逐元素算子虽然 MAC 很少,仍需读写大量数据。ShuffleNetV2 将这些因素带回网络设计。ShuffleNetV2原文。
下表保留 arXiv:1807.11164v1(2018-07-30)Sec.2、Table 1 的 GPU ×1 列:GTX 1080 Ti、cuDNN 7.0,输入空间为 $56\times56$,十个重复双 $1\times1$ 卷积块。指标为 batches/s,属于论文报告的算子微基准。Table 1 没有单独重述 batch size,因此不把 Figure 1 的 batch=8 无条件补成该表元数据;也不换算单图延迟。它与主讲采用的 ARM 列是不同设备的结果,分别读表。Table 1 版本入口。
| 输入∶输出通道比例 | 通道数 | 吞吐(batches/s) |
|---|---|---|
| 1∶1 | 128→128 | 1480 |
| 1∶2 | 90→180 | 1296 |
| 1∶6 | 52→312 | 876 |
| 1∶12 | 36→432 | 748 |
这些近似匹配算术量的配置仍有速度差异,足以反驳“只看 FLOPs 就能确定实际速度”。它没有告诉我们在当前硬件上同样会快多少。
同一张原表,不同设备列。 主讲选用 Table 1 的 ARM ×1 列:Snapdragon 810、单线程、Neon 实现,四个通道比例对应 76.2、72.9、69.1、57.6 images/s;本节上表保留 GPU ×1 列的 batches/s。两组数字的单位、设备和通道规模不同,不直接横比,也不把它们改称延迟。
术语核对:MAC 的两种词义。 ShuffleNetV2 原文的 MAC 是 memory access cost(内存访问成本);本课 LAB11 的 conv/linear MAC 是 multiply–accumulate count(卷积/线性的乘加次数)。前者描述访存,后者记算术账,不能互换。原文 Sec.2 与 Table 1。
4. 实际计时到底量了什么?
情境插画用于辨认摄像、计算与显示设备;下面的区间图不含测量值,长度也不代表耗时比例。
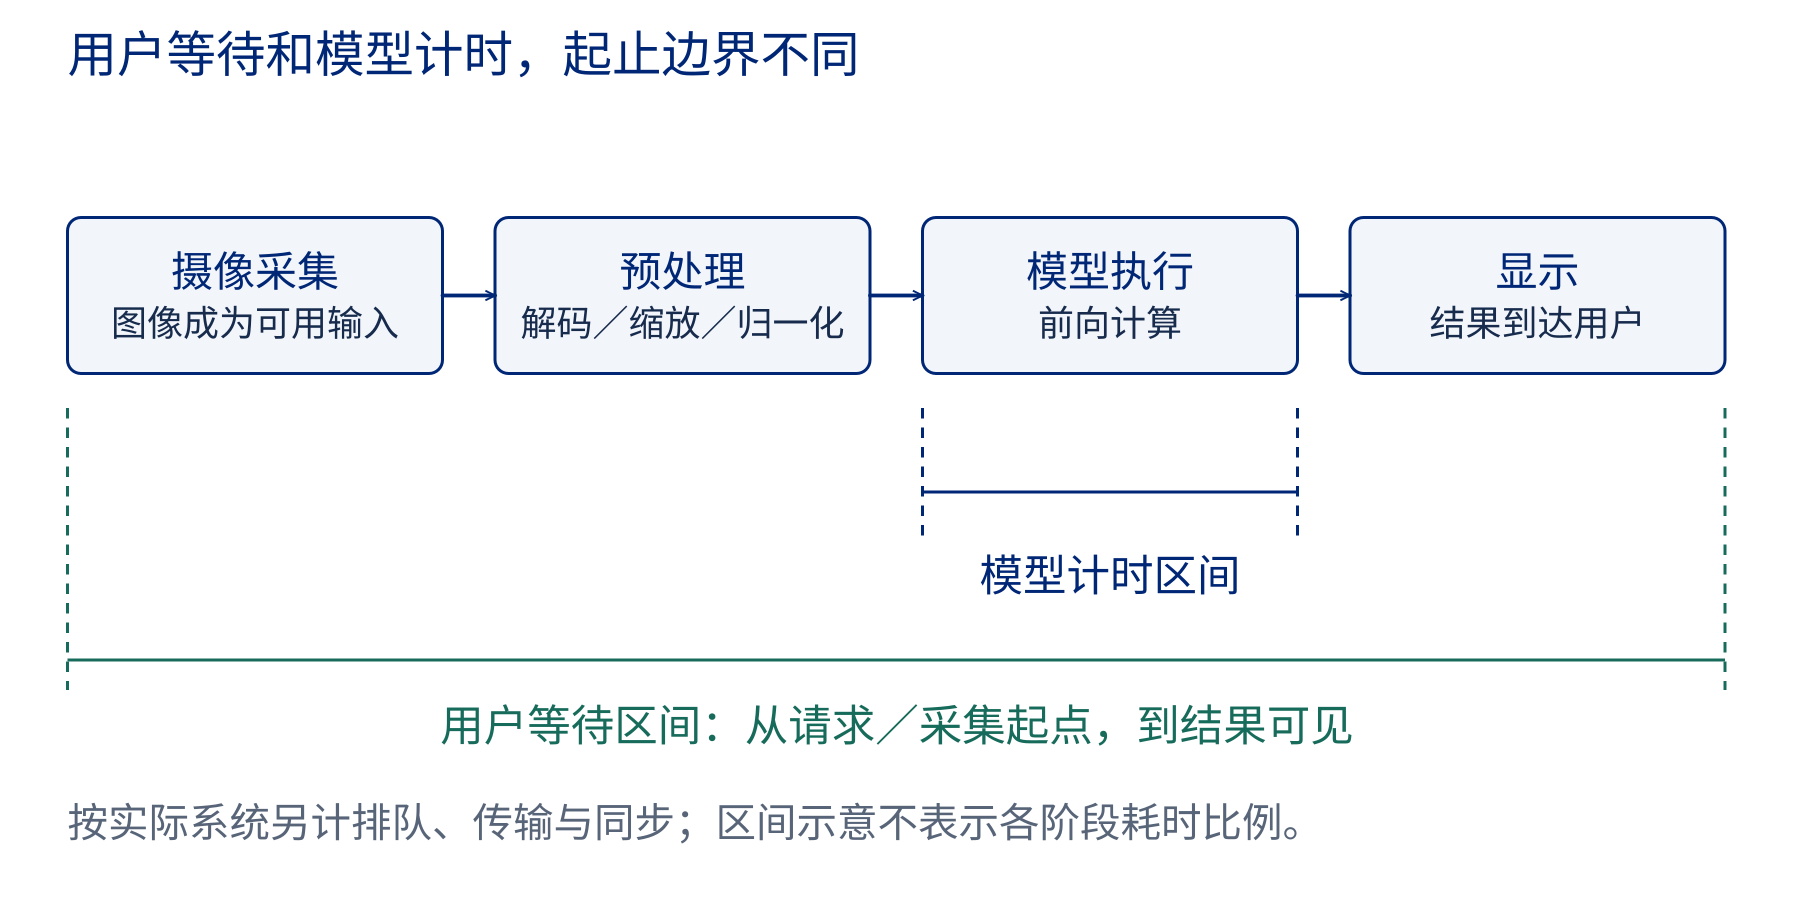
先看什么。 把模型计时的两个端点圈出来,再指出用户从哪里开始等、到哪里才得到可见结果。
改变一个条件。 若只把模型执行部分缩短,而采集、排队和显示不变,整段等待会同比缩短吗?先用区间解释,不猜具体毫秒数。
计时前写明输入 shape、batch、dtype、线程、设备、后端、warmup 次数、重复次数及同步方式。异步设备若不等待操作完成,计到的可能是提交任务时间。报告 median 与 p95 时保留重复记录,不仅写一个最小值。参数、MAC、峰值激活、延迟、能耗分别回答不同问题;没有能耗仪或可信计量就不画 J/image。
还要分开预处理、模型推理与端到端响应。用户等待包含采集、排队、传输、预处理、推理和显示,任何一段都可能成为瓶颈。本讲 LAB 10 使用实际可用设备测量并记录环境;即便在 CPU 上顺利运行,也不能改名为移动端实测。延迟分布用于比较当前条件,不是模型永久属性。
5. MobileNetV4:在指定设备上选择卷积块
MobileNetV4 的 Universal Inverted Bottleneck(UIB)把可选的空间 depthwise 操作放在通道扩展之前或扩展之后,再用 pointwise 投影回输出通道;搜索空间据此表达多种卷积块。它沿用本课空间混合与通道混合的语言。哪些组合值得用,仍取决于设备、算子实现和训练条件。MobileNetV4,ECCV 2024。
论文在指定硬件上分别报告模块与整网成本。本课未重测其设备结果。百分比必须先交代分母:某个新增模块的延迟减少比例,不等于整网或用户响应同样减少。原稿涉及 MHSA/MQA 的具体比较与数值保留在 完整历史记录,完整 Attention 机制暂存 第五讲材料。
设备约束给出成本目标后,还要确定可选网络的规模范围;这一步定义搜索能选择什么。
6. 深、宽、分辨率:先明确可用的规模旋钮
加深网络会增加串行层数;加宽会增加通道混合与激活;提高输入分辨率会扩大空间计算。三者对计算、内存和表示能力的影响不同,不能用参数量一项替代全部成本。
EfficientNet 的 compound scaling 在给定放大预算时协调深度、宽度和输入分辨率;搜索 baseline 与随后放大规模是不同步骤。EfficientNet,ICML 2019。论文经验告诉我们应比较协同扩展,而不是只把某个轴不断拉长;它不保证每台设备具有相同最优比例。
到这里,结构候选与设备目标都已明确。下一问是怎样训练、评价并选择候选:搜索算法处在这套人为定义的协议之内。
7. NAS 自动选择之前,人已经选择了什么?
一层循环给定结构 $m$ 训练参数;外层提出结构,再依据验证表现与设备成本选择下个候选。MnasNet 的软目标同时评价准确率 $ACC(m)$ 与目标设备实测延迟 $LAT(m)$:
$$R(m)=ACC(m)\left[\frac{LAT(m)}{T}\right]^{w},\qquad w=\begin{cases}\alpha,&LAT(m)\leq T,\\ \beta,&LAT(m)>T.\end{cases}$$
$T$ 是目标延迟,$\alpha,\beta$ 是人为设定的折衷强度。原文主要实验取 $\alpha=\beta=-0.07$:超出 $T$ 的候选仍有连续的 reward,不会被自动剔除。其经验依据是延迟翻倍时,约 5% 的相对准确率增益可相抵;令 $1.05\times2^\beta=1$ 得 $\beta=-\log(1.05)/\log2\approx-0.0704$。这是作者选择折衷权重的经验规则,不是所有设备与任务的定律。
在一段固定 $w$ 的区间内,$d\log R=d\log ACC+w\,d\log LAT$,说明目标比较相对变化。把它直接改成“只有 $LAT\leq T$ 才合格”会变成另一个硬约束协议。MnasNet,Sec.3、式2–3。
搜索空间、训练代理、验证划分、设备目标、搜索预算仍由研究者定义。随机搜索是有意义的基线:在相同候选空间与试验次数下,复杂策略是否真的找到更好的配置?ProxylessNAS 追问代理任务与目标执行条件的错位,MobileNetV3 体现自动搜索与人工调整可以协作;都不意味着目标一写出,人就退出研究。ProxylessNAS、MobileNetV3。返回 搜索中的两层循环。
8. OFA:部署前选网,当前输入仍执行固定子网
OFA 训练可裁出不同深度、宽度、核与分辨率子网的共享权重网络,再按部署条件选择配置。Once-for-All,ICLR 2020。
如果为手机选好子网后每张图都用它,这仍是部署阶段选型。共享权重下候选排序能否代表独立训练结果,也是需要检查的假设。不能看到“子网”就把 OFA 称为逐样本早退。返回 部署选网。
部署前已经确定的一套网络仍把所有输入送到相同深度。下一节保持任务不变,只问本次输入能否提前给出足够可靠的答案:决策时点从部署前移到了本次前向执行中。
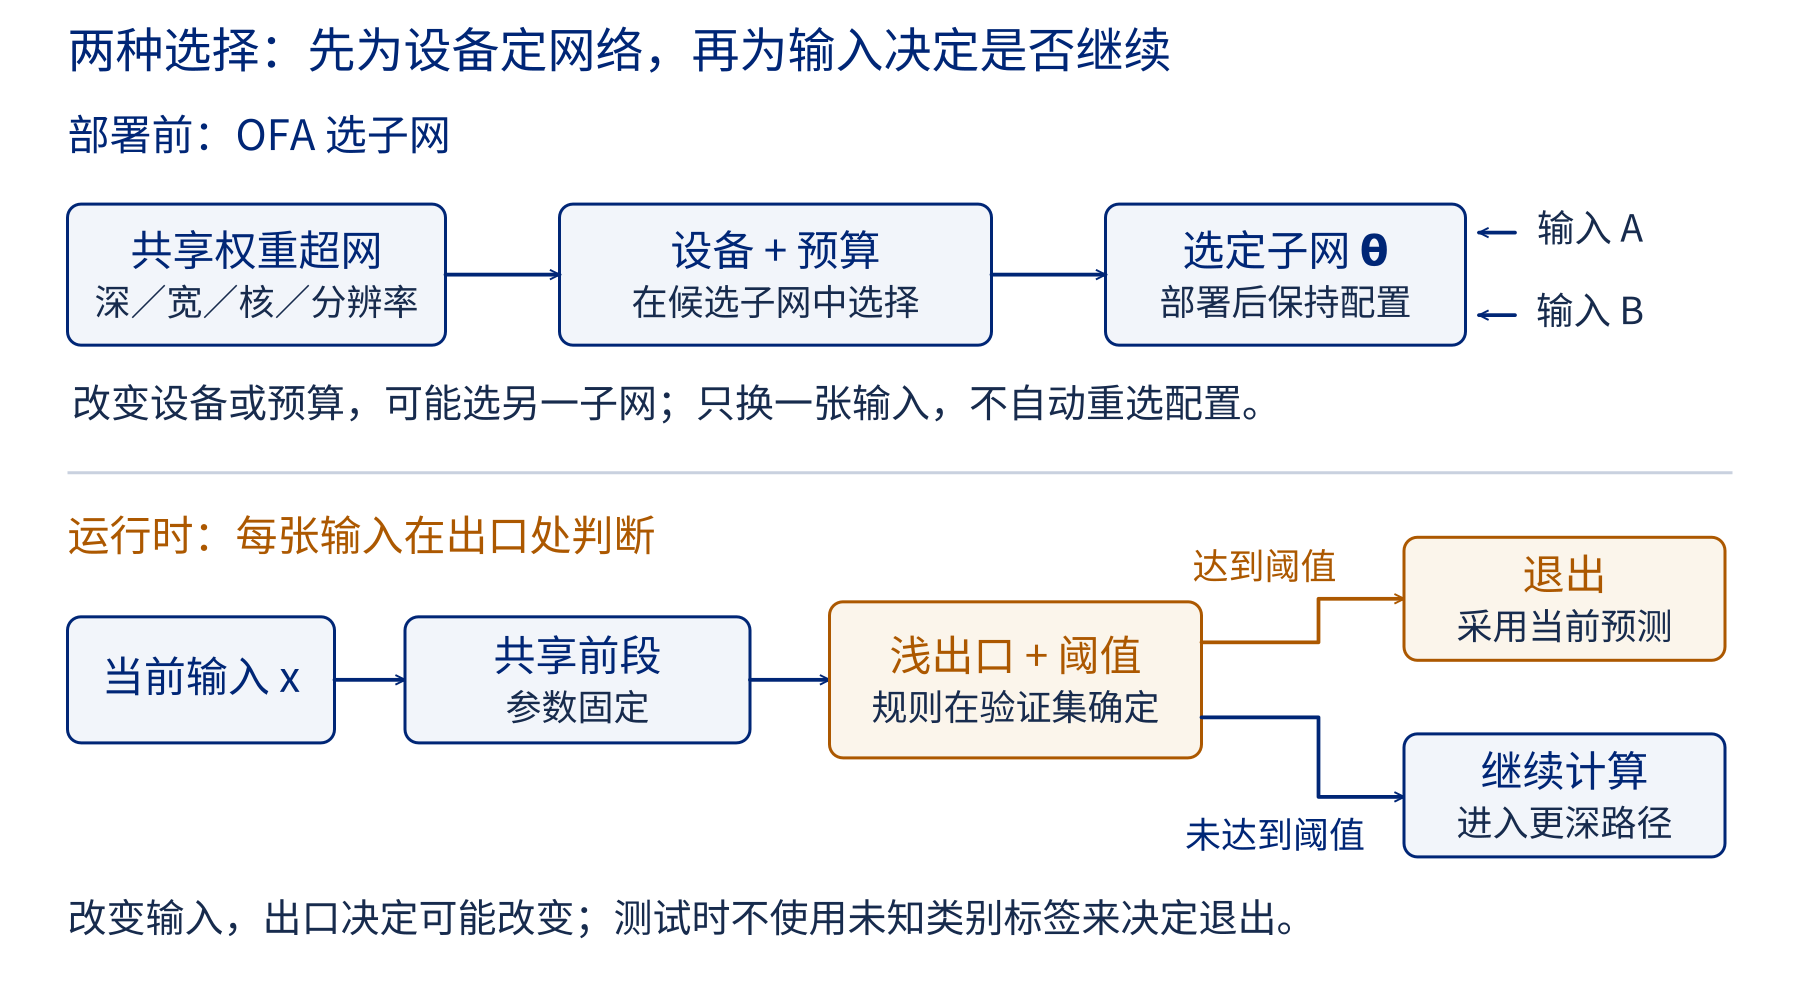
先看什么。 对照两行的决策时点:上行先选网络再接收输入,下行在本次前向过程中判断出口。
改变一个条件。 先只换设备,再只换输入。分别指出图中哪一个选择可能改变、哪一项保持固定。
9. 逐输入早退需要谁来承担错停风险?
多出口网络让中间表示也接分类头,再按规则决定停止或继续。例如用浅出口最大类别概率与阈值比较;阈值由验证集确定,在线判断不读取类别答案。MSDNet 是多出口研究的一个例子,本课的保存实验则使用下面这台独立 digits 模型。
先让最简单的基线参加比较
| 固定的 digits 测试集:360 张 | 正确数/准确率 | 每图平均 conv/linear MAC |
|---|---|---|
| 直接全深度 | 350 / 360 · 97.22% | 20032 |
| 固定浅出口 | 345 / 360 · 95.83% | 2944 |
| 验证选择的动态阈值 τ=0.50 | 345 / 360 · 95.83% | 3091.73 |
先看后两行。 动态规则在准确率相同的情况下多算了什么?请先用 LAB11 的三条路径账本解释,再谈是否值得换一种停止分数。
这次 357/360 张图早退,14 张被错停,其中 6 张若继续深出口会答对。验证选择使用“相对全深最多下降 1 个百分点”,测试却下降 1.39 个百分点;选择条件没有变成测试保证。负结果限定于这个模型、规则和成本口径,不能推成动态计算普遍无用。
实验先算出两只出口,再离线选择,因此只支持准确率与乘加账本的比较,没有真实跳过尾部的延迟证据。实际加速还需实现跳过、计入出口头、门控及调度。anytime 的“随时中断时交付当前预测”与 budgeted batch 的“分配整批预算”是不同协议,需分别说明。
10. 计算省下之后,还要检查哪一层?
一个精确但完全构造的调度例:三张图固定执行各 10 ms,总计 30 ms;按需执行为 4、8、10 ms,总工作 22 ms;再计门控与分组重排共 9 ms,总计 31 ms。它证明“少做算术”不逻辑蕴含“更短响应”,不报告任何真实硬件。真正执行还要检查并行、等待和尾延迟,不能把这个串行加法模型当完整调度器。
2021 年的动态网络综述归纳按实例、空间及时间改变计算的研究;这是综述公开时间,不是动态网络概念出生年份。本课只展开与图像识别相关的实例与空间部分。条件化参数可能随输入改变,却不必在测试时执行梯度更新。动态网络综述。
从这些成本检查出发,下面继续区分三种动作:调用哪些参数路径、同一参数执行几轮、是否根据当前输入更新参数。它们分别提出新的额外成本与验证条件。
教师示范:把早退写成可失败的研究判断
下面是一份设计示例,不是新完成的实验。它承接既有早退结果,但是否成立要靠新实现和新测量决定。
| 研究计划 | 具体写法 |
|---|---|
| 真正关心的问题 | 在固定设备、输入尺寸、batch、运行环境和数据划分下,逐输入早退能否在允许的精度损失内缩短实际等待? |
| 待检验判断 | 只有浅出口可靠地处理一部分输入,且省下的后续计算超过出口头、门控与调度开销时,早退才可能更快。事先约定精度约束,并明确主要看平均延迟还是尾延迟;不能看完结果再换指标。 |
| 最小对照 | 固定同一模型、设备和输入,比较全深度、固定浅出口与动态早退。阈值只在验证集选择;实现中必须真的跳过后续计算,不能先算全部出口再离线挑答案。 |
| 必须观察 | 同时报告精度、退出比例、平均与尾延迟,并记录浅头、门控、batch重组和调度成本。区分理论MAC减少、真实跳过计算与端到端延迟变化。 |
| 什么会使方案不成立 | 超过事先约定的精度损失;事先约定的主要延迟指标未改善,或约定的尾延迟约束被破坏;动态方案不优于固定浅出口;或者成本记录发现只是离线选答案而没有跳过计算。出现这些结果就修正判断,不把指标换成更有利的一项。 |
| 第一个里程碑 | 先在固定小批输入上跑通三个对照,检查执行轨迹确实跳过了尾部,得到同一测量范围的精度、退出比例和延迟表,再决定是否扩大实验。 |
11. 选支路与重复同一块,改变的不是同一个对象
MoE:路径身份由当前输入决定
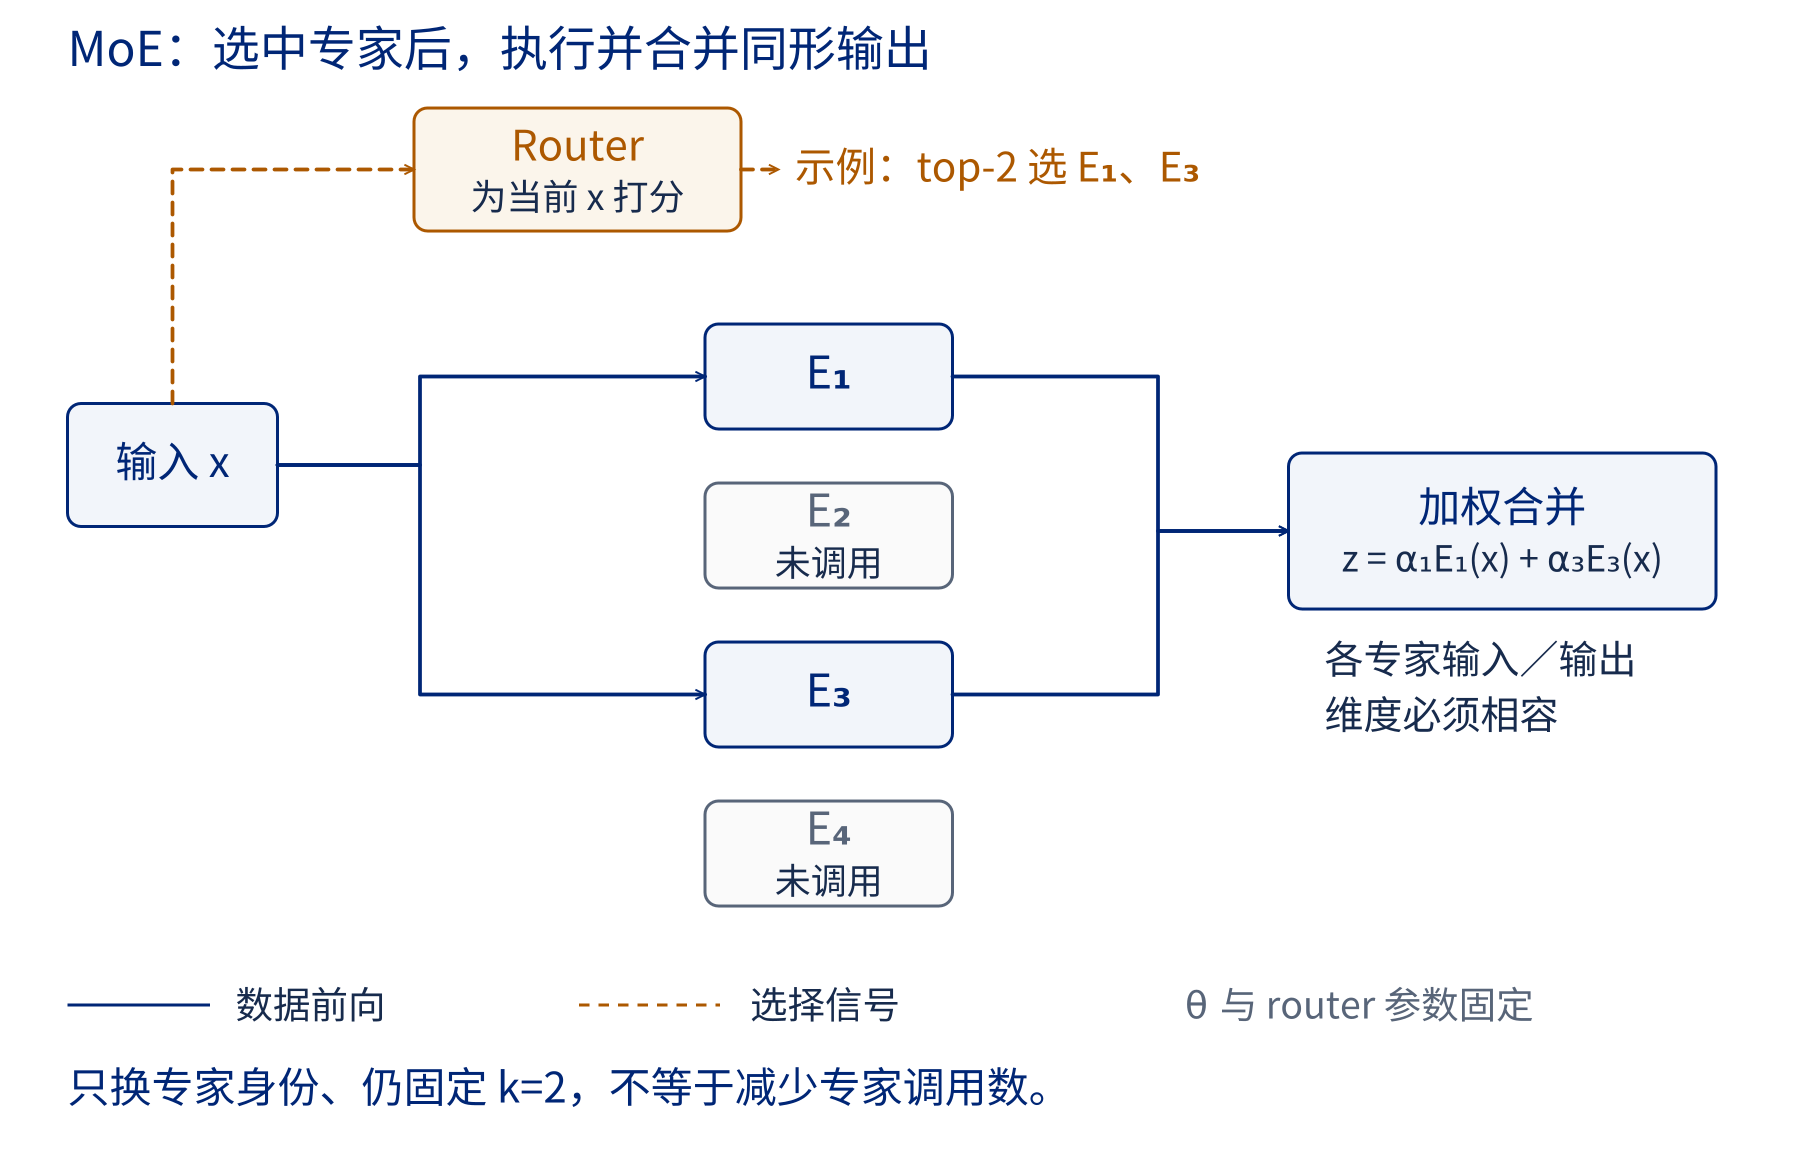
先看什么。 先按虚线找到本次选中的编号,再沿实线数清实际调用的专家;专家的输出维度必须允许加权相加。
改变一个条件。 把选中集合从 {1,3} 换成 {2,4},仍令 k=2。路径身份变了吗?专家调用数是否必然减少?
早退选择停止深度;稀疏专家层选择调用哪些专家。同一维度的表示被 router 打分后,仅送往少数专家,各专家返回同形结果,最后加权合并。未选专家可以不执行。课堂的四专家 top-2 图是精确构造,用于核对“选中→调用→合并”;它不是训练得到的语义专家证据。稀疏 MoE §2
在这样的固定 top-2 图中,输入 A 和 B 可以调用不同专家,却仍然各调用两个。所谓动态先表现在路径身份上,不能立刻推成每个输入拥有不同 MAC。V-MoE 将路由落在视觉 patch 的表示上;其归一化与 top-k 次序还与本课堂构造不同。关于 patch、容量和路由损失的细节留后续材料,不作为理解这张通用图的前置。V-MoE §2
MoE 的解释层:router 梯度与负载平衡
**router 的分数从哪里学来?**它也有参数。先看本课无噪声的 top-2 构造:对输入表示 $x$,router 产生分数 $s=xW_g$;选中集合 $S$ 中的两个分数再做 softmax,得到连续合并权重。若专家参数记为 $\theta_i$,则
$\alpha_i=\frac{\exp s_i}{\sum_{j\in S}\exp s_j}\;(i\in S),\qquad z=\sum_{i\in S}\alpha_iE_i(x;\theta_i).$
训练时把 $z$ 接分类头,与类别标签计算任务损失 $\mathcal L$。损失能沿两条路径反馈:经专家输出到被调用专家的 $\theta_i$;经连续权重 $\alpha_i$ 到 router 的 $W_g$。这里只在选中集合暂时不变的局部区域求导,并不对“选中了哪个编号”假装做连续求导。令 $q=\partial\mathcal L/\partial z$,按链式法则可得
$\frac{\partial\mathcal L}{\partial s_j}=\alpha_j\,q^\top(E_j-z),\qquad j\in S.$
这是课堂机制的局部推导:当两个专家给出的结果影响损失不同时,合并权重提供调整打分的方向;它不保证每一步梯度都非零。该样本未调用的专家不从这条任务路径得到直接反馈。分数跨过 top-2 边界时,专家身份可能跳变。若只保留一个分数再做 softmax,所选权重恒为 1,这条局部梯度就消失;这只说明本处归一化方式的边界,不能据此说所有 top-1 方法都无法训练。原文 §2.1 对 $k>1$ 的门控梯度作了说明,训练门控还加入可学习尺度的噪声;本课简图没有复现该噪声机制。稀疏 MoE §2.1
任务损失之外,还要检查谁一直没有被用到。 输入若集中到少数专家,会使训练机会和设备负载失衡。原文区分两种量:importance 是一个 batch 内各专家合并权重的总和;load 关心各专家收到的样本数。权重总和接近不代表派发数量接近,因此它分别加入 importance 与 load 的平衡项;离散计数无法直接提供普通梯度,load 项使用噪声门控下的平滑概率估计。这是该论文的训练办法,不能概括为所有 MoE 的统一配方。推理时使用学到的固定参数为当前输入选支路,并不现场重新训练 router。稀疏 MoE §4 与附录 A
Loop:共享参数,重复更新状态
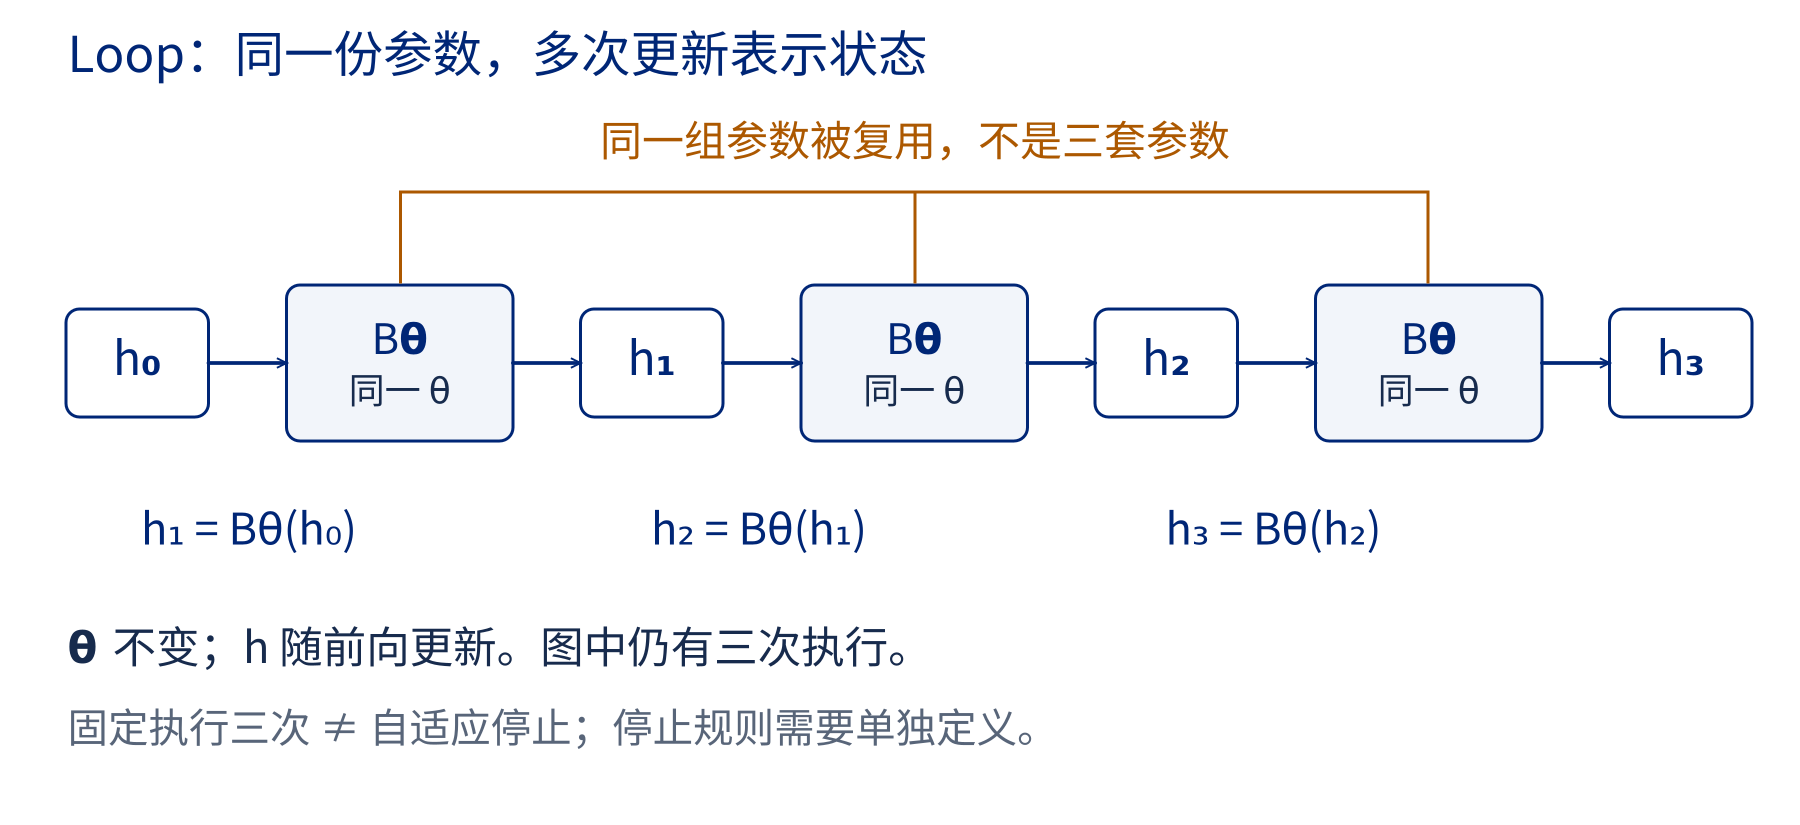
先看什么。 在三个 Bθ 框上确认 θ 是同一份,再沿 h₀→h₁→h₂→h₃ 数执行次数。
改变一个条件。 把固定三轮改为固定五轮,参数份数和执行次数各怎样变化?若希望按输入停止,还缺哪项规则?
另一种选择是不换参数,重复调用同一块:h1=Bθ(h0)、h2=Bθ(h1)、h3=Bθ(h2)。θ 是同一份,h 是三次前向产生的不同状态。把这三个框折成一个循环箭头,不会使三次运算消失。若固定循环三次,每个输入仍是三次;自适应停止需要额外规则。Huginn 是近期共享深度的语言模型例子,借用它的架构思想不等于获得视觉分类实测结论。Huginn 架构 §3
因此,设计对照时可以先用简单问题拆分解释:固定相同展开次数,比较共享与非共享参数;固定同一组共享参数,再改变执行轮数。二者不是同一次单变量比较,更不能把性能差异全部归因于“多思考了一会儿”。
12. 现场学习还需要一个反馈闭环
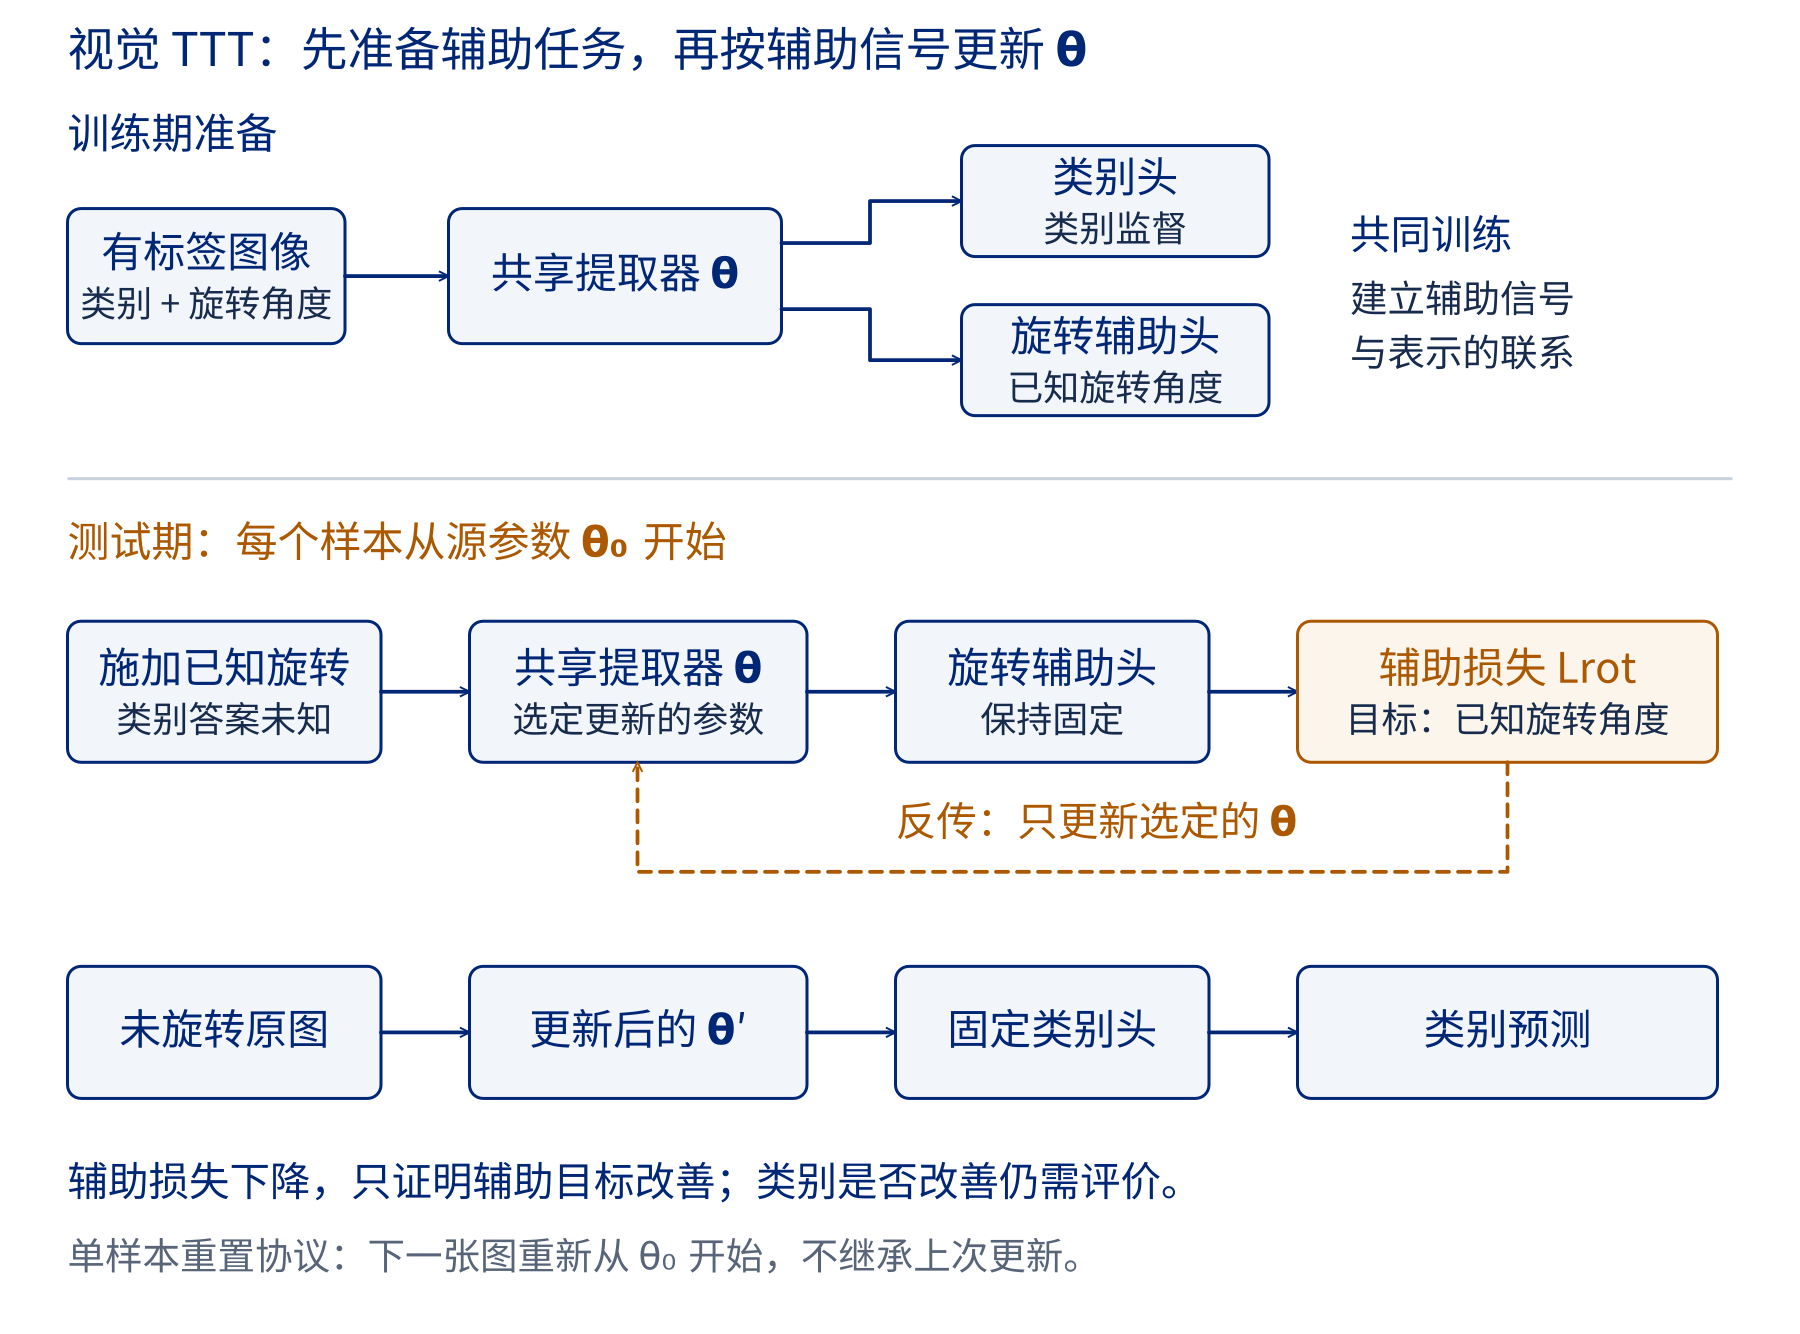
先看什么。 先看上方的训练期准备,再沿下方虚线找到测试时真正被更新的 θ;两只头保持固定。
改变一个条件。 若省去训练期的辅助任务准备,只给任意分类器临时加一个旋转头,图中哪条已建立的关系不再成立?
重复前向不必更新权重。原始视觉 TTT 则在训练期准备一个 Y 形模型:共享提取器接类别头和旋转辅助头;类别标签训练主任务,已知的旋转操作训练辅助任务。测试时类别答案不可见,但施加的旋转角度可知,于是标准协议只根据旋转损失更新共享提取器,固定两只头,再对原图分类。原始 TTT §2
这与“拿任意分类器临时装上一个旋转头”有本质差别:共享表示和辅助任务的关系在训练时已经建立。主讲采用单样本重置协议,避免暗中继承上张图的更新。评价还要同时计算更新成本、随后分类前向,以及类别是否改善。辅助损失下降只能证明代理目标改善;若目标线索与类别没有帮助,冻结源模型就可能是更合理的选择。
现在可以回收全讲的变化对象:早退改执行深度,MoE 改被调用参数的路径,Loop 改状态和重复次数,原始视觉 TTT 改选定参数。前三者的通用推理图不需要参数梯度更新;TTT 的图包含反向传播。它们可以组合,但组合之后更需要知道哪个环节解释了结果。
研究选读:相似名称,可能在更新不同对象
TTT layers(2024)在序列层内部用小模型权重充当 hidden state,用学习步骤更新这份状态;它与上述分类适应不是同一问题设置。TTT layers §2.1 In-Place TTT(2026)进一步研究 fast weights 放在哪里、目标怎样服务下一词预测。In-Place TTT DeepLoop(2026)检查共享参数被反复访问时的训练稳定性和缩放。DeepLoop v2 这些工作只说明设计问题仍在推进,不为本课程的构造图提供未经运行的性能保证。
用四句话收束本册。 固定一个识别任务,写出:我允许改变的对象是____;与基线比较;期待改善指标;若出现____结果,就撤回或修改判断。
可以先用本册已有图回答:MoE 的选中专家、Loop 的中间状态和 TTT 的选定参数,哪一个需要在测试时求参数梯度?请以图中的连线与更新位置为依据。
选读去向:第五讲的图像 token 路径
DynamicViT 与 MoNE 的完整 token 机制、原论文数值与条件保存在 第五讲暂存 / 动态研究参考。它们不作为第二讲主线的 Attention 前置。
关键边界仍保留:给定固定保留比例时,动态的可能是哪些 token,而非每张图的 token 数;论文吞吐、单请求延迟和精确教学构造不能互相替代。v16 完整归档。