返回第二讲 · 成本目标与结构选择 · 网页阅读版 · 第二讲导读
MAC 更少,会在当前设备上更快吗? 先用两种 shape 的真实算子结果检验直觉,再让六个训练候选在不同成本目标下参加选择。
| 课堂中可选一项 | 怎样做 | 留下一句什么解释 |
|---|---|---|
| 不运行,读图讨论 | 第 1 节内逐组比较 standard 与 dw+pw | 为什么同一种分解的延迟排序会翻转 |
| 不重训,改选择规则 | 第 2 节保存表:只改允许的延迟上限 | 可行集为何改变;没有候选时怎么办 |
| 在自己的副本重跑 | 顺序运行;计时或重训另行选择 | 新设备/新运行与保存结果哪些一致、哪些不同 |
算子部分是 PyTorch CPU 微基准,随机权重用于计时与算术核对;候选部分是 sklearn digits 上的六个实际训练小网络。两者各回答一个问题,不能把算子微基准当成分类精度实验,也不把 CPU 结果称为手机实测。
保存输出来自 2026-09-18。依赖为 numpy torch scikit-learn matplotlib,不需其他 Notebook 内存或下载 checkpoint。运行会写入 outputs/LAB12-C;这是历史实验路径,学生材料编号仍为 LAB10。
先读这次保存运行,再作预测
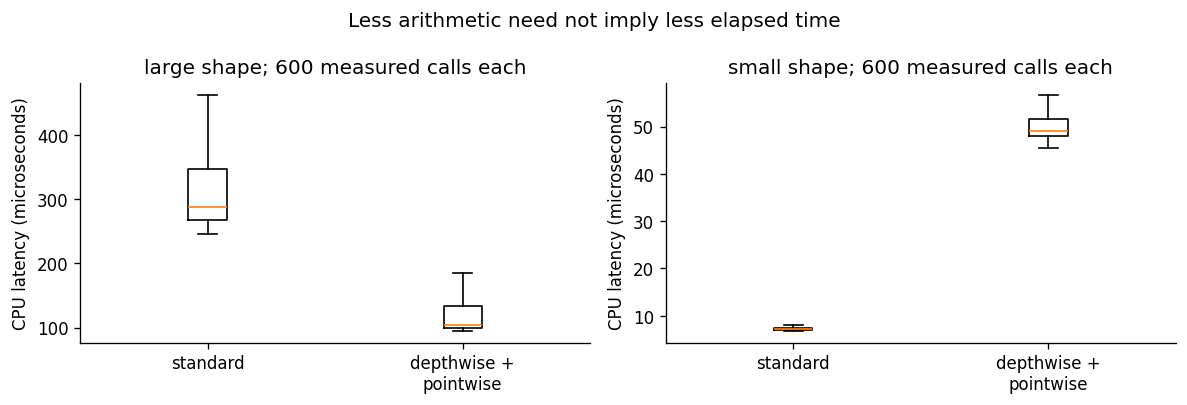
同一台 CPU、同样的组内 shape:大组 depthwise+pointwise 的中位数为 104.40 μs,标准卷积为 287.88 μs;小组则分别为 48.98 与 7.22 μs。更少 MAC 在两种 shape 下没有给出同一种延迟关系。 六个实际训练候选的验证—延迟表会继续检验:成本目标改变后,你还会选同一个模型吗?
以上是教师保存的本地结果;重新计时会随设备和负载变化,以新输出为准。
1. 固定计时范围,再看账本
每组 batch=1,NCHW float32,stride=1,same padding,无 bias;CPU 同步调用。固定 PyTorch 为 1 线程、eval、inference_mode;输入与权重创建排除,Python 调用、算子、输出分配包含。warmup 30 次,3 轮×200 次,轮间随机候选次序。记录每次延迟,报告 p10/p50/p90;共享主机环境不能被解释为独占设备性能。
每次乘加记作 1 MAC。标准核参数为 $9MN$,分解为 $9M+MN$;MAC 再乘 $HW$。激活账本记录输入、输出及 depthwise 中间张量的 float32 字节,不是峰值内存实测。两类模块一般函数族不同;先构造可分解核来核对其计算关系。
查看代码 · 单元 4
LAB_ID='LAB12-C'

from pathlib import Path
from copy import deepcopy
import csv, hashlib, json, platform, sys, time
import numpy as np
import torch
from torch import nn
import torch.nn.functional as F
import sklearn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt
SEED = 20260918
np.random.seed(SEED); torch.manual_seed(SEED)
torch.set_num_threads(1)
torch.use_deterministic_algorithms(True)
OUTPUT = Path('outputs') / LAB_ID
OUTPUT.mkdir(parents=True, exist_ok=True)
plt.rcParams.update({'figure.dpi':120, 'font.size':10, 'axes.spines.top':False, 'axes.spines.right':False})
def save_json(name, obj):
    (OUTPUT/name).write_text(json.dumps(obj,ensure_ascii=False,indent=2))
def save_csv(name, rows):
    with (OUTPUT/name).open('w',newline='') as f:
        w=csv.DictWriter(f, fieldnames=list(rows[0])); w.writeheader(); w.writerows(rows)
def digest_array(a): return hashlib.sha256(np.ascontiguousarray(a).tobytes()).hexdigest()
def print_table(rows, cols=None):
    cols=cols or list(rows[0]); print(' | '.join(cols)); print(' | '.join(['---']*len(cols)))
    for row in rows:
        print(' | '.join(f'{row[c]:.5f}' if isinstance(row[c],float) else str(row[c]) for c in cols))
cpu_lines=Path('/proc/cpuinfo').read_text().splitlines() if Path('/proc/cpuinfo').exists() else []
cpu_name=next((line.split(':',1)[1].strip() for line in cpu_lines if line.startswith('model name')),platform.processor())
environment={'python':sys.version.split()[0],'torch':torch.__version__,'numpy':np.__version__,
             'sklearn':sklearn.__version__,'cpu':cpu_name,'platform':platform.platform(),
             'torch_threads':torch.get_num_threads(),'device':'cpu','dtype':'float32',
             'seed':SEED,'exclusive_hardware':False}
save_json('environment.json',environment)
print(json.dumps(environment,ensure_ascii=False,indent=2))
已保存的运行输出
{
  "python": "3.12.14",
  "torch": "2.14.0+cpu",
  "numpy": "2.3.5",
  "sklearn": "1.8.0",
  "cpu": "INTEL(R) XEON(R) PLATINUM 8573C",
  "platform": "Linux-6.18.44-x86_64-with-glibc2.39",
  "torch_threads": 1,
  "device": "cpu",
  "dtype": "float32",
  "seed": 20260918,
  "exclusive_hardware": false
}
查看代码 · 单元 5
WARMUP,REPEATS,ROUNDS=30,200,3
rng=np.random.default_rng(SEED)
def modules_for(m,n):
    standard=nn.Conv2d(m,n,3,padding=1,bias=False).eval()
    decomposed=nn.Sequential(nn.Conv2d(m,m,3,padding=1,groups=m,bias=False),nn.Conv2d(m,n,1,bias=False)).eval()
    return {'standard':standard,'dw_pw':decomposed}
# Exact constructed factorable kernel, not a claim about arbitrary standard kernels.
small=modules_for(2,3); sx=torch.randn(1,2,4,4)
with torch.no_grad():
    dw,pw=small['dw_pw'][0].weight,small['dw_pw'][1].weight
    small['standard'].weight.copy_(pw[:,:,0,0][:,:,None,None]*dw[:,0][None,:,:,:])
    max_error=(small['standard'](sx)-small['dw_pw'](sx)).abs().max().item()
assert max_error < 1e-5
print('Factorable-kernel numerical check; max absolute error =',max_error)

def benchmark_group(modules,x):
    samples={name:[] for name in modules}
    with torch.inference_mode():
        for module in modules.values():
            for _ in range(WARMUP): module(x)
        for run in range(ROUNDS):
            for name in rng.permutation(list(modules)):
                module=modules[name]
                for repeat in range(REPEATS):
                    start=time.perf_counter_ns(); module(x); duration=time.perf_counter_ns()-start
                    samples[name].append({'round':run,'repeat':repeat,'latency_us':duration/1000})
    return samples
operator_rows=[]; raw_operator=[]
for case,m,n,h in [('large',32,64,32),('small',4,16,4)]:
    x=torch.randn(1,m,h,h); modules=modules_for(m,n); samples=benchmark_group(modules,x)
    for name,module in modules.items():
        values=[r['latency_us'] for r in samples[name]]
        params=sum(p.numel() for p in module.parameters())
        row={'case':case,'module':name,'input_shape':str(list(x.shape)),'output_shape':str([1,n,h,h]),
             'params':params,'mac':params*h*h,'activation_ledger_bytes':4*h*h*(m+n+(m if name=='dw_pw' else 0)),
             'p10_us':float(np.percentile(values,10)),'median_us':float(np.median(values)),'p90_us':float(np.percentile(values,90))}
        operator_rows.append(row)
        for r in samples[name]: raw_operator.append({'case':case,'module':name,**r})
save_csv('operator-costs.csv',operator_rows); save_csv('operator-timings.csv',raw_operator)
save_json('benchmark-protocol.json',{'warmup':WARMUP,'repetitions':REPEATS,'rounds':ROUNDS,'layout':'NCHW',
  'scope':'Python call, operator and output allocation; inputs and weights precreated','synchronization':'CPU synchronous',
  'activation_ledger':'input+output+depthwise intermediate, NOT peak-memory measurement'})
print_table(operator_rows,['case','module','params','mac','activation_ledger_bytes','median_us','p10_us','p90_us'])
已保存的运行输出
Factorable-kernel numerical check; max absolute error = 1.4901161193847656e-07
case | module | params | mac | activation_ledger_bytes | median_us | p10_us | p90_us
--- | --- | --- | --- | --- | --- | --- | ---
large | standard | 18432 | 18874368 | 393216 | 287.88050 | 262.55580 | 428.06910
large | dw_pw | 2336 | 2392064 | 524288 | 104.39850 | 97.93900 | 207.23840
small | standard | 576 | 9216 | 1280 | 7.21700 | 6.99890 | 7.79340
small | dw_pw | 100 | 1600 | 1536 | 48.97550 | 47.31290 | 86.28150
查看代码 · 单元 6
fig,axs=plt.subplots(1,2,figsize=(10,3.4))
for ax,case in zip(axs,['large','small']):
    vals=[[r['latency_us'] for r in raw_operator if r['case']==case and r['module']==name] for name in ['standard','dw_pw']]
    ax.boxplot(vals,tick_labels=['standard','depthwise +\npointwise'],showfliers=False)
    ax.set(ylabel='CPU latency (microseconds)',title=case+' shape; 600 measured calls each')
fig.suptitle('Less arithmetic need not imply less elapsed time',fontsize=12)
fig.tight_layout(); fig.savefig(OUTPUT/'operator-latencies.png'); plt.show()
for case in ['large','small']:
    a,b=[r for r in operator_rows if r['case']==case]
    print(case,': MAC ratio DW/PW / standard =',round(b['mac']/a['mac'],3),
          '; measured median ratio =',round(b['median_us']/a['median_us'],3))
已保存的运行输出
large : MAC ratio DW/PW / standard = 0.127 ; measured median ratio = 0.363
small : MAC ratio DW/PW / standard = 0.174 ; measured median ratio = 6.786
Matplotlib figure
先在每一组内部比较,再看是否翻转。 大组分解后 MAC 约为标准卷积的 0.127 倍、中位延迟约为 0.363 倍;小组 MAC 约为 0.174 倍,中位延迟却约为 6.786 倍。两组输出接口各自保持相同,但组间 shape 不同。
同桌讨论。 一人只拿 MAC 预测排序,另一人只读保存计时。把分歧写成一个可检验解释:算子实现、额外调用、中间张量或小算子的固定开销,哪一项值得再隔离?当前比较不能唯一确定责任来自内存,也不能推成 MobileNet 无效。
你应带走的判断是:MAC 比值不能直接换成延迟比值,硬件与 shape 是解释的一部分。
2. 用同一小候选集检验选择目标
六个实际训练的数字分类器:共同 stem 是 1→8 的 3×3 卷积;第二模块为 standard 或 depthwise+pointwise,宽度 8/16/32;池化后接分类头。每个候选训练 18 轮,Adam 0.003,batch 64,固定源训练数据、划分与训练顺序;以本候选的验证 CE 最低 checkpoint 评价。宽度和结构改变了模型容量,18 轮并不意味着等训练计算。一个 seed 不能决定普遍最优架构。
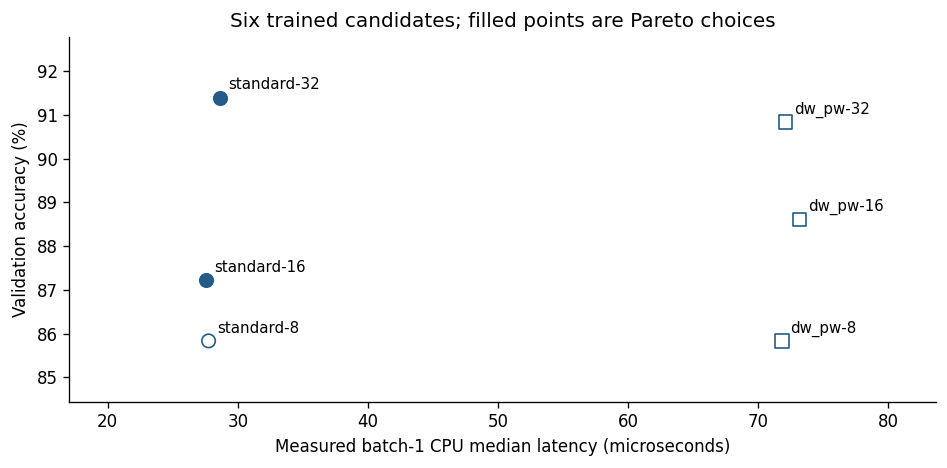
选择规则预先定义为:①验证准确率最高;②验证准确率不低于人工基线 standard-16,且单图中位延迟不超过该基线时,选延迟最小者;③随机种子固定、只抽两个候选,用同样约束选择。若约束内无候选,明确回退人工基线。测试标签不用于选择。候选计时固定取测试集首图,不读取其标签;这些网络使用固定 shape 的静态算子,这一步不依据图像内容选择计算路径。本次中位延迟只是点估计,若候选的延迟分布重叠,不能据细小中位数差距宣称稳定排名;这里保留本次测量作选择规则演示。这里演示小规模枚举与成本目标,不复现 MnasNet 的软目标。
查看代码 · 单元 8
dataset = load_digits()
X = torch.tensor(dataset.images[:,None,:,:] / 16.0, dtype=torch.float32)
y = torch.tensor(dataset.target, dtype=torch.long)
all_ids = np.arange(len(y))
trainval_ids, test_ids = train_test_split(all_ids, test_size=0.2, random_state=SEED, stratify=y.numpy())
train_ids, val_ids = train_test_split(trainval_ids, test_size=0.25, random_state=SEED, stratify=y.numpy()[trainval_ids])
assert not (set(train_ids)&set(val_ids) or set(train_ids)&set(test_ids) or set(val_ids)&set(test_ids))
assert len(train_ids)+len(val_ids)+len(test_ids)==len(y)
split_manifest={'dataset':'sklearn.datasets.load_digits; 1797 real 8x8 images; pixel/16',
                'counts':{'train':len(train_ids),'validation':len(val_ids),'test':len(test_ids)},
                'train_ids':train_ids.tolist(),'validation_ids':val_ids.tolist(),'test_ids':test_ids.tolist(),
                'input_sha256':digest_array(X.numpy()),'labels_sha256':digest_array(y.numpy()),
                'split_policy':'stratified random by sample, NOT writer-disjoint', 'test_labels':'evaluation only'}
save_json('split-manifest.json',split_manifest)
print('Split:',split_manifest['counts'])
已保存的运行输出
Split: {'train': 1077, 'validation': 360, 'test': 360}
查看代码 · 单元 9
class Candidate(nn.Module):
    def __init__(self,kind,width):
        super().__init__(); self.stem=nn.Conv2d(1,8,3,padding=1,bias=False)
        self.module=(nn.Conv2d(8,width,3,padding=1,bias=False) if kind=='standard' else
                     nn.Sequential(nn.Conv2d(8,8,3,padding=1,groups=8,bias=False),nn.Conv2d(8,width,1,bias=False)))
        self.head=nn.Linear(width*2*2,10)
    def forward(self,x):
        x=F.avg_pool2d(F.relu(self.stem(x)),2)
        x=F.avg_pool2d(F.relu(self.module(x)),2)
        return self.head(x.flatten(1))
models={}; search_rows=[]
for kind in ['standard','dw_pw']:
    for width in [8,16,32]:
        torch.manual_seed(SEED); model=Candidate(kind,width); opt=torch.optim.Adam(model.parameters(),lr=.003)
        generator=torch.Generator().manual_seed(SEED+10)
        best_loss=float('inf'); best=None
        for epoch in range(18):
            model.train()
            ids=torch.tensor(train_ids)[torch.randperm(len(train_ids),generator=generator)]
            for batch in ids.split(64):
                opt.zero_grad(set_to_none=True); loss=F.cross_entropy(model(X[batch]),y[batch]); loss.backward(); opt.step()
            model.eval()
            with torch.no_grad(): vl=F.cross_entropy(model(X[val_ids]),y[val_ids]).item()
            if vl<best_loss: best_loss=vl; best=deepcopy(model.state_dict())
        model.load_state_dict(best); model.eval(); name=f'{kind}-{width}'; models[name]=model
        with torch.inference_mode(): va=(model(X[val_ids]).argmax(1)==y[val_ids]).float().mean().item()
        params=sum(p.numel() for p in model.parameters())
        mac=64*9*8 + (16*9*8*width if kind=='standard' else 16*(9*8+8*width)) + width*4*10
        search_rows.append({'name':name,'validation_acc':va,'params':params,'mac':mac})
search_samples=benchmark_group(models,X[test_ids[:1]])  # shape-only input; labels unused
for row in search_rows:
    values=[s['latency_us'] for s in search_samples[row['name']]]
    row.update({'median_us':float(np.median(values)),'p10_us':float(np.percentile(values,10)),
                'p90_us':float(np.percentile(values,90))})
save_csv('candidate-latency-samples.csv',[{'name':name,**sample} for name,ss in search_samples.items() for sample in ss])
base=next(r for r in search_rows if r['name']=='standard-16')
feasible=lambda r:r['validation_acc']>=base['validation_acc']-1e-9 and r['median_us']<=base['median_us']
accuracy_best=max(search_rows,key=lambda r:(r['validation_acc'],-r['median_us']))
cost_best=min([r for r in search_rows if feasible(r)],key=lambda r:r['median_us'])
random_names=np.random.default_rng(SEED+33).choice([r['name'] for r in search_rows],size=2,replace=False).tolist()
random_pool=[r for r in search_rows if r['name'] in random_names and feasible(r)]
random_best=min(random_pool,key=lambda r:r['median_us']) if random_pool else base
selections={'manual_baseline':base['name'],'validation_accuracy':accuracy_best['name'],
            'latency_under_baseline_quality_and_cost':cost_best['name'],
            'random_two_under_same_constraints':random_best['name'],'random_two_names':random_names,
            'random_fallback_to_baseline':not bool(random_pool)}
# Selection has finished. Only now calculate held-out test accuracy for all candidates, including nonwinners.
for row in search_rows:
    with torch.inference_mode(): row['test_acc']=(models[row['name']](X[test_ids]).argmax(1)==y[test_ids]).float().mean().item()
    row['pareto_validation_latency']=not any(other['validation_acc']>=row['validation_acc'] and other['median_us']<=row['median_us']
        and (other['validation_acc']>row['validation_acc'] or other['median_us']<row['median_us']) for other in search_rows)
save_csv('candidate-results.csv',search_rows); save_json('selection.json',selections)
print_table(search_rows); print(json.dumps(selections,indent=2))
已保存的运行输出
name | validation_acc | params | mac | median_us | p10_us | p90_us | test_acc | pareto_validation_latency
--- | --- | --- | --- | --- | --- | --- | --- | ---
standard-8 | 0.85833 | 978 | 14144 | 27.74550 | 26.08980 | 32.96370 | 0.86667 | False
standard-16 | 0.87222 | 1874 | 23680 | 27.54500 | 26.45460 | 32.74040 | 0.87500 | True
standard-32 | 0.91389 | 3666 | 42752 | 28.62950 | 27.48390 | 35.64700 | 0.91667 | True
dw_pw-8 | 0.85833 | 538 | 7104 | 71.81250 | 67.92580 | 141.54630 | 0.83333 | False
dw_pw-16 | 0.88611 | 922 | 8448 | 73.15950 | 68.69840 | 115.70850 | 0.87778 | False
dw_pw-32 | 0.90833 | 1690 | 11136 | 72.10000 | 68.48600 | 113.16090 | 0.88889 | False
{
  "manual_baseline": "standard-16",
  "validation_accuracy": "standard-32",
  "latency_under_baseline_quality_and_cost": "standard-16",
  "random_two_under_same_constraints": "standard-16",
  "random_two_names": [
    "standard-32",
    "dw_pw-16"
  ],
  "random_fallback_to_baseline": true
}
查看代码 · 单元 10
fig,ax=plt.subplots(figsize=(8,4))
for r in search_rows:
    ax.scatter(r['median_us'],100*r['validation_acc'],s=65,marker='o' if r['name'].startswith('standard') else 's',
               facecolors='#255b87' if r['pareto_validation_latency'] else 'none',edgecolors='#255b87')
    ax.annotate(r['name'],(r['median_us'],100*r['validation_acc']),xytext=(5,5),textcoords='offset points',fontsize=9)
ax.set(xlabel='Measured batch-1 CPU median latency (microseconds)',ylabel='Validation accuracy (%)',
       title='Six trained candidates; filled points are Pareto choices')
ax.margins(x=.23,y=.25); fig.tight_layout(); fig.savefig(OUTPUT/'candidate-pareto.png'); plt.show()
已保存的运行输出
Matplotlib figure
3. 改一个条件,写下可被反驳的解释
活动 A:只改选择条件,不训练
用上方六行保存结果,保持模型、验证准确率和计时不变。人工基线 standard-16 的验证准确率为 87.222%、中位延迟为 27.545 μs。
- 把延迟上限设为基线的 0.8 倍,同时要求验证准确率不低于基线。先圈出可行候选。
- 只把上限改为 1.2 倍,再圈一次。分别按“可行集内延迟最低”和“可行集内验证准确率最高”选择,二者是否相同?
- 写下一个可行集为空时的处理规则,不使用测试列来放宽条件。
核对思路。 0.8 倍为 22.036 μs,保存表中没有可行候选;1.2 倍为 33.054 μs,可行的是 standard-16 与 standard-32。最低延迟选择前者,最高验证准确率选择后者。目标不同,答案可以不同。代码原协议在无可行候选时回退人工基线;它不意味着基线满足新的更严约束,报告时要明确“约束未满足”。
活动 B:只改执行条件,重新计时
在已完成前面初始化与模型构造的副本中,将 batch=1 改成 batch=16;保持设备、dtype、线程与计时范围。先决定报告单批延迟还是 images/s,再测量。现有保存结果没有回答这个新条件。
若继续研究结构质量,另设多 seed、预算或规模对照;本册一个 seed 的候选结果不足以决定普遍最优架构。
来源:PyTorch Conv2d、digits 数据、MobileNet。算术核对、CPU 重复计时和六候选训练来自历史保存运行;未测手机、能耗或端到端交互。
返回第二讲 · 搜索目标与选择 · 网页阅读版与保存结果 · 下载 Lecture02-LAB10.ipynb · 课程导读