CLS 06 · 现代骨干与公平比较
返回第二讲 · 连接方式与公平比较 · 网页阅读版 · 第二讲导读
这本讲义回答两个相连的问题:网络怎样组织已有特征;怎样判断新结构的收益。 课堂上可以先读第 2 节相加/拼接,再读第 4–5 节 ConvNeXt 接口与配方控制;第 6 节 GRN 是按需参考。
| 现在想弄清什么 | 去哪里 | 读完做一个动作 |
|---|---|---|
| 相加与拼接留下什么信息 | 第 2 节 | 给两路输入写出输出通道数 |
| ConvNeXt 在哪里混合空间与通道 | 第 4 节 | 指出 C→4C→C 及恒等相加的接口 |
| 成绩变化能否归因于结构 | 第 5、7 节 | 把改变和保持的条件分开,再写结论 |
无需运行代码即可完成这些观察。要检验设备成本,转到 第二讲 LAB10 · 成本目标与结构选择。预训练目标与表示迁移继续见第三讲;完整 Attention 保留在后续选读区。
1. 残差之后,为什么还要问特征复用?
残差块写为 $y=x+F(x)$。如果输入与输出形状相同,恒等通路把已有表示直接送到输出,分支负责学习增量;形状不同时需明确投影或下采样。它改变优化和信息传递条件,并不保证任意深网络都容易训练。ResNet 首次预印本是 2015 年,正式论文是 CVPR 2016,两个年份描述的是同一工作的不同公开阶段。首稿记录、CVPR 2016正式入口。
旧表示既然不必每层重建,另一个自然问题是:后面的层能否直接读取多个早先表示,而不是只接收它们的和?DenseNet 用通道拼接回答。它不是 ResNet 必然演化到的终点,而是同期对信息访问方式的另一种探索。DenseNet:2016预印本/CVPR 2017。
2. 相加和拼接保留的接口不同
设两个张量都是 $H\times W\times C$。逐元素相加仍是 $H\times W\times C$;通道拼接成为 $H\times W\times2C$。若两个位置值分别是 $(1,2)$ 与 $(3,4)$,和为 $(4,6)$,无法仅由和恢复两份来源;拼接为 $(1,2,3,4)$,后续算子还能选择分别访问。这个算例解释信息组织,不证明拼接必然提高泛化。
Dense block 第 $l$ 层读取 $[x_0,x_1,\ldots,x_{l-1}]$,若每层新增 $k$ 个通道,输入通道数随深度增长。参数可以因较小的增长率而节省,但保存或拼接激活仍有内存代价。不要从参数量直接推训练峰值内存。返回 相加与拼接动画。
先遮住答案做接口检查。 两路都是 14×14×64:相加与拼接各得到什么形状?若后一层是 1×1、输出 32 通道,不计 bias,哪条路径的参数更多?
核对思路。 相加得到 14×14×64,后接参数为 64×32;拼接得到 14×14×128,后接参数为 128×32。这里固定的是空间尺寸与输出通道;多出的通道会进入下一算子的账本。不要只数当前的加号或拼接符号。
3. 并行分支与多个 filter 有什么不同?
Inception 的同一个输入进入四条包含运算的路径:1×1;1×1 降维后 3×3;1×1 降维后 5×5;3×3 pooling 后 1×1。四路都执行,空间尺寸对齐后沿通道拼接。一个卷积层中的多个 filter 并不自动构成这四条路径。
LAB05 的精确 shape 核对以 1×192×14×14 为输入,四路分别输出64、128、32、32通道,拼接得到1×256×14×14。1×1 降维放在较昂贵的3×3/5×5之前。这里是结构与形状核对,不是原论文性能复现。Inception,2014预印本/CVPR2015。
4. 读一个 ConvNeXt block:逐步守住接口
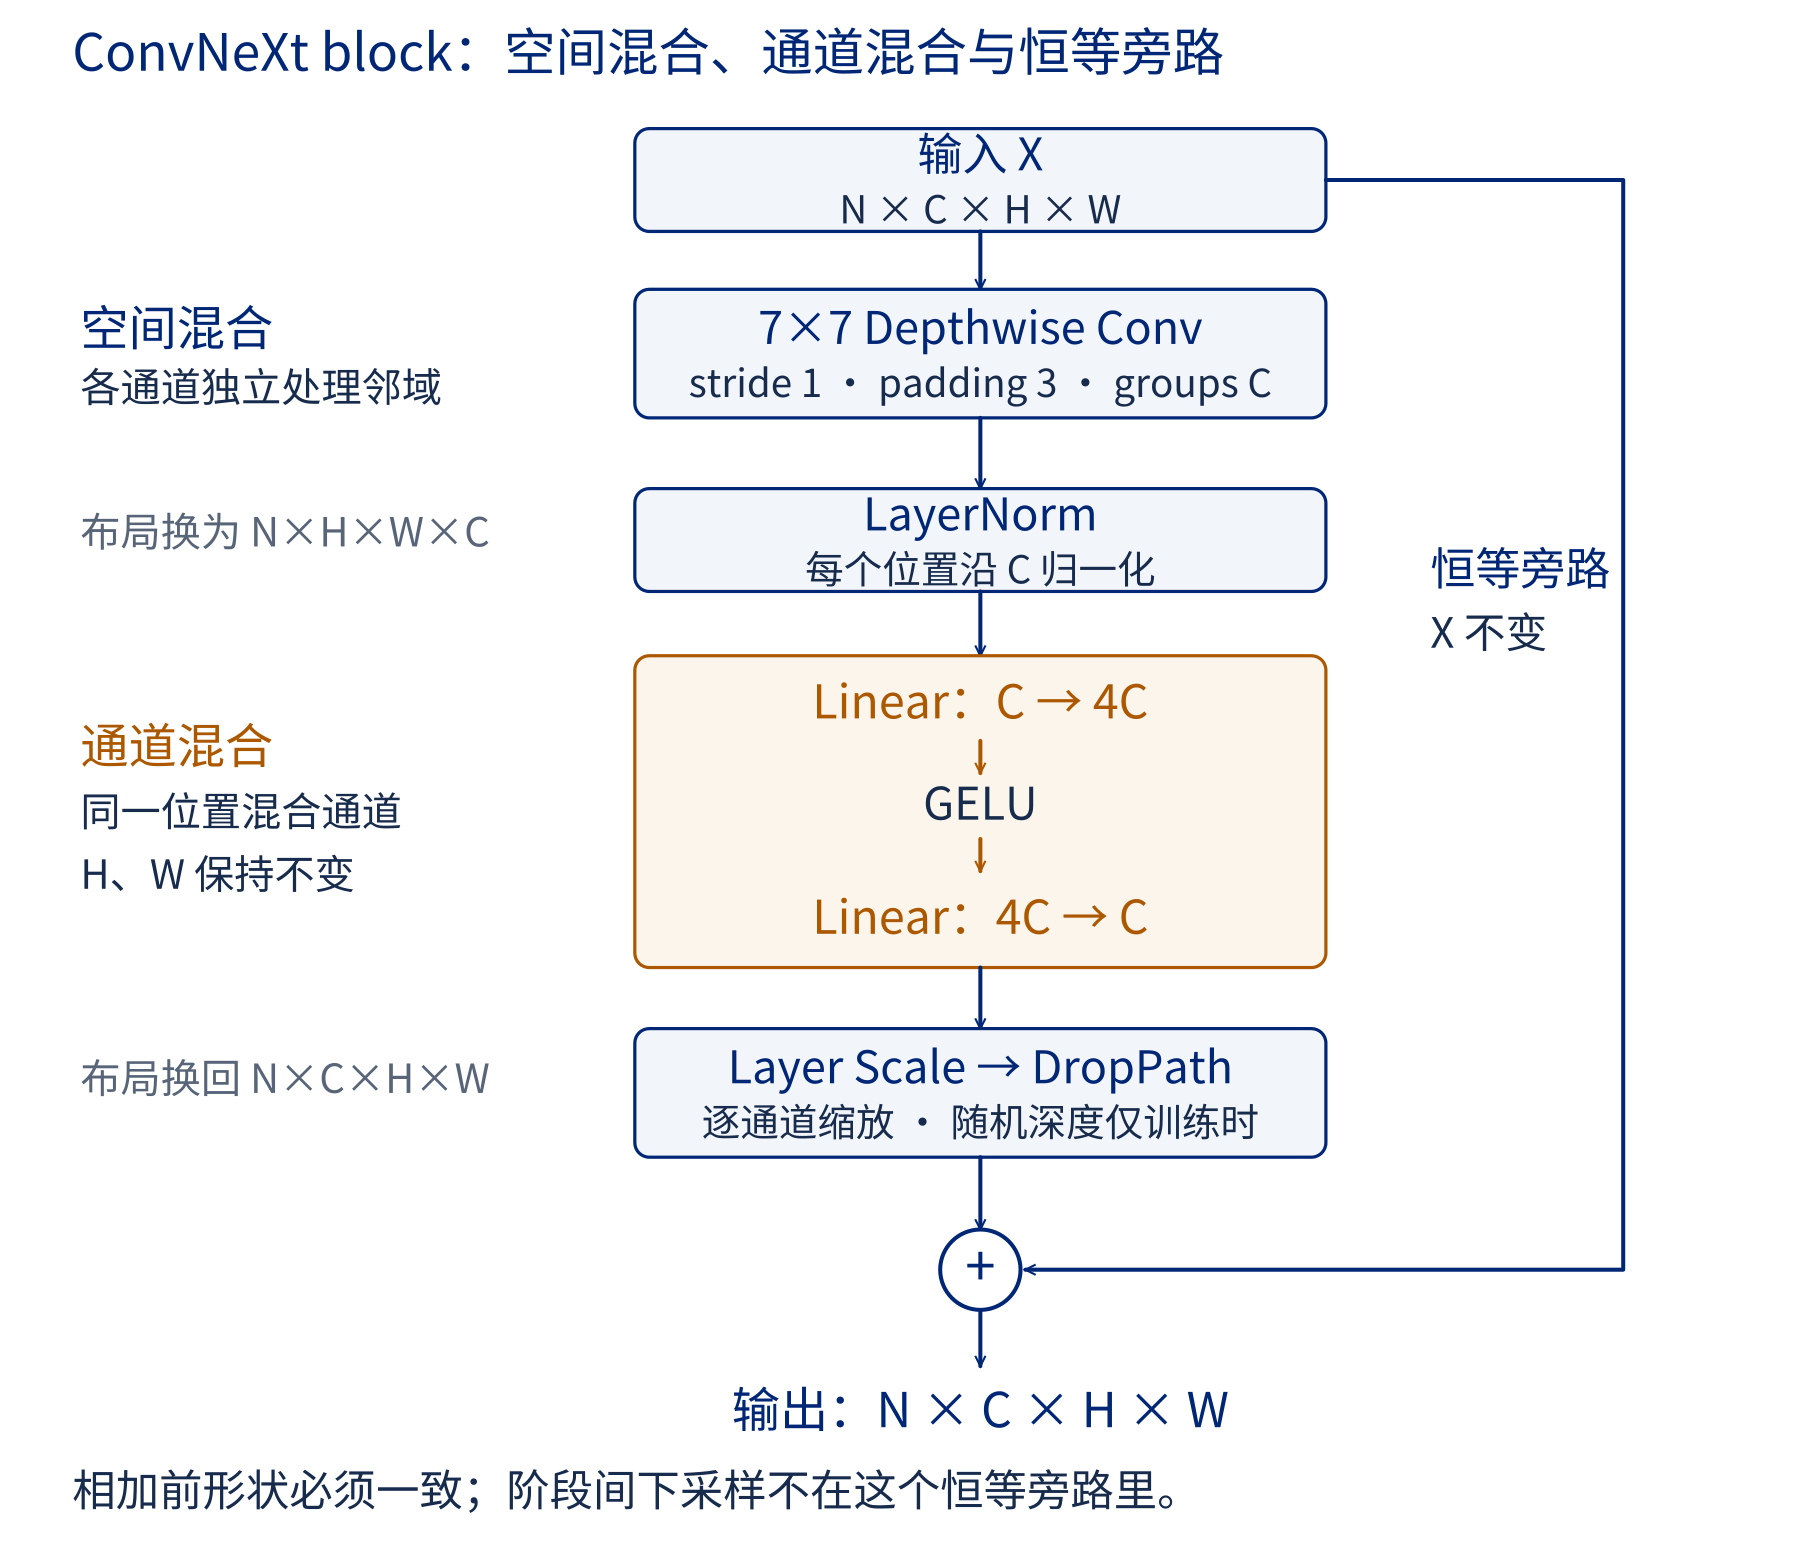
先看什么。 先沿中路找出空间混合与通道混合,再沿右侧检查相加的两路是否形状相同。
改变一个条件。 若末个 Linear 输出 2C,而恒等旁路仍是 C,哪个接口首先失配?请指出图中的具体节点。
取保持空间尺寸和通道数的代表 block。输入为 $X\in\mathbb R^{N\times C\times H\times W}$,先做7×7 depthwise convolution:每个通道独立处理空间;再换成通道末尾布局做 LayerNorm。逐位置的线性层将 $C$ 扩到 $4C$,经过 GELU,再线性压回 $C$;经可学习 layer scale 与训练时的随机深度分支,再与原输入相加。
这里 LayerNorm 在每个位置的通道维上工作,不是 BatchNorm 的跨 batch 统计。depthwise 不混通道,两个线性层才在每个位置混合通道;残差相加要求回到输入形状。阶段间下采样属于 block 外的整网设计,不能悄悄画进恒等旁路。
这个 block 沿用了已经理解的局部计算、通道变换和残差接口,不需要先完整推导 Attention。ConvNeXt 原文与实现入口。
图中的顺序对应原版 ConvNeXt 的保持形状 block:7×7 DWConv 使用 stride=1、padding=3、groups=C;末端恢复原布局后相加。层间下采样与 ConvNeXt V2 的 GRN 均未混入此图。官方 Block 实现。
5. 先控制配方,再归因于结构
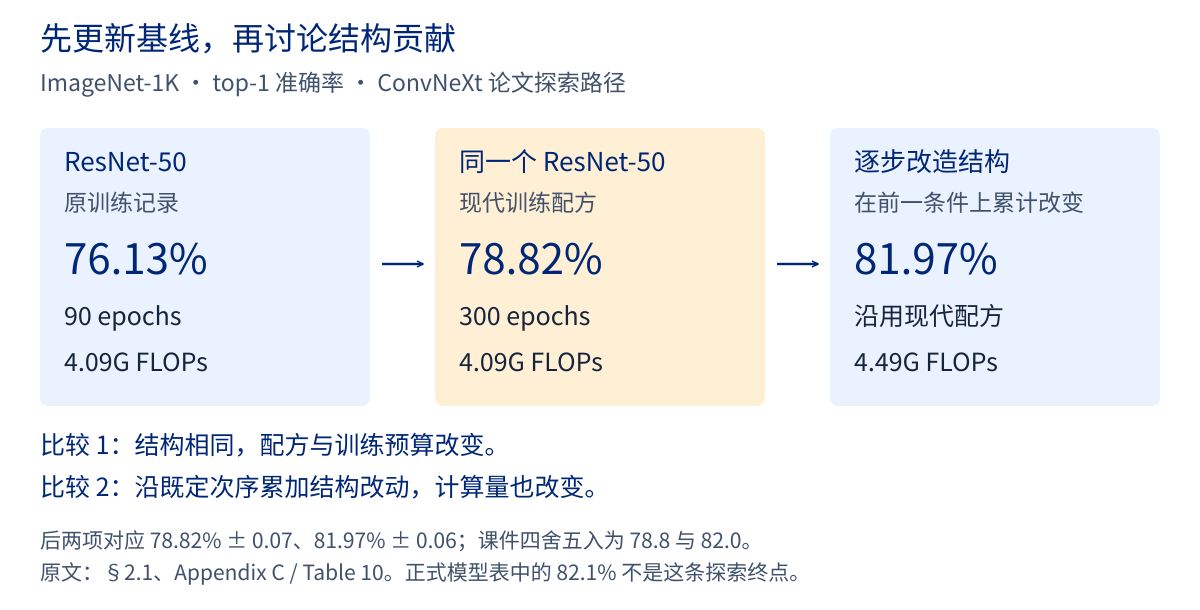
先看中间一步。 起点与第二点都叫 ResNet-50,结构没有变,成绩却不同。先说明这能排除哪一种归因,再继续读右侧。
ConvNeXt 先更新卷积基线的训练方法,再逐步改变结构。论文探索路径中的 ImageNet-1K top-1 记录如下;课件将其显示为 76.1、78.8、82.0。
| 路径位置 | top-1 准确率 | 前向计算量 | 这一步改变了什么 |
|---|---|---|---|
| ResNet-50 起点 | 76.13% | 4.09G FLOPs | 原训练记录 |
| 同结构,现代配方 | 78.82% ± 0.07 | 4.09G FLOPs | 90→300 epochs,以及优化器、增强与正则等 |
| 累计结构改造终点 | 81.97% ± 0.06 | 4.49G FLOPs | 在前述基础上依次改变结构 |
前两项说明配方也能带来增益,但不是等训练预算比较。最后一项是累计探索的终点:它依赖前面的配方与改造次序,计算量也变了,不能把每一步都解释成独立、等预算因素。正式模型表的 ConvNeXt-T 82.1% 属于另一条记录,不替换这里的 81.97%。
改变比较方法。 如果只留下第一行和最后一行,你会漏掉什么解释?若想研究某一项结构改造,写出你希望补上的一组对照,并说明应固定哪些训练条件。
6. 通道响应参考:GRN 做了什么?
GRN 的完整计算。 按论文 Algorithm 1 的通道末尾约定,输入 $X\in\mathbb R^{N\times H\times W\times C}$。每张图、每个通道先汇总空间上的 L2 响应,再相对同图的通道平均响应归一化:
$$g_{nc}=\sqrt{\sum_{h,w}X_{nhwc}^{2}},\qquad r_{nc}=\frac{g_{nc}}{C^{-1}\sum_{j=1}^{C}g_{nj}+10^{-6}}.$$
保留广播维度时,$g,r$ 均为 $N\times1\times1\times C$。再逐通道作可学习残差调节:
$$Y_{nhwc}=X_{nhwc}+\gamma_c X_{nhwc}r_{nc}+\beta_c.$$
$\gamma,\beta$ 广播为 $1\times1\times1\times C$,均从零初始化,因此初始层是恒等映射。这里比较的是一张图内部的通道响应,不估计跨 batch 的均值方差;它也不直接把每通道输出改成零均值、单位方差。该机制针对通道响应冗余、失活或饱和的观察,是否改善任务仍须回到受控比较。GRN:Sec.4、Algorithm 1。结构×目标的 FCMAE 四格归第三讲;此处只核对模块计算,不把 GRN 写成 BN。
7. 用一张表检查比较是否公平
比较的结果可以真实有效,但“是什么造成差异”需要另一层检查。先把自己的比较写进下面四行,不必一开始就罗列所有模型。
| 检查项 | 要写清什么 | 它限制了什么结论 |
|---|---|---|
| 数据与评价 | 训练/验证/测试划分、类别、输入分辨率、读出和指标 | 是否在回答同一个任务 |
| 训练过程 | 目标、优化器、增强、轮次、种子与选择 checkpoint 的规则 | 能否把增益归给结构 |
| 计算结构 | 改哪一段;相加、拼接与输出接口是否保持 | 变化对象是否明确 |
| 成本与设备 | 参数、乘加、激活存储、设备与计时起止点 | “更省”具体省了什么 |
课堂讨论。 任选前一节两行,指出一个保持的条件、一个改变的条件,以及一个仍不能排除的解释。然后到 第二讲 LAB10 观察:保持组内输入/输出形状,MAC 与实测延迟会不会给出不同排序。
8. 迁往第三讲:数据规模与训练目标
有监督分类训练也能得到可迁移的表示;无监督/自监督提供的是另外的学习信号,不是“可迁移”的同义词。第三讲从这些学习信号和表示复用继续,再讨论空间输出及图像与语言的对应。
第三讲导读:现有材料与学习路径区分当前可读内容与后续待补范围。ViT 预训练数据、FCMAE 与结构×目标比较可沿导读中的表示评价材料继续;不需要为了读这一册先学完整 Attention。
9. 第五讲暂存:图块与完整 Attention
完整 Q/K/V、读回 V、输出投影、pre-norm 两条残差与 MLP 的正文已拆至 第五讲暂存入口。LAB 09保留数值代码、中间张量与输出,不列为第二讲或第三讲前置。
本册下一步是成本与自动选择,不在此重启 Transformer 专题。
10. 比较结论还受哪些评价条件限制?
同一测试准确率并不意味着错误样本或置信度完全相同。第二讲在早退处保留“自信可能错停”的最小证据;ECE 分箱、拒识与适应的完整解释进入 独立研究参考 CLS 08。
回到架构研究卡:你改变了哪段计算?最简单基线是什么?多付出的参数、运算或状态值不值得?