LAB 03 · 架构实验室
把一个架构判断变成可以运行的对照。 本册用小张量检查感受野、通道、残差和 BatchNorm;不训练大网络,也不产生架构准确率排名。
| 选一个问题 | 运行入口 | 只改一项、看一个差异 |
|---|---|---|
| 有 skip 就一定保持输入和梯度吗 | 文末“真正开关 skip…”;独立代码块 | BRANCH_GAIN: 0→−1;看输出及逐元素导数 |
| 输入没变,BN输出会变吗 | 文末“只换同批同伴…”;独立代码块 | PEER_SHIFT: 8→0;看 train/eval 的 max_gap |
| 分支能不能拼接/相加 | 第3节 Inception、第4节残差;先运行准备导入块 | 看各路 H、W、C 与 concat/add 接口 |
| 感受野与输出采样间隔有什么区别 | 第1节;先运行准备导入块 | 对照 RF extent 与 Jump 两列 |
推荐先做残差开关。 先判断 F(x)=0 时哪行保留全部输入,再运行;之后仅把 BRANCH_GAIN 改为−1,预测“直接路+分支”是否抵消。每次运行同一个独立块会重新建立比较,避免不同随机初始化混进解释。
阅读现有图与结果表无需运行。正文第6节汇总代码依赖前面各节变量,只做一个任务时不用运行汇总。
主路径:1 → 3 → 4 → 5。 围绕感受野、瓶颈、残差和 BatchNorm 的关键取舍;其余作为源码与数学深入。
VGG 把深度组织成块,NiN 让每个位置拥有通道 MLP,Inception 分配不同尺度的计算,ResNet 把额外层参数化为对旧表示的修正。它们不是一个指标单调上升的名单,而是在计算、表示能力与可优化性之间作不同选择。
目标
同时检查感受野、通道表示、参数成本、残差导数与BatchNorm状态;用可证伪的预测连接数学与实现。
准备与使用
本册可独立从头运行;跨册文件依赖在相应准备节单独说明。需要 Python 3.10+ 与 numpy matplotlib torch ipython;保存/检查 notebook 另需 nbformat matplotlib-inline。安装命令:
python -m pip install numpy matplotlib torch ipython nbformat matplotlib-inline
保存图与文末记录来自此前 Python 3.12 / PyTorch 2.14.0+cpu 的本地执行。你自己的运行环境版本由下一代码块打印;本次整理未重跑这些训练。图轴使用英文,正文提供中文读图说明。缺依赖时再安装,已有环境不必重复安装;课堂按开头任务入口运行,不必 Run all。
本材料改编自 Aston Zhang、Zachary C. Lipton、Mu Li、Alexander J. Smola 的 Dive into Deep Learning。D2L 正文 CC BY-SA 4.0,示例代码 modified MIT,许可随完整包 licenses/ 保存。我们补充多通道梯度、采样反例、受控实验、真实 PyTorch 状态语义;不要把教学小实现视为框架底层实现。
查看代码 · 单元 8
from pathlib import Path
import copy, hashlib, inspect, json, math, platform, time
import numpy as np
import matplotlib.pyplot as plt
import torch
from torch import nn
from torch.nn import functional as F
from IPython.display import display, Markdown

torch.manual_seed(20260921)
torch.set_num_threads(2)
torch.use_deterministic_algorithms(True)
OUT=Path('results'); OUT.mkdir(exist_ok=True)
FIG=Path('figures'); FIG.mkdir(exist_ok=True)
BLUE,GOLD,TEAL,RED='#002676','#FDB515','#00897B','#B83A3A'
plt.rcParams.update({'font.size':11,'axes.spines.top':False,'axes.spines.right':False,
                     'figure.dpi':110,'savefig.facecolor':'white'})
def savefig(fig,name):
    fig.savefig(FIG/f'{name}.png',dpi=160,bbox_inches='tight')
    fig.savefig(FIG/f'{name}.svg',bbox_inches='tight')
def table(headers,rows):
    display(Markdown('| '+' | '.join(headers)+' |\n| '+ ' | '.join(['---']*len(headers))+' |\n'+
                     '\n'.join('| '+' | '.join(map(str,row))+' |' for row in rows)))
print('PyTorch',torch.__version__,'/ Python',platform.python_version(),'/ device CPU')
1. 感受野要与输出采样间隔一起算
从 $r_0=1,j_0=1$ 开始:$r_l=r_{l-1}+(k_l-1)d_lj_{l-1}$,$j_l=s_lj_{l-1}$。前者是潜在影响区域的范围,后者是相邻输出在原图上的间隔。序列有空洞/稀疏采样时,范围内不一定每个像素都实际连接。
三层 3×3 的覆盖可达 7×7,不能因此说与一层 7×7 完全等价。先固定通道 C 与分辨率:三层权重为 $27C^2$,一层为 $49C^2$;加入非线性改变函数类,中间激活也需要内存。整个 VGG 仍可能很大。
查看代码 · 单元 11
def rf_table(layers):
    r,j=1,1;rows=[]
    for name,k,s,d in layers:
        r+=(k-1)*d*j;j*=s;rows.append([name,k,s,d,r,j])
    return rows
rf=rf_table([('conv3',3,1,1),('conv3',3,1,1),('pool2',2,2,1),('conv3',3,1,1)])
table(['Layer','k','s','d','RF extent','Jump'],rf)
assert rf[-1][-2:]==[10,2]
three=rf_table([('conv3',3,1,1)]*3)
assert three[-1][-2]==7
print('Equal-channel kernel weights: three 3x3 = 27 C²; one 7x7 = 49 C²')
深入:理论范围与当前梯度热图
下面使用三个全 1 的 3×3 线性核,让中心输出的所有路径都可见。它是构造性机制演示,不是训练网络的平均有效感受野研究结果。中心位置拥有更多组合路径,梯度更大;边缘虽在理论感受野内,贡献也可以较小。改成 ReLU 或稀疏权重,支持域可能进一步缩小。
查看代码 · 单元 14
inp=torch.zeros(1,1,13,13,requires_grad=True)
value=inp
for _ in range(3):value=F.conv2d(value,torch.ones(1,1,3,3),padding=1)
value[0,0,6,6].backward();sensitivity=inp.grad[0,0]
where=torch.nonzero(sensitivity)
extent=(where.max(0).values-where.min(0).values+1).tolist()
assert extent==[7,7]
fig,ax=plt.subplots(figsize=(4.8,4));im=ax.imshow(sensitivity,cmap='Blues')
ax.set(title='Three linear 3x3 layers: center-output gradient',xlabel='Input column',ylabel='Input row')
fig.colorbar(im,ax=ax,label='Derivative');savefig(fig,'lab03-receptive-field-gradient');plt.show()
保存结果|理论范围中的贡献并不均匀
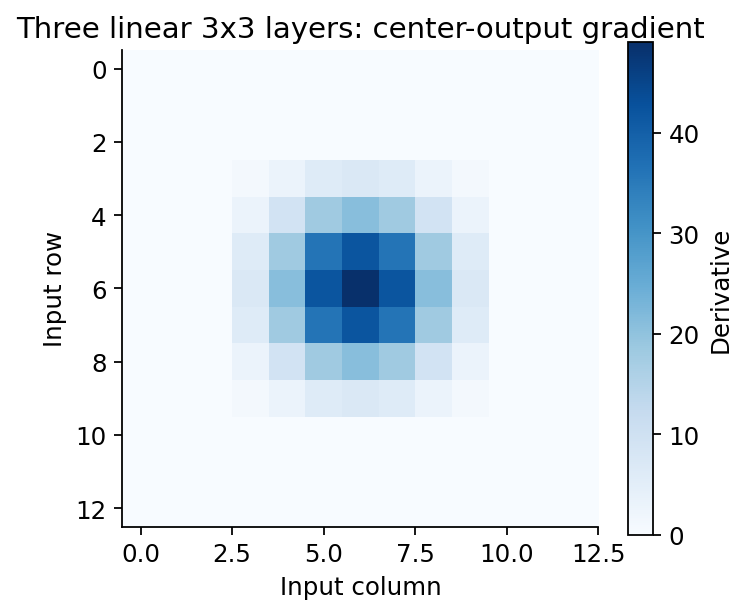
先圈出非零支持域,再比较中心与边缘的梯度值:同在7×7范围内,路径数不同,贡献可以不同。这张图由三个全1的线性核得到,不是训练网络的平均有效感受野。
2. 1×1 和 NiN:空间不动,通道里的表示在变
1×1 满足 $Y_{n,:,i,j}=WX_{n,:,i,j}+b$。共享的逐位置线性层后接非线性,就是通道 MLP;它无法单独观察邻居,但可组合前面已经提取的空间特征。
对 (C,H,W)=(64,7,7)、10 类,flatten→linear 有 $(64\cdot7\cdot7)\cdot10+10$ 参数;GAP→linear 为 $64\cdot10+10$。全局平均把位置压缩为统计量,改变 head 的函数类;并非对所有任务无损。GAP→linear 与 1×1 class conv→GAP 在线性且 bias 对齐时等价,加入额外非线性后未必。
查看代码 · 单元 18
x=torch.randn(2,3,5,6,dtype=torch.float64);w=torch.randn(4,3,1,1,dtype=torch.float64);b=torch.randn(4,dtype=torch.float64)
y=F.conv2d(x,w,b)
z=torch.einsum('oc,nchw->nohw',w[:,:,0,0],x)+b[None,:,None,None]
torch.testing.assert_close(y,z)
C,H,W,classes=64,7,7,10
head_flat=nn.Linear(C*H*W,classes);head_gap=nn.Linear(C,classes)
head_counts={'flatten_linear':sum(p.numel() for p in head_flat.parameters()),'gap_linear':sum(p.numel() for p in head_gap.parameters())}
table(['Head','Parameters'],list(head_counts.items()))
features=torch.randn(2,C,H,W)
torch.testing.assert_close(head_gap(features.mean((2,3))),F.conv2d(features,head_gap.weight[:,:,None,None],head_gap.bias).mean((2,3)))
3. Inception 瓶颈:让昂贵的核在较窄表示上工作
沿用网页例 192→32→32:直接 5×5 需要 $192\cdot32\cdot25=153600$ weights;先 1×1 压缩,再 5×5,需要 $192\cdot32+32\cdot32\cdot25=31744$。这里忽略 bias/BN;计算比例只在输出空间大小相同、按 Conv MAC 计数时成立。
表示取舍也必须说:若中间没有非线性,对每个空间偏移的通道变换有秩约束,压到 r 维通常不能表示任意完整 kernel。加入 ReLU 增加非线性,但投影丢失的输入信息不会自动回来。D2L 原始 GoogLeNet 第一 Inception 的 5×5 分支是 192→16→32;我们保留 32 的教学变体以与网页一致。
Inception 合并用 concat:各分支 H,W 必须相同,通道数相加。残差合并用 add:完整 shape 必须匹配,通道不相加。
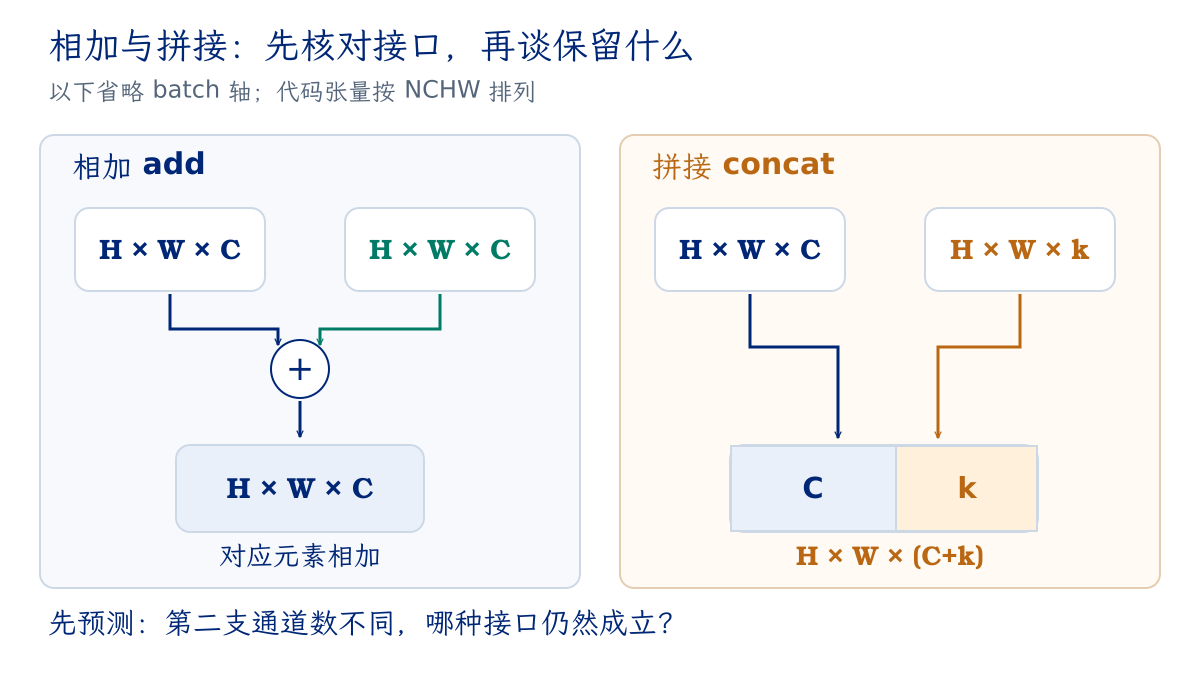
先沿两张图各读一条路。 图中省略 batch 轴,代码仍用 NCHW。若把第二支从 C 改成 k,哪一种合并仍有合法接口?先给答案,再对照本节 concat 与下节 residual 的 shape 断言。
查看代码 · 单元 21
direct=nn.Conv2d(192,32,5,padding=2,bias=False)
bottleneck=nn.Sequential(nn.Conv2d(192,32,1,bias=False),nn.ReLU(),nn.Conv2d(32,32,5,padding=2,bias=False))
direct_n=sum(p.numel() for p in direct.parameters());bottle_n=sum(p.numel() for p in bottleneck.parameters())
assert (direct_n,bottle_n)==(153600,31744)
print('Weights:',direct_n,'vs',bottle_n,'/ reduction:',direct_n/bottle_n)
class Inception(nn.Module):
    def __init__(self):
        super().__init__()
        self.a=nn.Sequential(nn.Conv2d(192,64,1),nn.ReLU())
        self.b=nn.Sequential(nn.Conv2d(192,96,1),nn.ReLU(),nn.Conv2d(96,128,3,padding=1),nn.ReLU())
        self.c=nn.Sequential(nn.Conv2d(192,32,1),nn.ReLU(),nn.Conv2d(32,32,5,padding=2),nn.ReLU())
        self.d=nn.Sequential(nn.MaxPool2d(3,stride=1,padding=1),nn.Conv2d(192,32,1),nn.ReLU())
    def forward(self,x):return torch.cat([self.a(x),self.b(x),self.c(x),self.d(x)],dim=1)
assert Inception()(torch.zeros(1,192,14,14)).shape==(1,256,14,14)
print('Concat output channels:',64+128+32+32)
4. 残差:在恒等映射附近学习修正,而非保证梯度不消失
无后激活时 $y=x+F(x)$,$J_y=I+J_F$。原始 postactivation ResNet 实际为 $\operatorname{ReLU}(x+F(x))$,Jacobian 还有激活 mask。下采样/改变通道时捷径为投影 P,导数变成 $J_P+J_F$。
这一参数化给表示与梯度提供直接路径,小残差附近更容易保留既有计算;它没有证明任何深度都能训练好。构造 $F(x)=-x$ 即可得到零梯度,post-ReLU 也能屏蔽负区间。不要把「公式里加了 I」当成全局梯度下界。
ResNet 的 plain 20/56 层曲线连训练误差都变差,指出优化困难;过拟合无法单独解释,但曲线也不识别唯一机制。Identity Mappings 进一步分析了捷径与激活位置。
查看代码 · 单元 24
class Residual(nn.Module):
    def __init__(self,cin,cout,stride=1):
        super().__init__()
        self.branch=nn.Sequential(nn.Conv2d(cin,cout,3,stride=stride,padding=1,bias=False),nn.BatchNorm2d(cout),nn.ReLU(),
                                  nn.Conv2d(cout,cout,3,padding=1,bias=False),nn.BatchNorm2d(cout))
        self.shortcut=nn.Identity() if cin==cout and stride==1 else nn.Sequential(nn.Conv2d(cin,cout,1,stride=stride,bias=False),nn.BatchNorm2d(cout))
    def forward(self,x):return F.relu(self.branch(x)+self.shortcut(x))
same=Residual(16,16);down=Residual(16,32,2)
assert same(torch.randn(2,16,14,14)).shape==(2,16,14,14)
assert down(torch.randn(2,16,14,14)).shape==(2,32,7,7)
v=torch.tensor([-1.,1.],dtype=torch.float64)
j1=torch.autograd.functional.jacobian(lambda v:v+.1*v,v)
j2=torch.autograd.functional.jacobian(lambda v:F.relu(v+.1*v),v)
j3=torch.autograd.functional.jacobian(lambda v:v-v,v)
print('I + J_F:\n',j1,'\nWith post-ReLU:\n',j2,'\nCancellation F=-x:\n',j3)
5. BatchNorm:train/eval 与 grad/no_grad 是两条独立轴
BN2d 对每个通道汇总 N,H,W 的统计,训练输出为
\[
y=\gamma\frac{x-\mu_B}{\sqrt{v_B+\epsilon}}+\beta.
\]
γ、β 是学到的 parameters;runningmean/var 是 buffers。PyTorch 训练归一化用 biased variance,runningvar 更新用 unbiased variance。例 [1,3,5,7]:均值4,方差分别为5与20/3;momentum=.1 表示新统计占 .1,不是优化器的动量。
D2L scratch 与真实 PyTorch 的差别值得读出来。 D2L 教学函数以 torch.is_grad_enabled() 决定训练/预测,并使用 biased moving variance;真实 _BatchNorm.forward 按 self.training 决定,no_grad 只控制自动微分。把教科书逐行搬过来并不自动获得框架语义。
查看代码 · 单元 27
batch=torch.tensor([[[[1.,3.]]],[[[5.,7.]]]],dtype=torch.float64)
mode_rows=[]
for training in (True,False):
    for enabled in (True,False):
        bn=nn.BatchNorm2d(1,momentum=.1).double();bn.train(training)
        inp=batch.clone().requires_grad_()
        with torch.set_grad_enabled(enabled):
            value=bn(inp)
            if enabled:value.sum().backward()
        mode_rows.append([str(training),str(enabled),int(bn.num_batches_tracked),
                          round(float(bn.running_mean[0]),6),round(float(bn.running_var[0]),6),inp.grad is not None])
table(['training','grad enabled','Batches tracked','Running mean','Running variance','Input gradient exists'],mode_rows)
assert [row[2] for row in mode_rows]==[1,1,0,0]
bn=nn.BatchNorm2d(1,affine=False,momentum=.1).double().train()
with torch.no_grad():observed=bn(batch)
biased=batch.var(unbiased=False);unbiased=batch.var(unbiased=True)
torch.testing.assert_close(observed,(batch-batch.mean())/(biased+bn.eps).sqrt())
torch.testing.assert_close(bn.running_var,(.9+.1*unbiased).reshape(1))
print('Biased variance:',float(biased),'unbiased:',float(unbiased),'running:',float(bn.running_var[0]))
print('Parameters:',[n for n,_ in nn.BatchNorm2d(3).named_parameters()])
print('Buffers:',[n for n,_ in nn.BatchNorm2d(3).named_buffers()])
深入:为什么 eval 后仍可以求导?为什么冻结参数还不够?
eval() 选择模块的运行行为,并不禁止求导。输入优化、可视化或对抗样本常在 eval 下求输入梯度。反过来,冻结 requires_grad=False 并不会停止处于 train 状态的 BN 更新 running statistics;迁移学习时要独立决定特征权重和统计如何处理。
batch size 1 对 BN2d 不必然退化,因为 N×H×W 仍可大于 1;当每通道总样本数太小,估计不稳。track_running_stats=False 时 eval 也会使用当前 batch 统计。这里不把「消除内部协变量偏移」当作唯一被证明机制。
下面实际打印 _BatchNorm.forward,运行环境更新时源码也会相应变化。
源码定位:运行模式与统计量
查看代码 · 单元 31
from torch.nn.modules.batchnorm import _BatchNorm
print('PyTorch',torch.__version__,'git',torch.version.git_version)
print('File:',inspect.getsourcefile(_BatchNorm))
print(inspect.getsource(_BatchNorm.forward))
bn_untracked=nn.BatchNorm2d(1,affine=False,track_running_stats=False).double().eval()
torch.testing.assert_close(bn_untracked(batch),(batch-batch.mean())/(batch.var(unbiased=False)+bn_untracked.eps).sqrt())
print('track_running_stats=False in eval uses current batch statistics: verified.')
6. 汇总:给自己的模型提出一个能被实验否定的判断
可以从以下方向选一个继续:等感受野但不同非线性的网络是否相同?瓶颈的成本节省是否换来本任务可接受的信息损失?冻结 BN running statistics 对小数据迁移是否有利?若观察训练退化,怎样分开表达能力、优化、数据和统计模式的问题?
比较前先固定协议和成功标准,结果出来后再写解释。额外深度不是必须塞更多架构,而是让设计决定可推导、可运行、可反驳。
查看代码 · 单元 34
summary={'receptive_field_rows':rf,'three_conv_gradient_extent':extent,'heads':head_counts,
         'inception_5x5':{'direct_weights':direct_n,'bottleneck_weights':bottle_n,'ratio':direct_n/bottle_n,'definition':'192->32->32; no bias'},
         'residual_jacobians':{'plain_residual':j1.tolist(),'post_relu':j2.tolist(),'cancellation':j3.tolist()},
         'batchnorm_modes':mode_rows,'batchnorm_variances':{'biased':float(biased),'unbiased':float(unbiased),'running_after_one_batch':float(bn.running_var[0])},
         'execution':'local CPU; full notebook; actual PyTorch source inspected','torch':torch.__version__}
(OUT/'lab03-results.json').write_text(json.dumps(summary,indent=2))
print('Saved results/lab03-results.json')
既有实验的执行记录(沿用)
以下为既有本地执行记录,重组时沿用来源与原数值;本轮未重跑这一源实验。
本地 CPU / PyTorch 2.14.0+cpu,所有单元按顺序执行。
| 检查 | 实测 |
|---|---|
| Conv3、Conv3、Pool2、Conv3 的感受野/采样间隔 | (3,1)、(5,1)、(6,2)、(10,2) |
| 三个全1的3×3线性核,中心输出梯度支持范围 | 7×7 |
| 64×7×7→10 Flatten/Linear 与 GAP/Linear 参数 | 31370 / 650 |
| 192→32直接5×5 / 192→32→32瓶颈,无bias权重 | 153600 / 31744 |
| BN当前batch biased / unbiased variance | 5 / 6.666667 |
| 初始running variance=1、momentum=0.1,一batch后 | 1.566667 |
train 模式在 grad 与 no_grad 下都更新统计;eval 模式均保持统计,其中开启grad时输出仍能求导。残差的 I+JF 检查通过,F=-x 的Jacobian为零。结构小张量检查不提供架构准确率排名。
协议与来源沿革
历次备课记录与原数值表保留在。本实验使用前文明确的当前协议与模型身份;历史数值不与新运行合并。
返回 CLS 00 · 第二讲导读
历史实验再读 1 · 同一张输入,只换同批同伴,BN 的输出会变吗?
先预测。 前文的四格实验区分了 train/eval 与 grad/no_grad。本节固定同一张目标输入和同一份初始 BN 状态,只干预同批另一张图。目标图没有变,train 下它的输出是否仍会变?使用同一份 running statistics 的 eval 下呢?
修改参数再运行。 默认同伴增加 PEER_SHIFT=8;再试 0 和 −4。每次比较都从相同 BN 状态各复制一份,避免先运行 A 更新了统计后再运行 B 的顺序干扰。所有分支都使用 no_grad,所以此处只观察归一化依赖,不重复前面的梯度开关实验。
历史来源与改写。 Spring26 Lecture3-3_batch-norm,project 03ca31da-8b5e-4562-82d0-0898f6eb7b7a,notebook 9aedcc8ce71741adae44747a811ca3b4。继承旧课按 (N,H,W) 求通道统计、区分批统计与 running statistics 的主题;本次采用原生 nn.BatchNorm2d,新加固定目标输入的配对同伴干预。没有复用旧课的自定义 moving-variance 计算或训练结论。
查看代码 · 单元 42
import copy
import torch
from torch import nn

torch.set_num_threads(2)
PEER_SHIFT, MOMENTUM = 8.0, 0.1  # 再试:0.0, 0.1;或 -4.0, 0.1
assert 0 <= MOMENTUM <= 1
anchor = torch.tensor([[[[1., 3.]]]], dtype=torch.float64)
peer_a = anchor.clone()
peer_b = peer_a + PEER_SHIFT
batch_a = torch.cat([anchor, peer_a], dim=0)
batch_b = torch.cat([anchor, peer_b], dim=0)
base = nn.BatchNorm2d(1, affine=True, momentum=MOMENTUM, track_running_stats=True).double()
with torch.no_grad():
    base.weight.fill_(1.0)
    base.bias.zero_()
    base.running_mean.fill_(2.0)
    base.running_var.fill_(4.0)

HISTORY_RESULT = {}
print('Anchor in both batches:', anchor.flatten().tolist())
print('Peer A:', peer_a.flatten().tolist(), '| Peer B:', peer_b.flatten().tolist())
for mode in ('train', 'eval'):
    paired = []
    for label, batch in [('A', batch_a), ('B', batch_b)]:
        bn = copy.deepcopy(base)
        bn.train(mode == 'train')
        with torch.no_grad():
            output = bn(batch)[0].clone()
        paired.append(output)
        print(mode, label, '| anchor output:', [round(v, 6) for v in output.flatten().tolist()],
              '| running mean/var:', round(bn.running_mean.item(), 6), round(bn.running_var.item(), 6),
              '| batches tracked:', bn.num_batches_tracked.item())
    gap = float((paired[0]-paired[1]).abs().max())
    HISTORY_RESULT[mode] = {'anchor_A': paired[0].flatten().tolist(), 'anchor_B': paired[1].flatten().tolist(), 'max_gap': gap}
    if mode == 'eval' or PEER_SHIFT == 0:
        torch.testing.assert_close(paired[0], paired[1])
    else:
        assert not torch.allclose(paired[0], paired[1])
print('Checks:', HISTORY_RESULT)
核对与解释。 默认 train 的目标输出随同伴变化,eval 的两次目标输出相同,约为 [-0.5,0.5]。这不是目标样本像素发生变化,而是 train 归一化依赖整批的统计。将 PEER_SHIFT=0 作为负对照,train 的差异也应消失。
边界与讨论。 结论依赖 track_running_stats=True,并且 eval 两边使用相同的 running statistics;若关闭跟踪,eval 也会依赖当前 batch。两边 train 后保存下来的统计本来就可能不同,不能再把它们各自用于 eval 并宣称“只换了同伴”。BN2d 的统计样本数是 N×H×W,不能只报 batch size。这个受控前向检查不提供准确率、收敛速度或 BN 优越性的证据。
历史实验再读 2 · 真正开关 skip,再检查后加 ReLU 能否保留输入
先预测。 旧课“对比是否使用残差”记录的是同一网络内残差分支与相加后激活的均值,未真正关闭 skip。前文已展示 Jacobian 公式;本节把干预写进真实模块:固定同一份 1×1 分支权重、同一输入,只切换 skip 与相加后的 ReLU。设分支 F(x)=0 时,哪种配置逐元素等于输入?含负值输入经过后加 ReLU 后还能全部保留吗?
修改参数再运行。 默认 BRANCH_GAIN=0;再试 −0.5 和 −1。四行比较共用同一个模块和同一份权重,无随机重初始化。每行展示完整输出、与输入的最大差、d(sum y)/dx。最后一项因本例的 1×1 分支不混合空间位置,正好对应各位置的局部导数。
历史来源与改写。 Spring26 Lecture3-6_resnet,project 03ca31da-8b5e-4562-82d0-0898f6eb7b7a,notebook 41c34ad80a414d1db1e62b748a61aee1。承接旧课 BasicBlock 的加法和 post-ReLU 位置;本次把分支缩成可解释的标量 1×1 卷积,加入真正的 skip 开关和逐元素/梯度对照,移除数据集、完整 ResNet 与训练。不是对旧课训练模型重新消融,也不复述旧激活均值为消融证据。
查看代码 · 单元 46
import torch
from torch import nn
from torch.nn import functional as F

torch.set_num_threads(2)
BRANCH_GAIN = 0.0  # 再试:-0.5;-1.0
assert -2 <= BRANCH_GAIN <= 2

class SwitchableResidual(nn.Module):
    def __init__(self, gain):
        super().__init__()
        self.branch = nn.Conv2d(1, 1, 1, bias=False).double()
        with torch.no_grad():
            self.branch.weight.fill_(gain)
        self.branch.weight.requires_grad_(False)  # 只对输入求导,不改变分支
    def forward(self, x, skip, post_relu):
        pre_activation = self.branch(x) + (x if skip else torch.zeros_like(x))
        return F.relu(pre_activation) if post_relu else pre_activation

block = SwitchableResidual(BRANCH_GAIN).eval()
base_input = torch.tensor([-2., -0.5, 0.5, 2.], dtype=torch.float64).reshape(1, 1, 2, 2)
HISTORY_RESULT = {'branch_gain': BRANCH_GAIN, 'rows': []}
print('Fixed input:', base_input.flatten().tolist(), '| fixed branch gain:', BRANCH_GAIN)
print(f"{'skip':<7} {'post-ReLU':<11} {'output':<32} {'max |y-x|':<12} derivative")
for skip in (False, True):
    for post_relu in (False, True):
        x = base_input.clone().requires_grad_()
        y = block(x, skip=skip, post_relu=post_relu)
        dx, = torch.autograd.grad(y.sum(), x)
        values, derivatives = y.detach().flatten().tolist(), dx.flatten().tolist()
        error = float((y.detach()-base_input).abs().max())
        print(f'{str(skip):<7} {str(post_relu):<11} {str(values):<32} {error:<12.6g} {derivatives}')
        HISTORY_RESULT['rows'].append({'skip': skip, 'post_relu': post_relu, 'output': values, 'max_identity_error': error, 'd_sum_output_d_input': derivatives})
with torch.no_grad():
    off = block(base_input, skip=False, post_relu=False)
    on = block(base_input, skip=True, post_relu=False)
    torch.testing.assert_close(on-off, base_input)  # 真正隔离开关增加的项
    if BRANCH_GAIN == 0:
        torch.testing.assert_close(on, base_input)
        torch.testing.assert_close(block(base_input, True, True), F.relu(base_input))
    if BRANCH_GAIN == -1:
        torch.testing.assert_close(on, torch.zeros_like(base_input))
print('Skip-on minus skip-off, before activation:', (on-off).flatten().tolist())
默认核对。 F=0 时,skip 开、无后激活的输出恰好等于输入;后加 ReLU 后,两个负坐标变为 0。关闭 skip 后输出全为 0;因此比较的是固定分支下真实加入/移除恒等项,而不是只比较不同中间位置的均值。
边界与讨论。 无投影且无后激活时,残差分支为零可达到恒等映射。若输出最后必须经过 ReLU,则在整个有正有负的输入域上不可能等于恒等映射;在全非负输入域,F=0 仍可保留输入。BRANCH_GAIN=-1 时,直接路径和分支抵消,说明有 skip 也没有全局梯度下界。实际 postactivation 网络的块输入常已非负,不能用这张有负值的构造输入直接断言原 ResNet 无法保持自身输入。这里检查的是函数与局部导数,训练消融仍须固定初始化、数据、优化预算并比较多个种子。