返回第二讲 · 传统表示的构造核对 · 第二讲导读与学习材料
传统表示按需练习:先问哪个信息被保留,再看哪个信息消失。 这里的方向、视觉词与布局都是明确构造,不读取照片、不下载数据;需要 NumPy、Matplotlib。
| 选一项小问题 | 只改一项 | 最小运行顺序 |
|---|---|---|
| 方向相同,为什么地址不同 | neighbor_cell: [2,4]→[3,3] |
准备 → 第1节投票 → 第2节地址 |
| 亮度幅度改变后,归一化保留什么 | hog_gain: 1→2 |
准备 → 第3节HOG |
| 全图计数看不到的布局,分区能看到吗 | pyramid_grid: [2,2]→[1,2] |
准备 → 第4节共同词典/布局 → 第5节空间计数 |
| 不装额外库,只查词袋与位置 | 保持词编号,修改末尾 tokens 的位置 |
文末独立标准库代码块 |
推荐选择空间计数。 两张图交换上下半部,全局 A/B/C 数量相同。先预测只分左/右能否看到变化,再运行第4–5节,比较向量维数和平方距离;接着改为 [2,1] 单独检验上下分区。
本册是第二讲参考区材料。无标签词典的实际学习继续读 第三讲学习信号;本页的预设分组均值不改称为已训练的 K-means。每次改 P 先重跑准备与对应依赖块;无需从头跑全部章节。
查看代码 · 单元 3
import json
import numpy as np
import matplotlib.pyplot as plt
np.set_printoptions(precision=4, suppress=True)
plt.rcParams.update({'figure.dpi':110,'font.size':10,'axes.spines.top':False,'axes.spines.right':False})
BLUE, GOLD, GREEN, PURPLE = '#002676','#FDB515','#00856A','#69458D'
CHECKS={}; RESULTS={}
def check(name,condition):
    CHECKS[name]=bool(condition)
    assert CHECKS[name], name
def table(headers,rows,title):
    fig,ax=plt.subplots(figsize=(max(7,len(headers)*1.5),1+len(rows)*.36))
    ax.axis('off'); ax.set_title(title,pad=12,color=BLUE)
    tab=ax.table(cellText=rows,colLabels=headers,loc='center',cellLoc='center')
    tab.auto_set_font_size(False);tab.set_fontsize(10);tab.scale(1,1.45)
    for (r,c),cell in tab.get_celld().items():
        cell.set_edgecolor('#CBD5DF')
        if r==0:cell.set_facecolor('#E9F0F7')
    fig.tight_layout();plt.show()

P=dict(sift_rotation=0.0, dominant_orientation=0.0,
       sift_magnitudes=[1.0,2.0,1.0,2.0], neighbor_cell=[2,4],
       hog_angles=[10.0,190.0,90.0],hog_magnitudes=[2.0,2.0,1.0],
       hog_offset=0.0,hog_gain=1.0,normalization_epsilon=1e-6,
       pyramid_grid=[2,2])
P.update(globals().get('USER_OVERRIDES',{}))
print('Teaching configuration:',json.dumps(P,ensure_ascii=False))
1 · r2c3的一格:箭头如何进入八个方向桶
先读箭头,再把票送入桶。 r2c3 中有四个构造梯度;方向为 0°、45°、45°、90°,强度为 1、2、1、2。
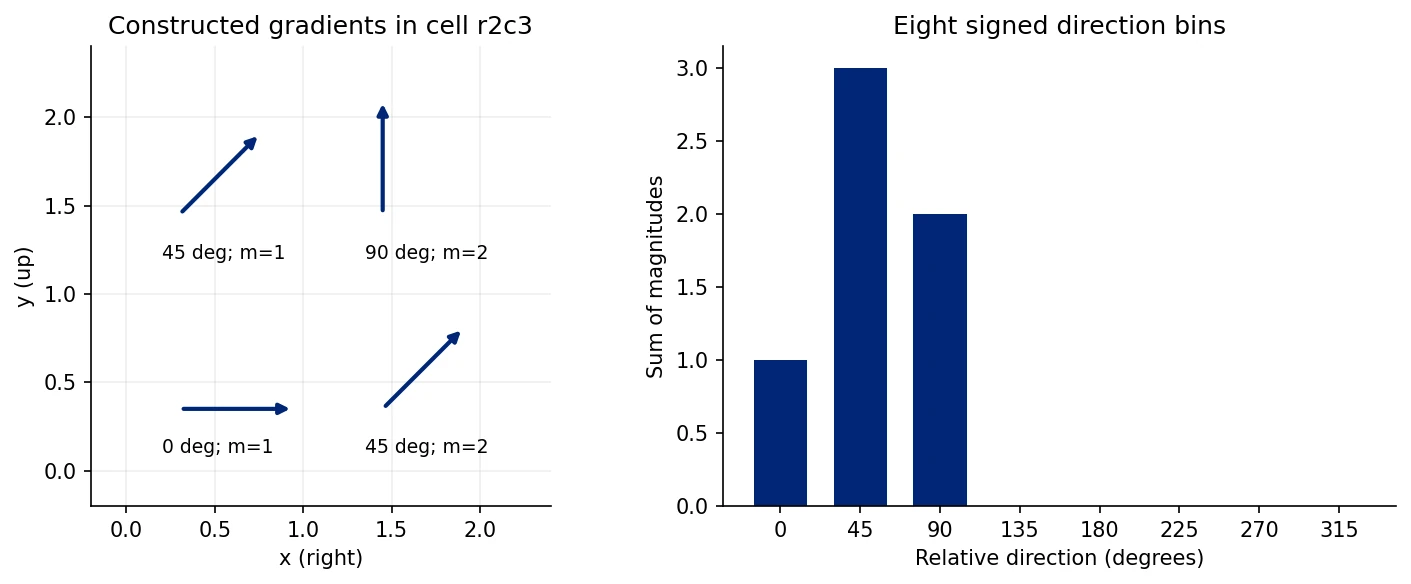
默认参考图:箭头等长,尖端表示方向,m 表示强度;x 向右、y 向上。右侧按强度投票,45° 桶得到 2+1=3。教学构造,由本页代码本地计算,并非真实照片的 SIFT 输出。
再把这一格放回整张描述子。 同样是 45°,r2c3 的票写入索引 49,r2c4 的票写入 57;方向桶相同,空间格使地址不同。
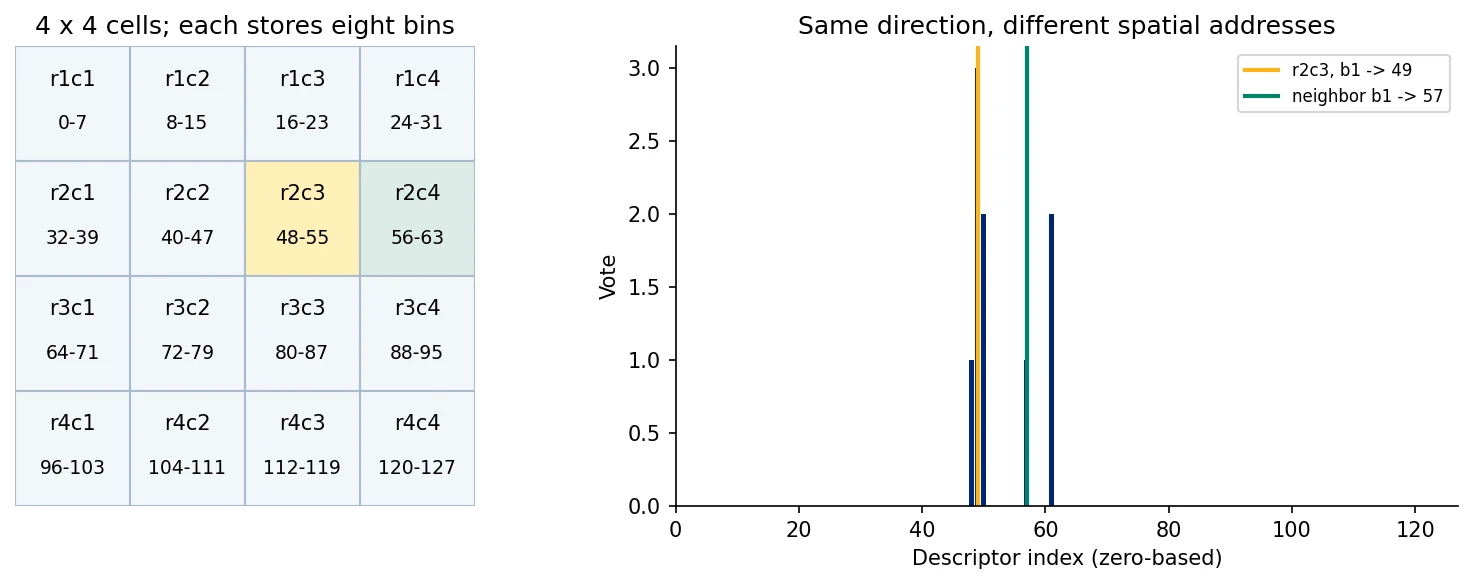
下一节的默认地址构造:行列从 1 编号,方向桶和展开索引从 0 编号。每格 8 个桶,4×4 格共 128 维;其余格置零只为看清地址。下一节会让你亲手移动邻格。
只改一次: 令 sift_rotation=45,保持 dominant_orientation=0,先预测哪几根柱向哪里移动。第二次再将主方向也改为 45,观察相对方向是否恢复。相对方向=输入方向−主方向。
本格使用 8 个中心(0°、45°…315°)的最近中心硬投票;sift_magnitudes 可改强度。完整 SIFT 的插值、加权与归一化在这里暂时省略,先看清一格内部的对应关系。
查看代码 · 单元 6
centers=np.arange(8)*45.
angles=(np.array([0.,45.,45.,90.])+float(P['sift_rotation'])-float(P['dominant_orientation']))%360
mags=np.asarray(P['sift_magnitudes'],dtype=float);assert mags.shape==(4,) and np.all(mags>=0)
def hard_signed_vote(theta,magnitude):
    ids=np.floor((np.asarray(theta)%360)/45.+.5).astype(int)%8
    return np.bincount(ids,weights=magnitude,minlength=8)
sift_hist=hard_signed_vote(angles,mags)
check('SIFT_vote_mass',np.isclose(sift_hist.sum(),mags.sum()))
if np.array_equal(angles,[0,45,45,90]) and np.array_equal(mags,[1,2,1,2]):check('SIFT_slide_r2c3',np.array_equal(sift_hist,[1,3,2,0,0,0,0,0]))
fig,axes=plt.subplots(1,2,figsize=(10,4));origins=np.array([[.3,.35],[1.45,.35],[.3,1.45],[1.45,1.45]])
for (x,y),a,m in zip(origins,angles,mags):
    rad=np.deg2rad(a);axes[0].annotate('',xy=(x+.65*np.cos(rad),y+.65*np.sin(rad)),xytext=(x,y),arrowprops=dict(arrowstyle='-|>',color=BLUE,lw=2))
    axes[0].text(x-.1,y-.25,f'{a:g} deg; m={m:g}',fontsize=9)
axes[0].set(xlim=(-.2,2.4),ylim=(-.2,2.4),aspect='equal',title='Constructed gradients in cell r2c3',xlabel='x (right)',ylabel='y (up)');axes[0].grid(alpha=.2)
axes[1].bar(centers,sift_hist,width=30,color=BLUE);axes[1].set(xticks=centers,xlabel='Relative direction (degrees)',ylabel='Sum of magnitudes',title='Eight signed direction bins')
fig.tight_layout();plt.show()
table(['bin b (zero-based)','direction','vote'],[[i,f'{a:g} deg',f'{v:g}'] for i,(a,v) in enumerate(zip(centers,sift_hist))],'Local direction histogram')
RESULTS['sift_vote']={'relative_angles':angles.tolist(),'histogram':sift_hist.tolist()}
运行后看这里。 先检查8个桶的总票数是否等于输入强度总和,再看旋转后哪几个桶改变。数箭头与按强度投票不是同一个操作。
观察与边界: 默认结果是[1,3,2,0,0,0,0,0]。强度参与加权,而不是简单数箭头。这个离散构造省略了真实SIFT的空间/方向插值、Gaussian加权、截断和归一化,也没有从图像检测主方向;不能据此声称复现完整SIFT或自动旋转不变。
记录: 预测票____;修改____;观察到票怎样移动____;若同步改主方向____。
2 · 相邻格:方向一样,描述子地址仍不同
预测: r2c3中的45°与r2c4中的45°会写入同一个坐标吗?为什么前者为49、后者为57?
可改参数: neighbor_cell默认[2,4],可改[3,3]。行列标签从1开始,方向桶$b$与展开向量索引$j$从0开始:
$$j=((r-1)\times4+(c-1))\times8+b.$$
r2c3占48–55,其中45°桶$b=1$为49。邻格另构造45°票1、225°票2,直方图[0,1,0,0,0,2,0,0]。其余格设0只为看清地址,不表示真实图像平坦。
查看代码 · 单元 11
def address(r,c,b):
    assert 1<=r<=4 and 1<=c<=4 and 0<=b<8
    return ((r-1)*4+c-1)*8+b
nr,nc=map(int,P['neighbor_cell']);assert 1<=nr<=4 and 1<=nc<=4 and (nr,nc)!=(2,3)
neighbor_hist=hard_signed_vote([45,225],[1,2])
descriptor=np.zeros((4,4,8));descriptor[1,2]=sift_hist;descriptor[nr-1,nc-1]=neighbor_hist
flat=descriptor.ravel();focus_j=address(2,3,1);neighbor_j=address(nr,nc,1)
check('SIFT_49_address',focus_j==49)
check('SIFT_neighbor_address_distinct',neighbor_j!=focus_j)
check('SIFT_flatten_roundtrip',np.array_equal(flat.reshape(4,4,8),descriptor))
check('SIFT_128_dimensions',len(flat)==128)
fig,axes=plt.subplots(1,2,figsize=(11,4))
for r in range(4):
    for c in range(4):
        fill='#FFF0B7' if (r,c)==(1,2) else '#DDECE7' if (r,c)==(nr-1,nc-1) else '#F3F6FA'
        axes[0].add_patch(plt.Rectangle((c,3-r),1,1,facecolor=fill,edgecolor='#AABBCD'))
        axes[0].text(c+.5,3-r+.66,f'r{r+1}c{c+1}',ha='center');axes[0].text(c+.5,3-r+.28,f'{address(r+1,c+1,0)}-{address(r+1,c+1,7)}',ha='center',fontsize=9)
axes[0].set(xlim=(0,4),ylim=(0,4),aspect='equal',title='4 x 4 cells; each stores eight bins');axes[0].axis('off')
axes[1].bar(np.arange(128),flat,color=BLUE,width=.8);axes[1].axvline(focus_j,color=GOLD,lw=2,label='r2c3, b1 -> 49');axes[1].axvline(neighbor_j,color=GREEN,lw=2,label=f'neighbor b1 -> {neighbor_j}')
axes[1].set(xlim=(0,127),xlabel='Descriptor index (zero-based)',ylabel='Vote',title='Same direction, different spatial addresses');axes[1].legend(fontsize=8);fig.tight_layout();plt.show()
table(['cell','bin','index','value'],[['r2c3',1,focus_j,float(flat[focus_j])],[f'r{nr}c{nc}',1,neighbor_j,float(flat[neighbor_j])]],'Address and value are different concepts')
RESULTS['sift_address']={'index49_value':float(flat[49]),'neighbor_index':neighbor_j,'descriptor_size':int(flat.size)}
运行后看这里。 并排读 cell / bin / index / value:移动空间格改变的是地址;方向桶编号相同,不意味着128维向量中使用同一个坐标。
观察与边界: 同方向的票在邻格拥有另一组地址;空间格顺序固定后才有可比较的128维坐标。改方向会改值,移动邻格会改地址。128维不等于128个物体类别。真实SIFT的空间插值会让一个梯度对邻格同时贡献,本构造刻意先把这种耦合拆开。
记录: 改前/后邻格地址____;49处的值____;哪个变化来自位置,哪个来自方向____。
3 · HOG:无向梯度,两个相邻桶分票
预测: 10°与190°在无向HOG中是否相同?如果9个桶中心间隔20°,10°、强度2应怎样分给0°与20°?
可改参数: hog_angles、hog_magnitudes、hog_offset、hog_gain。默认[10,190,90]、强度[2,2,1]。角度先mod180,再向相邻桶中心线性分票,末尾与0°循环相接。
这里另把同一方向直方图乘亮度幅度hog_gain,比较原票与L2归一化票。它演示归一化机制,没有构建完整图像HOG。
查看代码 · 单元 16
def unsigned_vote(theta,magnitude,bins=9):
    theta=np.asarray(theta,dtype=float)%180.;magnitude=np.asarray(magnitude,dtype=float)
    assert theta.shape==magnitude.shape and np.all(magnitude>=0)
    q=theta/(180./bins);lo=np.floor(q).astype(int)%bins;fraction=q-np.floor(q)
    hist=np.zeros(bins);np.add.at(hist,lo,magnitude*(1-fraction));np.add.at(hist,(lo+1)%bins,magnitude*fraction)
    return hist
ha=np.asarray(P['hog_angles'],dtype=float)+float(P['hog_offset']);hm=np.asarray(P['hog_magnitudes'],dtype=float)
hog=unsigned_vote(ha,hm);rotated=unsigned_vote(ha+180,hm)
gain=float(P['hog_gain']);assert gain>0;eps=float(P['normalization_epsilon']);assert eps>0
scaled=hog*gain
normalize=lambda a:a/np.sqrt(np.dot(a,a)+eps**2)
check('HOG_unsigned_180_invariance',np.allclose(hog,rotated))
check('HOG_vote_mass',np.isclose(hog.sum(),hm.sum()))
check('HOG_10deg_two_votes',np.allclose(unsigned_vote([10],[2]),[1,1,0,0,0,0,0,0,0]))
fig,axes=plt.subplots(1,2,figsize=(11,4));bins=np.arange(9)*20
axes[0].bar(bins-3,hog,6,color=BLUE,label='base');axes[0].bar(bins+3,scaled,6,color=GOLD,label='gain-scaled')
axes[1].bar(bins-3,normalize(hog),6,color=BLUE,label='base normalized');axes[1].bar(bins+3,normalize(scaled),6,color=GREEN,label='scaled normalized')
for ax in axes:ax.set(xticks=bins,xlabel='Unsigned bin center (degrees)',ylabel='Vote');ax.legend(fontsize=8)
axes[0].set_title('Before normalization');axes[1].set_title('One-vector L2 mechanism');fig.tight_layout();plt.show()
table(['input angle','angle mod 180','magnitude'],[[f'{a:g}',f'{a%180:g}',f'{m:g}'] for a,m in zip(ha,hm)],'Direction polarity is discarded')
print('Raw votes:',hog,' normalized:',normalize(hog))
print('Classic window count: 64 x 128 px / 8 px cells -> 8 x 16 cells; 2 x 2-cell blocks -> 7 x 15 x 36 =',7*15*36)
RESULTS['hog']={'histogram':hog.tolist(),'normalized':normalize(hog).tolist(),'unsigned_180_error':float(np.max(np.abs(hog-rotated))),'illustrative_window_dimensions':3780}
运行后看这里。 左图看缩放后的原票,右图看归一化后的票;10°与190°先取模180后才进入同一组桶。
观察与边界: 无向方向合并了相反梯度;9桶与插值规则必须一起说明。真实HOG通常对包含多个cell的block归一化,并可能使用截断;这里单向量L2只隔离幅度缩放。除以带epsilon的范数近似抵消增益,epsilon并非严格齐次。3780维依赖所写窗口、cell、block及步距配置,不是所有HOG的固定长度。
记录: 预测分票____;角度/增益修改____;票量与归一化形状____;仍缺的完整算法步骤____。
4 · 共同词典:局部模式组成相同,布局仍可不同
两张布局明显不同的图,为什么汇总成同一个向量? 先找出上半部怎样移动,再看最右侧的柱。
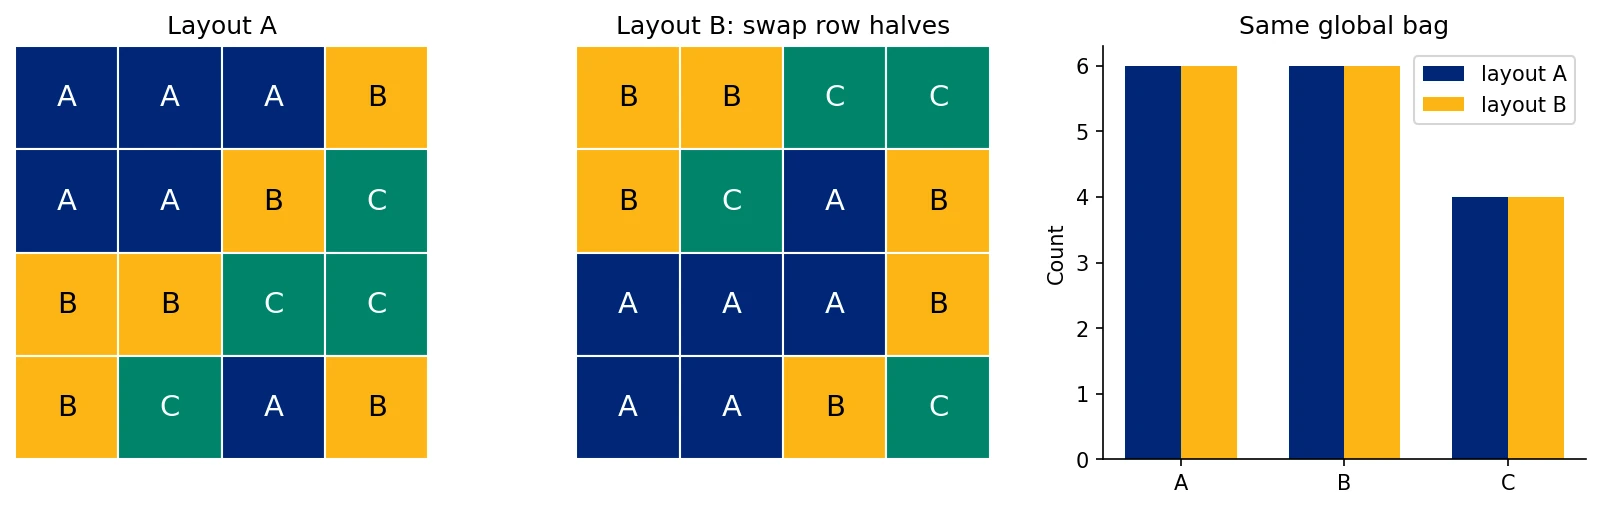
默认参考:A/B/C 是固定共同词典中的视觉词编号。两图都计数为 (6,6,4),只改变了布局。这里是 Slides 的 16 格构造,由本页代码本地计算,不是对象类别或实拍分类结果。
代码先用二维描述检查“最近共同中心 → 编号 → 计数”,中心固定为 (1,1)、(5,4),应用阶段不为每张新图重新聚类。
只改一次: 先交换 WORDS_A 中两个不同词的位置,预测词袋是否变化;另一轮再把一个 A 改成 C,预测哪个柱减少、哪个增加。new_descriptors 可单独用于检查新描述如何分配到同一词典。
这就留下了下一个问题:怎样找回粗布局? 下节沿用同样的 A/B/C 编号,给计数加上区域地址;全图柱仍重合,2×2 区域柱开始不同。
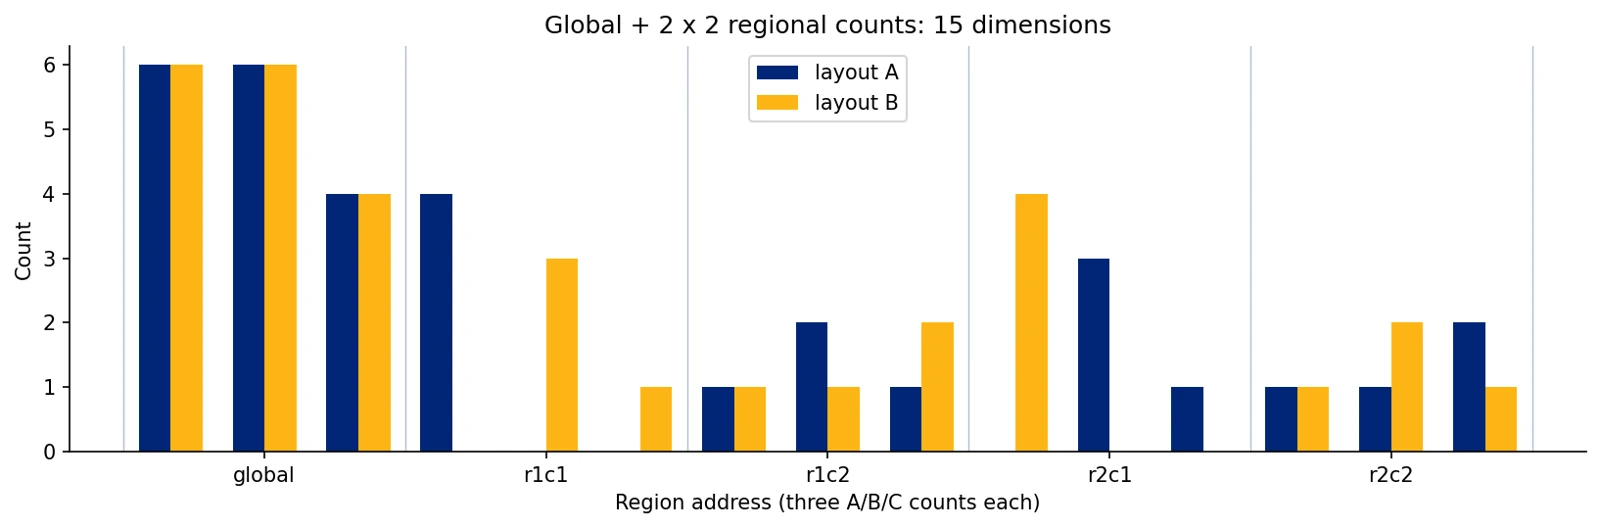
下一节默认构造:全图 3 维 + 四个区域各 3 维 = 15 维,按行优先拼接,各区权重为 1;两向量平方距离为 56。先理解本节为何丢失位置,再进入下一节只分左/右的对照。图由当前代码本地计算。
查看代码 · 单元 21
training_groups=[np.array([[0,0],[0,2],[2,0],[2,2]]),np.array([[4,3],[4,5],[6,3],[6,5]])]
codebook=np.stack([g.mean(0) for g in training_groups])
new_descriptors=np.array([[2.,1.],[4.,4.]]) # 学生可改这两个新局部描述;不要重建词典。
distance=((new_descriptors[:,None,:]-codebook[None,:,:])**2).sum(2)
assignment=distance.argmin(1);counts=np.bincount(assignment,minlength=len(codebook))
table(['new descriptor','nearest center ID','squared distances'],[[str(d.tolist()),int(a)+1,str(ds.tolist())] for d,a,ds in zip(new_descriptors,assignment,distance)],'Training centers retained: (1,1), (5,4)')
SLIDE_WORDS_A=np.array(['A','A','A','B','A','A','B','C','B','B','C','C','B','C','A','B']).reshape(4,4)
WORDS_A=SLIDE_WORDS_A.copy() # 可在这里改位置或组成;例如 WORDS_A[0,0]='C'。
assert WORDS_A.shape==(4,4) and np.isin(WORDS_A,['A','B','C']).all()
WORDS_B=np.vstack([WORDS_A[2:],WORDS_A[:2]])
vocabulary=['A','B','C']
count_words=lambda a:np.array([(a==k).sum() for k in vocabulary])
bag_a,bag_b=count_words(WORDS_A),count_words(WORDS_B)
check('row_permutation_preserves_bag',np.array_equal(bag_a,bag_b))
print('Two layouts actually differ:',not np.array_equal(WORDS_A,WORDS_B))
if np.array_equal(WORDS_A,SLIDE_WORDS_A):check('slide_bag_counts',np.array_equal(bag_a,[6,6,4]))
fig,axes=plt.subplots(1,3,figsize=(11,3.5));colors={'A':BLUE,'B':GOLD,'C':GREEN}
for ax,words,title in zip(axes[:2],[WORDS_A,WORDS_B],['Layout A','Layout B: swap row halves']):
    for r in range(4):
        for c in range(4):
            word=words[r,c];ax.add_patch(plt.Rectangle((c,3-r),1,1,facecolor=colors[word],edgecolor='white'));ax.text(c+.5,3-r+.5,word,ha='center',va='center',color='black' if word=='B' else 'white',fontsize=14)
    ax.set(xlim=(0,4),ylim=(0,4),aspect='equal',title=title);ax.axis('off')
axes[2].bar(np.arange(3)-.17,bag_a,.34,color=BLUE,label='layout A');axes[2].bar(np.arange(3)+.17,bag_b,.34,color=GOLD,label='layout B');axes[2].set(xticks=np.arange(3),xticklabels=vocabulary,ylabel='Count',title='Same global bag');axes[2].legend();fig.tight_layout();plt.show()
RESULTS['bag']={'centers':codebook.tolist(),'assignments':assignment.tolist(),'new_counts':counts.tolist(),'layout_A_counts':bag_a.tolist(),'layout_B_counts':bag_b.tolist()}
# 真正的 Lloyd fit 已独立迁入第三讲 CLS02 前史选读;本节只保留预设均值与布局计数。
运行后看这里。 先确认两张布局图确实不同,再核对两条全局计数是否相同。最近中心分配与空间布局是两项分开的构造,不能把词编号当物体类别。
观察与边界: 默认词袋都是(6,6,4),因此仅依靠该向量的确定性分类器不能区分这两张构造图。中心来自训练描述的约定分组均值,此小构造没有运行完整K-means;真正词典学习应使用训练数据。单张图各自重建编号会破坏已有分类器的坐标含义。
记录: 我只改位置/组成中的____;词袋是否变____;共同词典固定了____;丢失的是____。
另一个实际 fit,而不是改名。 后半代码只把 8 个构造训练描述交给 Lloyd 交替分配/更新中心,不提供类别标签,也不提供原预设分组。迭代目标是训练描述到最近中心的平方距离之和;训练结束后冻结中心与编号,再分配 4 个未参与 fit 的保留描述。图像词典与现代 SSL 都可从无类别标签数据构造学习信号,但目标、参数化和不变性假设不同。这个小实验只证明本代码完成了无标签聚类学习,不证明学到了语义。
只改一个条件:固定训练描述与 seed,只移动一个保留描述,检查训练中心不变、保留分配可能改变。再另起一轮只改训练 seed,比较目标与中心;选择 seed 不能偷看保留标签。本例没有类别标签,也不报告分类准确率。
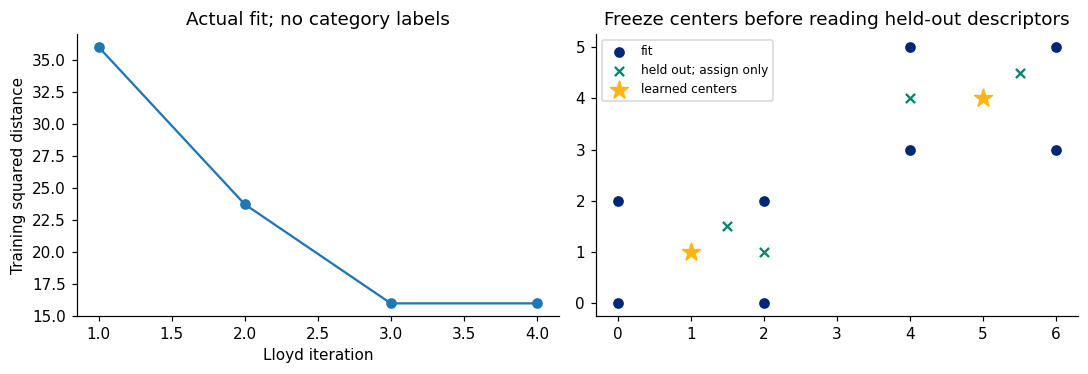
本次本地 CPU 保存输出:seed=20260918;训练平方距离和 36→23.7333→16→16;最终中心 (1,1)、(5,4),保留分配 [0,1,0,1]。描述子是明确构造的数据,fit 是实际执行。Deepnote 云端未运行。
5 · 计数加地址:上/下与二维空间金字塔
预测: 对刚才两张图分别数上半和下半,会得到什么?如果只保留左/右区域,能分开“交换上下半图”吗?
可改参数: pyramid_grid默认[2,2](2行×2列),可试[1,2](左/右)或[2,1](上/下)。网格行列须整除4。
先核对Slides的上(5,2,1)、下(1,4,3),再拼接“全图计数+按行优先的区域计数”。每一级区域权重均为1;这是明确的两级计数构造,不宣称复现论文加权kernel。
查看代码 · 单元 26
upper_a,lower_a=count_words(WORDS_A[:2]),count_words(WORDS_A[2:])
upper_b,lower_b=count_words(WORDS_B[:2]),count_words(WORDS_B[2:])
if np.array_equal(WORDS_A,SLIDE_WORDS_A):check('slide_upper_lower_counts',np.array_equal(upper_a,[5,2,1]) and np.array_equal(lower_a,[1,4,3]))
check('swapped_regions',np.array_equal(upper_a,lower_b) and np.array_equal(lower_a,upper_b))
table(['layout','global A/B/C','upper A/B/C','lower A/B/C'],[['A',str(bag_a.tolist()),str(upper_a.tolist()),str(lower_a.tolist())],['B',str(bag_b.tolist()),str(upper_b.tolist()),str(lower_b.tolist())]],'Coarse spatial addresses restore a distinction')
gr,gc=map(int,P['pyramid_grid']);assert gr>0 and gc>0 and 4%gr==0 and 4%gc==0
def pyramid(words,rows,cols):
    result=[count_words(words)];names=['global']
    for r in range(rows):
        for c in range(cols):
            patch=words[r*4//rows:(r+1)*4//rows,c*4//cols:(c+1)*4//cols]
            result.append(count_words(patch));names.append(f'r{r+1}c{c+1}')
    return np.concatenate(result),names
pa,regions=pyramid(WORDS_A,gr,gc);pb,_=pyramid(WORDS_B,gr,gc)
check('pyramid_dimensions',len(pa)==3*(1+gr*gc))
check('pyramid_count_mass',pa.sum()==pb.sum()==32) # 每个词在全图和区域级各计一次。
fig,ax=plt.subplots(figsize=(11,3.7));ids=np.arange(len(pa));ax.bar(ids-.17,pa,.34,label='layout A',color=BLUE);ax.bar(ids+.17,pb,.34,label='layout B',color=GOLD)
ax.set(xticks=np.arange(len(regions))*3+1,xticklabels=regions,xlabel='Region address (three A/B/C counts each)',ylabel='Count',title=f'Global + {gr} x {gc} regional counts: {len(pa)} dimensions')
for edge in np.arange(len(regions)+1)*3-.5:ax.axvline(edge,color='#ADBFD2',lw=.7)
ax.legend();fig.tight_layout();plt.show()
distance2=int(np.square(pa-pb).sum())
print('Squared distance: bag =',int(np.square(bag_a-bag_b).sum()),'; pyramid =',distance2)
RESULTS['pyramid']={'grid':[gr,gc],'dimensions':len(pa),'squared_distance':distance2,'vector_A':pa.tolist(),'vector_B':pb.tolist()}
print('Checks passed:',sum(CHECKS.values()),'/',len(CHECKS))
运行后看这里。 核对 grid / dimensions / squared_distance:全图3维加每个分区3维,改变网格同时改变表示长度与可区分的布局。
观察与边界: 默认2×2区域能区分布局;只分左/右时,这次上下交换仍可能不可见。保留多少位置不是越多越好:细网格维度更大,也可能对小位移更敏感。区域内部重排仍可能得到相同计数;金字塔没有恢复原图全部位置。
记录模板(自愿练习): 我认为应保留的空间差异____;只改网格____;预测距离____;实际距离____;仍然不可见的重排____。
来源与身份
- 对齐当前Slides
sift-local-descriptor的构造r2c3、邻格、索引49;hog-local-shape的无向方向组织;codebook-training-versus-assignment与spatial-pyramid-restores-position的共同坐标和布局取舍。 - 算法背景:Lowe, SIFT (2004)、Dalal & Triggs, HOG (2005)、Lazebnik et al., Spatial Pyramid (2006)。本页为新写的小机制构造,不是这些论文的完整实现或实验复现。
- 既有
public/content/features-v5.json中保存了真实计算的SIFT/HOG/词频及其来源说明;本Notebook默认不依赖该文件,也不把本页构造值冒充其中实测值。 - 2025Fall/2026Spring卷积与LeNet历史快照属于算子/模型主题;本页不把这些历史notebook误列为SIFT/HOG实现来源。没有读取或复用历史评论答案。
返回课堂导读 · 返回幻灯片
按问题查阅:补充推导与机制核对
按问题查阅。 下方第1–5节分别补充局部描述、HOG、共同词典与空间地址、分类器读出和部件结构。它们解释前面短练省略了什么,不是需要全部复现的训练流水线。
若只想做一个无需额外库的核对,可直接去文末“独立核对:先预测,再运行”。
1. 从滤波器组到可比较的局部描述
滤波器组用不同方向、尺度的局部测量描述纹理。亮度值相同的像素,周围结构可能不同;多种响应组成的向量能保留这些差别。选择哪几种测量仍是建模决定。
SIFT 的关键点检测与描述是两个阶段。尺度空间中,相邻模糊图相减形成 DoG;一个候选与本层 8 点、相邻尺度各 9 点比较,共 26 个邻居。极值只是候选,后续还需定位并检查对比度和边缘响应稳定性。
以关键点尺度和主方向建立局部坐标后,描述子在 4×4 个空间格中分别统计 8 个方向桶,形成 128 个分量。每个数有“格子位置+方向”的地址。贡献在相邻空间格与方向桶间插值,之后归一化、截断、再次归一化,减少量化与局部幅值变化的影响;128 不是 128 个对象类别。
匹配还要检查歧义。最近/次近距离 0.20/0.80 的比为 0.25,而 0.20/0.22 约为 0.91。最近距离一样,独特性却不同。距离比筛选不能替代多个匹配的几何一致性检查。主讲的旋转 24°、缩放 0.78 对应实验检验局部匹配,不是整图分类准确率。
先判断:为什么已经找到最近描述,还要看次近描述?
核对提示:重复纹理可能产生多个同样相近的候选。最近/次近比值衡量相对歧义;即使通过筛选,仍可能出现不符合整体几何关系的匹配。
来源与继续阅读
2. HOG:一个像素怎样进入一个窗口向量
HOG 围绕固定分析窗口和规则网格组织方向统计,和每个 SIFT 关键点的局部坐标体系不同。它可以直接把窗口描述交给分类器,不必绕经视觉词袋。
课程保存的实际像素测量位于窗口第 5 行第 4 列 cell(程序索引 row=4,col=3):方向约 170.64°,幅值 0.36168。无符号方向中 180° 与 0° 相接,贡献按角度分到 160° 桶约 0.16927、0° 桶约 0.19241,两份相加仍为原幅值。这里给的是先前计算并保留的数值,不是本次重新运行测得的结果。
在 64×128 窗口、8×8 像素 cell、9 个方向桶的具体配置下,2×2 cells 构成 36 维 block;按一个 cell 步长滑动,共 (8−1)×(16−1)=7×15 个 block,拼接为 3780 维。相邻 block 重叠,使同一 cell 参加不同的局部归一化。改变配置,维度也会变。
先判断:为什么不能直接用 8×16×9 算作这个 HOG 配置的最终长度?
核对提示:那是逐 cell 直方图的长度,尚未按重叠的 2×2 block 做归一化与拼接。最终向量包含重叠 block 的多份局部表示。
来源与继续阅读
3. 共同词典、层级地址与位置交换
课程的街景展示先前实际提取的 600 个 SIFT 描述,经归一化后聚为 K=6 个簇。词中心是 128 维数值向量;代表裁片来自靠近中心的真实观测,不是“中心生成的物体”。编号 1–6 不预先代表车轮、窗户等语义类别。
用于分类时,词典应由训练数据建立,新图沿用同一套中心与编号,再统计数量。如果每张图独立聚类,“词 1”的含义会改变,分类器收到的坐标便失去共同定义。街景六词计数只演示描述与量化,没有连到一个已经训练好的街景分类器。
纯词袋只保留各词总数。交换同一批已提取描述的位置,计数不变,布局差别被合并。空间金字塔让计数附带区域地址:全图 1 格、2×2 的 4 格、4×4 的 16 格,共 21 个区域;K=3 时有 63 个分量。同一描述可进入不同层级,越细的格子越能区别布局,也越容易受跨格移动影响。这里的 16 个描述位置交换是独立的手工构造,不能说成街景分类实验。
先判断:位置交换后,什么时候全局词袋不变而空间统计改变?
核对提示:固定词典和已提取描述,只改变它们的坐标时,全局计数不变;只要跨过所选区域边界,区域计数就可能改变。若重新从修改后的像素提取描述,还会引入另一种变化,必须另行说明。
来源与继续阅读
4. 分类器读出:分数、间隔和表示各做什么
标签训练决定特征空间中的边界,新图沿同一表示与权重计算分数。以 w=(1,0),b=−1 为例,边界是 x₁=1;点 (3,1) 的分数为 2。同时将 w,b 乘 10,边界不变,分数变 20,但分数除以 ‖w‖ 得到的有符号几何距离仍为 2。裸分数不能直接当距离。
二分类 hinge=max(0,1−ys) 鼓励功能间隔,配合权重惩罚才约束参数尺度。主讲只需训练与应用接口,本节才展开间隔的含义。
“线性”描述的是当前特征空间中的读出。手工构造的内外环例子中,外点半径平方为 4,内点为 0.25;映射 φ(x)=x₁²+x₂² 后可以用一维阈值区分。这个新表示改变了系统,不是仅把同一批原坐标的线性参数调好。课程的二维 SVM 训练点、内外环和街景词袋是不同算例。
先判断:若新表示提高了分类准确率,可以把全部收益归给 SVM 吗?
核对提示:不能。前面的表示改变了哪些信息可被简单边界读取。应固定数据协议,并明确比较的是完整流程还是相同特征上的分类器。
来源与继续阅读
5. 从统计到部件:结构先验并非 CNN 才出现
DPM 同时使用对象整体的根模型、局部部件响应和形变代价,允许部件偏离参考位置,承担检测中的类别与位置判断。以同一个根框为参照:候选 A 外观分 4、偏移 0,总分 4;候选 B 外观分 6、偏移 3、代价 0.5Δx²=4.5,总分 1.5。因此局部最像的部件,不一定组成总分最高的布局。
传统流程持续发展:2010 年 NEC–UIUC 系统使用 SIFT/LBP、非线性编码与随机 SVM,2011 年 XRCE 使用高维 Fisher 表示等机制。这里是既有历史系统资料,不能从两个名称推导某个单一组件的因果效果。
传统路线已经包含学习词典、训练分类器和结构先验。端到端 CNN 的转折是让最终任务误差可以继续影响前端测量;它没有取消人工选择局部性、共享和网络结构。前端已经丢掉的区别,后端无法凭空恢复,因而需要判断哪些接口应当由任务共同调整。
先判断:DPM 的形变代价和词袋的位置忽略,分别表达什么偏好?
核对提示:DPM 保留相对布局并允许有代价的移动;纯词袋主动合并位置差别。它们针对不同任务与计算组织,不应排成简单的“有位置就更好”。
来源与继续阅读
- Felzenszwalb et al. · Object Detection with Discriminatively Trained Part-Based Models (2010)
- ILSVRC 2012 · Official Results
- Felzenszwalb et al. · Object Detection with Discriminatively Trained Part-Based Models (2010)
- CS231n 2026 · CNNs
- Krizhevsky et al. · ImageNet Classification with Deep CNNs (2012)
- ILSVRC 2010 · Official Results and Descriptions
- ILSVRC 2011 · Official Results and Descriptions
从主讲继续:推导边界与研究来源
把传统流程的训练与应用分别写一遍:训练图建立共同词典,标签训练读出;新图沿用词典编号、统计方式与分类器权重。SIFT 对应、HOG 投票、街景六词计数、位置交换与二维 SVM 的算例身份必须分别保留。用流程图连接接口,不把它们拼成一次已经完成的端到端街景分类实验。
主讲研究来源
- CS231n 2026 · CNNs
- Sivic & Zisserman · Video Google (2003)
- Lazebnik et al. · Beyond Bags of Features (2006)
- Lowe · Distinctive Image Features from Scale-Invariant Keypoints (2004)
- OpenCV 4.13 · Introduction to SIFT
- Dalal & Triggs · Histograms of Oriented Gradients (2005)
- Felzenszwalb et al. · Object Detection with Discriminatively Trained Part-Based Models (2010)
- Csurka et al. · Visual Categorization with Bags of Keypoints (2004)
- CS231n 2026 · Image Classification with Linear Classifiers
- ILSVRC 2012 · Official Results
- D2L · Convolutions for Images
- D2L · LeNet
独立核对:先预测,再运行
下面是完整、独立的小规模 Python 核对,只使用标准库;无需下载、安装、训练或访问外部服务。它保留“教学构造”的身份。先写预测,运行后解释哪一项支持判断,再只改一个条件复查。下方没有预填远端执行输出。
查看代码 · 单元 48
# 独立构造:只交换已提取描述的位置,词编号固定。
from collections import Counter
tokens=[('A',0.1),('A',0.2),('B',0.7),('B',0.8)]
swapped=[(word,1-y) for word,y in tokens]
def describe(rows):
    return dict(global_counts=dict(Counter(w for w,y in rows)),
                top=dict(Counter(w for w,y in rows if y<.5)),
                bottom=dict(Counter(w for w,y in rows if y>=.5)))
before,after=describe(tokens),describe(swapped)
print('原布局',before,'\n交换位置',after)
assert before['global_counts']==after['global_counts']
assert before['top']!=after['top']
print('HOG 配置维度:',(64//8-1)*(128//8-1)*2*2*9)
print('三层金字塔 K=3:',(1+4+16)*3)
assert abs(.16927+.19241-.36168)<1e-10
继续一步:修改一个数值或条件,先写变化方向,再运行核对。不要删除断言来让代码“通过”;若主动改变了断言的前提,应同时写出新预期。机制小算例通过,只说明这一小段计算与预期一致,不等于完整图像实验或新架构训练成功。