推荐的轻量课堂练习:一次梯度,到底更新了什么? 沿用课件的四个灯态、分数 [2,1,0] 和标量模型;数据由本页构造,不下载图像、不训练神经网络。
| 想观察的问题 | 只改哪个 P 参数 |
运行哪些块、看什么 |
|---|---|---|
| 表示可分,读出也会错吗 | lamp_threshold: 0.5→1.1 |
准备块 → 第1节;看四态表中B/C预测 |
| 同一梯度,步长不同会怎样 | scalar_lr: 0.1→0.3,再单独试0.55 |
准备块 → 第3节;看新参数、新前向和新损失 |
| 为什么有的更新振荡却收敛 | learning_rates 加入0.5 |
准备块 → 第3节 → 第4节;看倍率与左右两图 |
| 验证为什么不能与测试混用 | split_mode: 'random'→'ordered' |
准备块 → 第5节;看划分区间、选中次数与误差 |
先做第3节。 固定 x=2,t=0,w=1,先算旧梯度,再预测一次更新后的 w′、y′、L′;运行后解释为什么“越过最小点”不一定增大损失。
需要 NumPy、Matplotlib。修改开头的 P 后先重跑准备块,再跑表中对应模块;第4节使用第3节定义的 scalar_loss。如果使用过 USER_OVERRIDES,它会覆盖 P 中同名值,先清除该覆盖或重启自己的运行环境。只看参考图时无需执行。
查看代码 · 单元 3
import json
import numpy as np
import matplotlib.pyplot as plt
np.set_printoptions(precision=4, suppress=True)
plt.rcParams.update({'figure.dpi':110,'font.size':10,'axes.spines.top':False,'axes.spines.right':False})
BLUE, GOLD, GREEN, PURPLE = '#002676','#FDB515','#00856A','#69458D'
CHECKS={}; RESULTS={}
def check(name,condition):
    CHECKS[name]=bool(condition)
    assert CHECKS[name], name
def table(headers,rows,title):
    fig,ax=plt.subplots(figsize=(max(7,len(headers)*1.5),1+len(rows)*.36))
    ax.axis('off'); ax.set_title(title,pad=12,color=BLUE)
    tab=ax.table(cellText=rows,colLabels=headers,loc='center',cellLoc='center')
    tab.auto_set_font_size(False);tab.set_fontsize(10);tab.scale(1,1.45)
    for (r,c),cell in tab.get_celld().items():
        cell.set_edgecolor('#CBD5DF')
        if r==0:cell.set_facecolor('#E9F0F7')
    fig.tight_layout();plt.show()

P=dict(lamp_gain=1.0, lamp_threshold=0.5, softmax_shift=100.0, softmax_scale=2.0,
       scalar_lr=0.1, steps=20, learning_rates=[0.05,0.1,0.25,0.45,0.55],
       regression_seed=20260921, regression_noise=0.20, regression_train_n=24,
       regression_degrees=[1,3,9], regression_ridge=1e-4, split_mode='random')
# 批量验证入口;平常只需改上面的P,不需要设置USER_OVERRIDES。
P.update(globals().get('USER_OVERRIDES',{}))
print('Teaching configuration:',json.dumps(P,ensure_ascii=False))
1 · 同样四个输入,换成两个隐藏坐标
先认出同一个样本,再看坐标怎样变。 左图 A=(0,0)、B=(1,0)、C=(0,1)、D=(1,1);B、C 同类,A、D 同类。右图没有换标签,只把输入变成两个隐藏坐标。
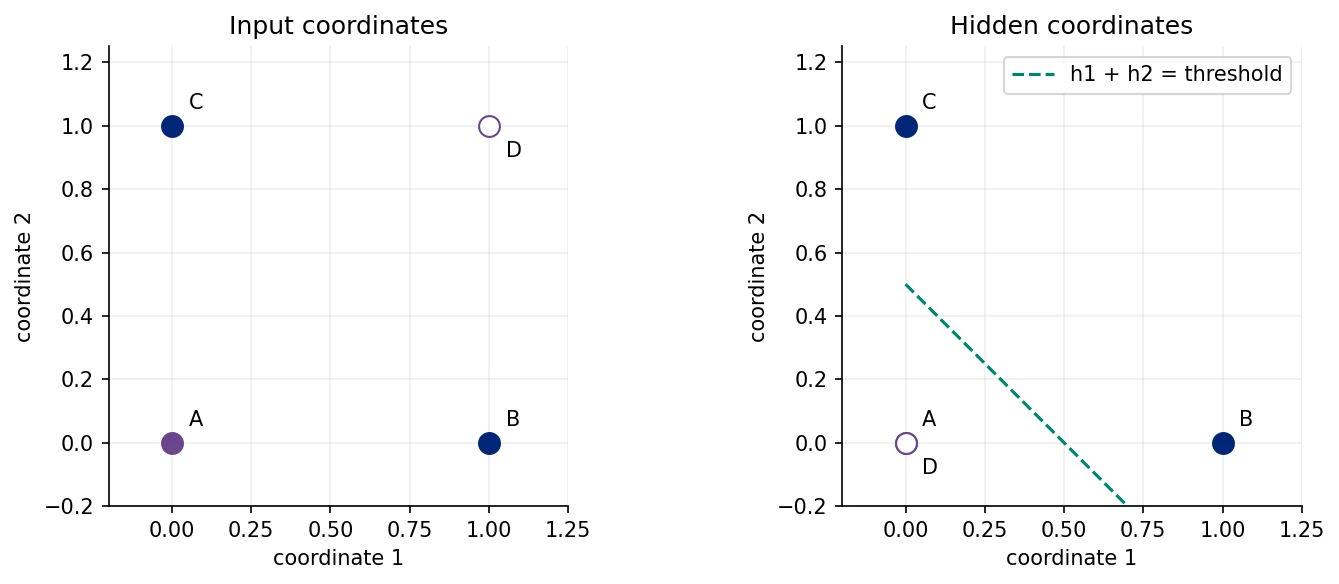
默认参考图:本页代码的本地执行,gain=1、threshold=.5。蓝色 B/C 与紫色 A/D 是两类;A、D 在右图重合。虚线是读出边界。
手工指定 $h_1=\max(0,a(x_1-x_2))$、$h_2=\max(0,a(x_2-x_1))$,以 $h_1+h_2>\tau$ 判正类。先指图: D 为什么从右上角落到原点?B、C 为什么还能被一条直线分出来?
只改一次: 保持 lamp_gain=1,把 lamp_threshold 从 .5 改成 1.1。运行前在图上想象虚线移动:先预测错的是哪两个样本,再运行四态表。这样能区分“表示仍可分”和“读出阈值选错”。
查看代码 · 单元 6
lamps=np.array([[0.,0.],[1.,0.],[0.,1.],[1.,1.]])
labels=np.array([0,1,1,0]);names=['A','B','C','D']
gain=float(P['lamp_gain']);threshold=float(P['lamp_threshold'])
assert gain>0,'本模块约定正gain;负gain请先重写预测。'
raw=lamps@np.array([[gain,-gain],[-gain,gain]])
hidden=np.maximum(raw,0);scores=hidden.sum(1)-threshold;pred=(scores>0).astype(int)
check('lamp_hidden_formula',np.allclose(hidden,[[0,0],[gain,0],[0,gain],[0,0]]))
check('without_relu_two_differences_cancel',np.allclose(raw.sum(1),0))
table(['ID','input','hidden','score','label','prediction'],
      [[names[i],str(lamps[i].astype(int).tolist()),str(hidden[i].tolist()),f'{scores[i]:.3f}',int(labels[i]),int(pred[i])] for i in range(4)],
      'Same four lamp states, different coordinates')
fig,axes=plt.subplots(1,2,figsize=(10,4))
for ax,points,title in zip(axes,[lamps,hidden],['Input coordinates','Hidden coordinates']):
    for i,(x,y) in enumerate(points):
        ax.scatter(x,y,s=100,facecolors='white' if i==3 else (BLUE if labels[i] else PURPLE),edgecolors=BLUE if labels[i] else PURPLE,zorder=3)
        dy=-.10 if i==3 else .08
        ax.annotate(names[i],(x,y),xytext=(8,-15 if i==3 else 8),textcoords='offset points')
    lim=max(1,gain)*1.25;ax.set(xlim=(-.2,lim),ylim=(-.2,lim),title=title,xlabel='coordinate 1',ylabel='coordinate 2');ax.set_aspect('equal');ax.grid(alpha=.2)
axis=np.linspace(0,max(gain,threshold,1),100)
axes[1].plot(axis,threshold-axis,'--',color=GREEN,label='h1 + h2 = threshold');axes[1].legend()
fig.tight_layout();plt.show()
RESULTS['lamps']={'hidden':hidden.tolist(),'predictions':pred.tolist(),'accuracy':float((pred==labels).mean())}
运行后看这里。 看四态表的 hidden 与 prediction:表示坐标不变而预测改变,说明这次改的是读出阈值。保存图仍显示默认值;你的新图在代码输出区。
观察与边界: 默认B、C落在两条轴上,A、D落在原点;换表示后可由直线读出。去掉ReLU,两条方向差相加恒为0。手工找到一个解证明“能够表达”,没有证明训练一定会找到它;改变阈值导致失败也不等于隐藏表示失去可分性。
留给你的记录: 修改前预测____;只改了____;四行中变化的是____;这个变化发生在表示还是读出____。
2 · Softmax:共同平移不变,缩放会改变概率
预测: 把(2,1,0)整体加100,概率会怎样?所有分数乘2,类别排序与概率会分别怎样?
可改参数: softmax_shift、正的softmax_scale。先运行默认值,再试scale=.5。
下面先减去最大logit计算softmax。图表比较基础、平移、缩放;同时计算真值概率.6/.2/.01的交叉熵,并以有限差分验证$\partial L/\partial z=p-\mathrm{onehot}(y)$。
查看代码 · 单元 11
def softmax(z):
    z=np.asarray(z,dtype=float);e=np.exp(z-z.max());return e/e.sum()
def ce_logits(z,target):
    z=np.asarray(z,dtype=float);m=z.max();return float(m+np.log(np.exp(z-m).sum())-z[target])
z=np.array([2.,1.,0.]);assert P['softmax_scale']>0
p0=softmax(z);ps=softmax(z+P['softmax_shift']);pt=softmax(z*P['softmax_scale'])
check('softmax_translation',np.allclose(p0,ps,rtol=1e-12,atol=1e-12))
check('softmax_positive_scale_preserves_argmax',p0.argmax()==pt.argmax())
check('softmax_probabilities_sum_to_one',all(np.isclose(p.sum(),1) for p in [p0,ps,pt]))
table(['configuration','p(A)','p(B)','p(C)','CE if A true'],[[name,*[f'{v:.4f}' for v in prob],f'{-np.log(prob[0]):.4f}'] for name,prob in [('base',p0),('common shift',ps),('positive scale',pt)]],'Relative scores determine probabilities')
fig,ax=plt.subplots(figsize=(8,3.5));pos=np.arange(3)
for j,(p,name,color) in enumerate([(p0,'base',BLUE),(ps,'shift',GOLD),(pt,'scale',GREEN)]):ax.bar(pos+(j-1)*.23,p,.23,label=name,color=color)
ax.set(xticks=pos,xticklabels=['A','B','C'],ylim=(0,1),ylabel='Probability');ax.legend();fig.tight_layout();plt.show()
truth_prob=np.array([.6,.2,.01]);losses=-np.log(truth_prob)
table(['True-class probability','Cross-entropy'],[[f'{p:.2f}',f'{l:.4f}'] for p,l in zip(truth_prob,losses)],'Higher true-class probability, smaller cross-entropy')
eps=1e-5;numeric=np.array([(ce_logits(z+eps*np.eye(3)[i],0)-ce_logits(z-eps*np.eye(3)[i],0))/(2*eps) for i in range(3)])
analytic=p0-np.array([1,0,0]);check('CE_logit_gradient',np.allclose(numeric,analytic,atol=1e-9))
print('CE gradient, analytic:',analytic,' finite difference:',numeric)
RESULTS['softmax']={'base':p0.tolist(),'shifted':ps.tolist(),'scaled':pt.tolist(),'CE_examples':losses.tolist(),'gradient_max_error':float(np.max(np.abs(numeric-analytic)))}
# Exact logical counterexample: real class A=0; predicted class B stays wrong.
wrong_probs=np.array([[.1,.9],[.01,.99]],dtype=float)
wrong_entropy=-(wrong_probs*np.log(wrong_probs)).sum(1)
wrong_ce=-np.log(wrong_probs[:,0])
wrong_pred=wrong_probs.argmax(1)
assert np.array_equal(wrong_pred,[1,1])
assert wrong_entropy[1]<wrong_entropy[0] and wrong_ce[1]>wrong_ce[0]
table(['p(A)','p(B)','H (natural log)','CE if A true','correct?'],
      [[*p,round(float(h),6),round(float(l),6),False] for p,h,l in zip(wrong_probs,wrong_entropy,wrong_ce)],
      'Entropy falls while the prediction stays wrong: exact construction')
RESULTS['entropy_counterexample']={'probabilities':wrong_probs.tolist(),'entropy_nats':wrong_entropy.tolist(),
 'true_class':0,'predictions':wrong_pred.tolist(),'cross_entropy':wrong_ce.tolist(),'identity':'exact mathematical construction; no Tent execution'}
print('This is not a measured Tent trajectory. It only refutes entropy decrease => correctness.')
运行后看这里。 核对三组概率:共同平移应保持整行,正缩放保持最高类但改变概率。再看 CE gradient 的解析值与有限差分;两者一致只检验本算例导数。
观察与边界: 正倍缩放保持argmax,却改变概率与损失;这不是校准能力或泛化能力改善的证据。共同平移不变来自归一化。数值稳定实现避免大指数溢出;也不意味着机器能精确区分任意大的共同偏移。
记录: 预测____;修改____;排序是否变化____;真值概率/损失变化____;需要怎样的数据才能讨论校准____。
连到无标签适应。 当真类为 A,(0.1,0.9)→(0.01,0.99) 的自然对数熵从 0.325083 降到 0.056002,预测仍错,真类交叉熵反而从 2.302585 升到 4.605170。监督训练用标签定义纠错方向;部署时能计算熵并不意味着拿到了答案。这里仅核对逻辑反例,真实适应帮助或失败要由独立 source/norm/Tent 实验评价。
3 · 一个完整学习步:先求导,再改参数,再重新前向
预测: 固定$x=2,t=0,w=1$,$y=wx$、$L=\frac12(y-t)^2$。旧点梯度为什么为4?学习率.1之后,哪些数必须重算?
可改参数: scalar_lr,默认.1;可试.3或.55。先记录你预计的$w'$与$L'$,再运行。
查看代码 · 单元 16
scalar_x,scalar_t,scalar_w=2.,0.,1.
def scalar_loss(w):return .5*(scalar_x*w-scalar_t)**2
old_y=scalar_x*scalar_w;old_loss=scalar_loss(scalar_w)
upstream=old_y-scalar_t;local=scalar_x;gradient=upstream*local
numeric=(scalar_loss(scalar_w+1e-5)-scalar_loss(scalar_w-1e-5))/(2e-5)
eta=float(P['scalar_lr']);new_w=scalar_w-eta*gradient;new_y=scalar_x*new_w;new_loss=scalar_loss(new_w)
check('scalar_chain_rule',np.isclose(gradient,4) and np.isclose(numeric,gradient,atol=1e-9))
if eta==.1:check('slide_scalar_update',np.allclose([new_w,new_y,new_loss],[.6,1.2,.72]))
table(['state','w','y','loss','gradient used'],[['before',scalar_w,old_y,old_loss,gradient],['after',f'{new_w:.4f}',f'{new_y:.4f}',f'{new_loss:.4f}','old-point g=4']],'One update, then a fresh forward pass')
grid=np.linspace(min(-.4,new_w-.3),max(1.3,new_w+.3),250)
fig,ax=plt.subplots(figsize=(8,3.6));ax.plot(grid,scalar_loss(grid),color=BLUE,label='L(w)=2w^2');ax.scatter([scalar_w,new_w],[old_loss,new_loss],c=[GOLD,GREEN],s=85,zorder=3)
ax.annotate('old',(scalar_w,old_loss),xytext=(8,10),textcoords='offset points');ax.annotate('new',(new_w,new_loss),xytext=(8,10),textcoords='offset points')
ax.annotate('',xy=(new_w,-.15),xytext=(scalar_w,-.15),arrowprops=dict(arrowstyle='->',color=GREEN));ax.set(xlabel='Parameter w',ylabel='Loss',title=f'Learning rate = {eta:g}');ax.legend();fig.tight_layout();plt.show()
RESULTS['scalar']={'gradient':gradient,'eta':eta,'w_new':new_w,'y_new':new_y,'loss_new':new_loss}
运行后看这里。 对照 before / after 两行:梯度来自旧点,更新后损失必须重新前向计算。请把你的 w′、y′、L′ 与预测逐项核对。
观察与边界: 反向求导时$w$仍为1;优化器随后改$w$,新损失来自新前向。旧梯度4不是新位置的梯度。越过最小点未必损失增大:例如.3会越过0,但仍更接近0;学习率过大则可能增大损失。
记录: 预测$w'$____、$L'$____;运行读数____;旧梯度与新梯度分别是____。
4 · 重复同一步,学习率如何改变整个轨迹
把同一步重复 20 次。 同一个目标 $L=2w^2$、同一个起点 $w_0=1$,现在只改变学习率。
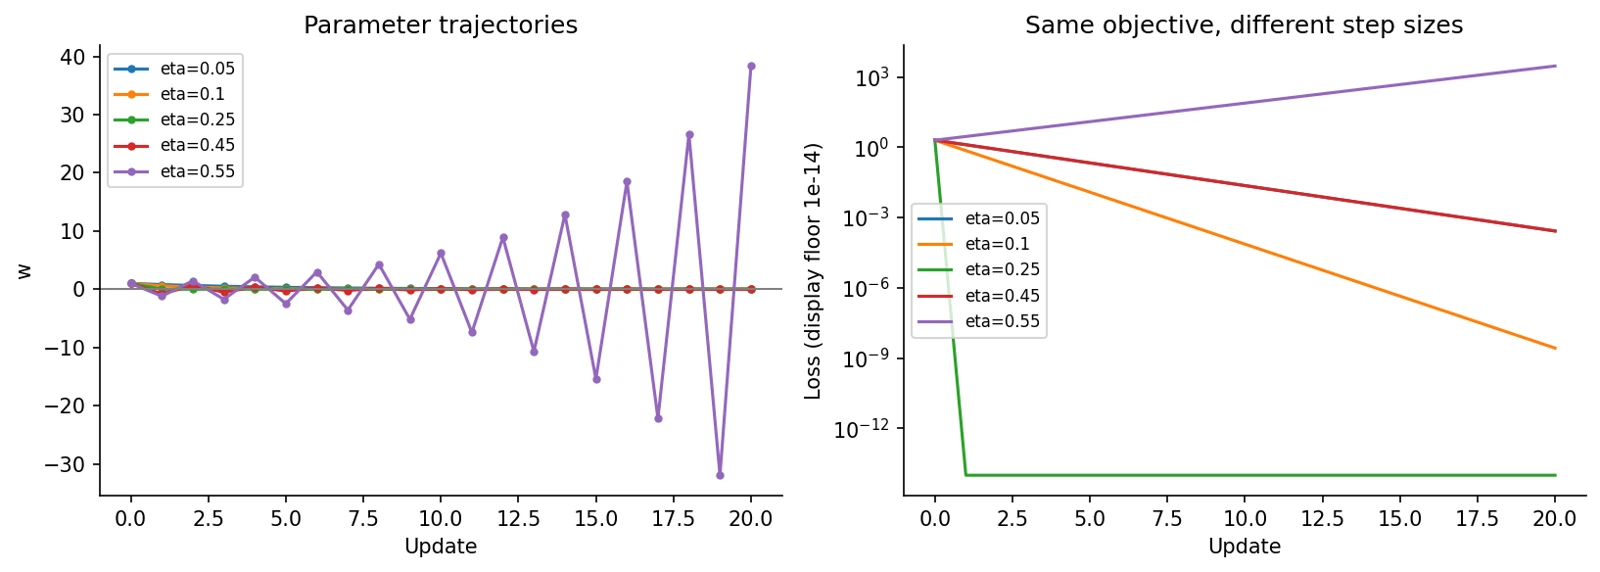
默认参考图:左图是 w,右图是损失的对数坐标。学习率 .55 的轨迹逐渐放大,压缩了左图其余曲线的可见幅度;请结合右图读取收敛情况。显示损失下限为 10⁻¹⁴,计算值没有截断。教学构造,本地运行。
递推式是 $w_{k+1}=(1-4\eta)w_k$。先找一对: .05 与 .45 的参数符号行为不同,为什么右图的损失轨迹却重合?
只改一次: 在 learning_rates 中加入 .5,保持 steps=20。根据倍率 $1-4\eta$ 预测同号收敛、交替收敛、来回振荡或放大,再运行。这里的阈值属于这一个二次函数。
查看代码 · 单元 21
steps=int(P['steps']);assert 1<=steps<=100
rates=list(map(float,P['learning_rates']));assert all(0<=r<=1 for r in rates)
traces={}
for rate in rates:
    ws=[1.]
    for _ in range(steps):ws.append(ws[-1]-rate*4*ws[-1])
    ws=np.array(ws);check(f'scalar_closed_form_eta_{rate}',np.allclose(ws,(1-4*rate)**np.arange(steps+1)))
    traces[rate]=ws
fig,axes=plt.subplots(1,2,figsize=(11,4))
for rate,ws in traces.items():
    axes[0].plot(ws,marker='.',label=f'eta={rate:g}')
    axes[1].semilogy(np.maximum(scalar_loss(ws),1e-14),label=f'eta={rate:g}')
axes[0].set(xlabel='Update',ylabel='w',title='Parameter trajectories');axes[0].axhline(0,color='grey',lw=1)
axes[1].set(xlabel='Update',ylabel='Loss (display floor 1e-14)',title='Same objective, different step sizes')
for ax in axes:ax.legend(fontsize=8)
fig.tight_layout();plt.show()
table(['eta','multiplier 1-4 eta','final w','final loss'],[[r,f'{1-4*r:.3f}',f'{w[-1]:.6g}',f'{scalar_loss(w[-1]):.6g}'] for r,w in traces.items()],'Convergence depends on the local curvature and step size')
RESULTS['rates']={str(r):{'last_w':float(w[-1]),'last_loss':float(scalar_loss(w[-1]))} for r,w in traces.items()}
运行后看这里。 先看倍率 1−4η,再读参数轨迹与损失:正负号交替不等于损失必然上升。图的对数显示下限与表中实际数值要分开。
观察与边界: 此特定二次函数从非零起点收敛到0的条件是$0<\eta<.5$;.25恰好一步到0,.5来回振荡。对一般神经网络,曲率会随参数变化,不能把“.25最好”推广出去。图中为了取对数把显示值截至$10^{-14}$;表里的真实损失未截断。
记录: 我选的学习率____;预测倍率____;观察到同号/交替/放大____;这个结论依赖的函数____。
5 · 用训练数据拟合,用验证数据选,用测试数据评价
预测: 多项式次数越高,训练误差一定能说明新样本表现吗?把随机划分改为按$x$排序划分,会多出什么问题?
可改参数: regression_train_n、regression_noise、regression_degrees、regression_ridge、split_mode(random或ordered)。固定seed先运行默认配置,再只改一个因素。
这里明确构造$y=\sin(\pi x)+.25x+\epsilon$。用训练集求带L2惩罚的最小二乘参数,用验证MSE选次数;只对已经选好的一个模型计算测试MSE。采用Legendre多项式基改善数值条件,不把直接求解伪称为多轮SGD训练。图中的真函数因数据是合成的才可访问;左图纵轴固定为[-3,3]便于对照,外推曲线可能超出显示范围,误差表仍用完整预测计算。
查看代码 · 单元 26
rng=np.random.default_rng(int(P['regression_seed']));ntr=int(P['regression_train_n']);assert 8<=ntr<=200
nval,ntest=60,60;total=ntr+nval+ntest
xx=rng.uniform(-1,1,total);truth=np.sin(np.pi*xx)+.25*xx
yy=truth+float(P['regression_noise'])*rng.normal(size=total)
mode=P['split_mode'];assert mode in ['random','ordered']
order=rng.permutation(total) if mode=='random' else np.argsort(xx)
itr,iva,ite=np.split(order,[ntr,ntr+nval])
check('regression_disjoint_splits',len(set(itr)&set(iva))==len(set(itr)&set(ite))==len(set(iva)&set(ite))==0)
ridge=float(P['regression_ridge']);assert ridge>=0
degrees=list(map(int,P['regression_degrees']));assert all(1<=d<=20 for d in degrees)
fits={};rows=[]
for degree in degrees:
    Xtr=np.polynomial.legendre.legvander(xx[itr],degree);Xva=np.polynomial.legendre.legvander(xx[iva],degree)
    penalty=np.eye(degree+1);penalty[0,0]=0
    # Augmented least squares: mean training squared error + ridge*||non-intercept weights||^2.
    A=np.vstack([Xtr/np.sqrt(ntr),np.sqrt(ridge)*penalty]);b=np.r_[yy[itr]/np.sqrt(ntr),np.zeros(degree+1)]
    coef=np.linalg.lstsq(A,b,rcond=None)[0]
    tr=float(np.mean((Xtr@coef-yy[itr])**2));va=float(np.mean((Xva@coef-yy[iva])**2))
    fits[degree]={'coef':coef,'train':tr,'validation':va};rows.append([degree,f'{tr:.5f}',f'{va:.5f}'])
selected=min(degrees,key=lambda d:fits[d]['validation'])
table(['Degree','Training MSE','Validation MSE'],rows,f'Selection uses validation only; split={mode}')
plot_x=np.linspace(-1,1,300);fig,axes=plt.subplots(1,2,figsize=(11,4))
axes[0].scatter(xx[itr],yy[itr],s=18,label='train',color=BLUE);axes[0].scatter(xx[iva],yy[iva],s=14,facecolors='none',edgecolors=GREEN,label='validation')
axes[0].plot(plot_x,np.sin(np.pi*plot_x)+.25*plot_x,'k--',label='known synthetic function')
for degree,fit in fits.items():axes[0].plot(plot_x,np.polynomial.legendre.legval(plot_x,fit['coef']),label=f'degree {degree}')
axes[0].set(xlabel='x',ylabel='y',title='Constructed regression; test points withheld',ylim=(-3,3));axes[0].legend(fontsize=7)
pos=np.arange(len(degrees));axes[1].bar(pos-.17,[fits[d]['train'] for d in degrees],.34,label='train',color=BLUE);axes[1].bar(pos+.17,[fits[d]['validation'] for d in degrees],.34,label='validation',color=GREEN)
axes[1].set(xticks=pos,xticklabels=degrees,xlabel='Polynomial degree',ylabel='MSE',title='Compare frozen fitted models');axes[1].legend();fig.tight_layout();plt.show()
# Only now evaluate the locked choice on test. Test values never entered selection.
test_prediction=np.polynomial.legendre.legval(xx[ite],fits[selected]['coef'])
test_mse=float(np.mean((test_prediction-yy[ite])**2))
check('selected_by_validation',fits[selected]['validation']==min(f['validation'] for f in fits.values()))
print('Locked degree:',selected,' final test MSE:',round(test_mse,6))
print('Split x ranges:',{name:[round(float(xx[ids].min()),3),round(float(xx[ids].max()),3)] for name,ids in [('train',itr),('validation',iva),('test',ite)]})
RESULTS['regression']={'mode':mode,'selected_degree':selected,'train_n':ntr,'validation_n':nval,'test_n':ntest,'test_mse':test_mse,'candidates':{str(d):{'train':fits[d]['train'],'validation':fits[d]['validation']} for d in degrees}}
print('Checks passed:',sum(CHECKS.values()),'/',len(CHECKS))
运行后看这里。 先按验证MSE找到被锁定的次数,再看唯一报告的测试MSE。改为有序划分后,打印出的 Split x ranges 是解释外推困难的第一条证据。
观察与边界: 验证MSE低的候选并非必然拥有最低总体风险;这是单次有限样本构造。ordered使训练与评价覆盖不同$x$区间,因此误差还包含外推困难,不能只用“过拟合”解释。改变配置后先重置seed并重做全部划分;不要看测试结果后再挑次数。如果反复用本页同一个测试集作开发比较,应另保留新的最终评价数据。
记录模板(自愿练习): 假设____;只改参数____;固定项____;训练/验证变化____;按验证选择____;最终测试____;仍不能据此判断____。
来源与本次改编身份
- Spring26 Lecture2-3_softmax-regression:继承概率/交叉熵、logits与受控比较问题;本实验重新写成NumPy小构造,未复用原Fashion-MNIST训练输出或FakeData分支。
- Spring26 Lecture2-4_generalization:继承多项式复杂度与评价职责。历史代码按排序$x$的前后段划分;本版默认随机划分,将有序划分作为显式外推对照。
- 对齐当前Slides:两灯、隐藏坐标、Softmax、交叉熵、标量更新与训练/验证/测试职责。历史链接是来源定位;本页保存的输出来自本页代码,不代表重新执行过往年的云端Notebook。
返回课堂导读 · 返回幻灯片
按问题查阅:补充推导与机制核对
以下完整保留此前「从表示到学习:基础与优化自学」专题的扩展正文与独立机制代码。这里按问题选读,不属于本次随课必走路线;原文中的“主讲”是当时的叙述背景,本册按问题查阅;全课主讲、连续讲义与实验的对应关系以 CLS 00 统一导读为准。
1. 用例子约束规则:最近邻也有建模选择
把学习系统拆成五个对象:输入与标签、表示、评分或投票规则、选择规则的方法、未见数据上的评价。换成卷积或残差网络以后,这五个对象仍然存在。数据驱动把部分规则选择交给样本,却没有替我们选择任务、距离或评价协议。
最近邻保存已有样本,在指定表示与距离下找邻居。一个合成查询的前三位标签依次是 A、B、B:k=1 预测 A,k=3 预测 B。这里没有哪一个 k 天生正确;增大 k 可以平滑局部决策,也可能混入别类。若图像平移使同类的像素距离大幅增加,先检验表示与距离,不能只调 k。朴素逐一比较还会让预测成本随存储样本增长。
参数模型用一组参数概括可重复使用的评分规则。它把问题转为:这一函数族能否表达所需区分,以及训练能否找到合适参数。
先判断:同一个查询从 A 改判成 B,能否直接说明 k=3 泛化更好?
核对提示:不能。这里只改变了邻居范围;需要固定数据划分,在验证集选 k,并用保留的测试集评价。若距离本身与任务不相符,更多邻居不能保证修复。
来源与继续阅读
2. 同一线性规则的模板、贡献与几何视角
代数形式是 s=wᵀx+b。把 w 排回图像形状,就得到一张有正负权重的模板;每个像素的贡献仍是 wᵢxᵢ。课程的 4×4 合成图中,中间两列为 +1、两侧列为 −1,正贡献合计 10,负贡献合计 −3,加偏置 −2 得 5。全部变亮不一定提高分数,因为负权重也参与计算。这个分数还必须与其他类别分数比较。
几何上,s=0 是一条超平面。以 s=x₁+x₂−1 为例,P=(2,1) 得 2,R=(½,½) 得 0,Q=(−1,0) 得 −2。三个视角描述同一函数,并不是三个算法。
如果某组类别在固定表示下无法线性分开,再好的优化器也不会把直线变成曲线。另一方面,线性可分也不保证任意训练配置都能找到好解。诊断时把“能表示”“追求什么”“找得到”分开。
先判断:一张模糊的权重模板能否证明网络只认识平均外观?
核对提示:它展示的是一个线性评分模式。仅凭模板图不能断言整个系统如何使用非线性表示,也不能代替对输入与预测的检验。
来源与继续阅读
3. 相对分数、标签损失与正则偏好
Softmax 将分数变成相对概率。把 [2,1,0] 同时加 10,指数分子分母的公共倍数抵消,概率仍约为 [0.6652,0.2447,0.0900]。标签尚未出现时,只能比较预测;加入正确类别 y,单样本交叉熵是 −log p_y。正确类别概率从 0.20 降到 0.01,损失从约 1.609 增到 4.605,即使两次 argmax 都错,训练反馈仍不同。
对样本损失求平均得到经验目标。有限观测还允许许多不同的延续方式:穿过五个观测点的波动曲线,与接受一些误差的平缓曲线,在点间可能相差很大。没有未观测处的真值,不能只靠“更平滑”宣布胜者。
正则项把偏好写进目标,例如 J=L_data+λ‖W‖²/2。L2 惩罚指定参数的大幅增长,改变的是优化目标;正则强度依靠验证选择。它不是“保证新样本正确”的证书。
先判断:给所有 logits 加同一个常数,与把所有 logits 乘 10,有何不同?
核对提示:共同平移不改 Softmax;正比例缩放保持 argmax,却通常使概率更尖锐并改变交叉熵。比较时要说明讨论的是预测类别、概率还是损失。
推导时可用的关系式
$$\mathcal L_i=-\log p_{y_i},\qquad \mathcal L_{data}=\frac1N\sum_i\mathcal L_i$$
从一个样本的纠错信号,汇总为经验目标。
$$\min_\theta\;\mathcal L_{data}(\theta)+\lambda R(\theta)$$
拟合项与正则项共同定义优化目标。
来源与继续阅读
4. 当前位置的梯度估计,与连续更新后的轨迹
优化的“位置”是参数,损失是此处的目标值,更新规则决定下一步。小批量用部分样本估计当前梯度,使每次更新成本较低;噪声、硬件利用率与每轮更新数同时随 batch 大小变化。
在同一个参数位置,三批梯度分别为 (2,0.5)、(0.5,2)、(0.5,0.5),等权平均是 (1,1)。这可以说明估计之间的差异,却不能把三个箭头首尾相接当成真实训练轨迹。真实顺序训练在第一步后已经换了参数,下一批必须在新位置重新计算。
因此比较 batch 大小时应先决定预算:相同更新次数、相同 epoch 与相同计算时间并不是同一约束。记录训练与验证曲线,才知道更便宜的更新最终带来了什么。
先判断:12 个样本、batch=3 的一轮训练,为什么不是先求四个旧位置梯度,再统一改一次?
核对提示:标准逐批 SGD 通常会更新四次,每次在当时参数处求导。先累加再统一更新是另一种梯度累积方案,需要明确损失归一化与更新频率。
来源与继续阅读
5. 动量、自适应尺度与日程:先固定比较协议
Momentum 的一种约定是 vt=βv{t−1}+gt,θ{t+1}=θt−ηtv_t。长期同向分量累积、交替分量部分抵消;系数与学习率不合适时仍会越过有效区域。不同软件也可能采用等价但缩放不同的速度定义,比较公式时先对齐约定。
AdaGrad 累加每个坐标的平方梯度,按其平方根缩放更新;长期累积可能让有效步长持续缩小。Adam 用一阶与二阶矩的指数平均,并通常做偏差修正。它们改变更新方向或尺度,不能替代表示与数据判断。
学习率日程改变时间上的步长。较大早期步长可能加快移动,也可能不稳定;后期减小有助于细化,warmup 与余弦安排也需要具体任务证据。恢复训练时,除模型参数外还应保留优化器状态与日程位置。
下面的小实验只考察同一个二次目标,使用固定初值与相同步数。它不构成 SGD、Momentum、Adam 在图像任务中的性能排名。先写下你对 η=0.05 与 η=0.6 的预测,再运行。
先判断:若两个架构只报告最终准确率,学习率和训练预算不同,能否把差异全部归给结构?
核对提示:不能。应报告并尽量对齐训练条件;至少检查训练曲线、验证选择规则和预算,区分表达能力与优化可达性。
推导时可用的关系式
$$\theta_{t+1}=\theta_t-\eta_t\nabla_\theta\mathcal L_t$$
SGD基本更新;mini-batch引入梯度估计噪声。
来源与继续阅读
6. 新坐标中的简单读出,与学习是否成功
MLP 可写成 h=σ(W₁x+b₁),s=W₂h+b₂。非线性隐藏层让表示随参数改变,最后一层仍可采用线性读出。若去掉中间非线性,仿射映射的复合仍是仿射映射。
另一个手工构造的例子是 x∈{−2,−1,0,1,2},两端 ±2 为外类,其他为内类。令 h₁=max(x,0),h₂=max(−x,0),则 h₁+h₂=|x|,以 1.5 为阈值便可分开。它证明所选表示存在一个可行解,不证明训练一定找到它。它与主讲两灯例子是不同的教学构造,不能混成一份实验数据。
层级表示是在已有中间量上继续组合,不是每层重新获得一个独立标签。计算图记录乘法、加法、激活及其依赖;反向传播沿这些依赖复用局部导数。前向中间量与当前参数共同决定本次梯度,更新发生在求导之后。
先判断:最后一层是线性的,是否意味着原始输入到答案的系统也是线性的?
核对提示:只有前面也都是仿射变换、没有改变函数类的非线性时才可如此合并。线性读出在非线性特征空间中可以对应原空间的复杂边界。
推导时可用的关系式
$$h=\sigma(W_1x+b_1),\qquad s=W_2h+b_2$$
先学表示h,再在h中计算类别分数。
来源与继续阅读
从主讲继续:推导边界与研究来源
两灯的两个 ReLU 是手工构造的可行解,用来证明非线性表示能改变可分性;它没有运行一次优化来证明随机初始化一定学到此解。分数、概率、损失与参数更新是四个不同对象。自学时请把每一步写成输入、输出、可更新参数三列,再回到本本的优化诊断。
主讲研究来源
- CS231n 2026 · Image Classification with Linear Classifiers
- CS231n 2026 · CNNs
- CS231n 2026 · CNN Architectures
- D2L · From Fully Connected Layers to Convolutions
- D2L · Softmax Regression
- Stanford CS231n · Linear Classification
- D2L · Multilayer Perceptrons
- CS231n 2026 · Neural Networks and Backpropagation
- Stanford CS231n · Backpropagation
- D2L · Optimization and Deep Learning
- CS231n 2026 · Regularization and Optimization
- Stanford CS231n · Optimization
- He et al. · Deep Residual Learning (2015)
- D2L · Forward and Backward Propagation
- D2L · Minibatch Stochastic Gradient Descent
独立核对:先预测,再运行
下面是完整、独立的小规模 Python 核对,只使用标准库;无需下载、安装、训练或访问外部服务。它保留“教学构造”的身份。先写预测,运行后解释哪一项支持判断,再只改一个条件复查。下方没有预填远端执行输出。
查看代码 · 单元 50
# 独立教学构造:二次目标与步长,不训练任何图像模型。
import math
def loss(w): return 0.5*(w[0]**2+10*w[1]**2)
def grad(w): return [w[0],10*w[1]]
def run(eta,steps=8):
    w=[2.,1.]; trace=[loss(w)]
    for _ in range(steps):
        g=grad(w); w=[a-eta*b for a,b in zip(w,g)]; trace.append(loss(w))
    return w,trace
for eta in [0.05,0.6]:
    w,trace=run(eta)
    print('eta',eta,'loss', [round(v,6) for v in trace])
assert run(.05)[1][-1] < run(.05)[1][0]
assert run(.6)[1][-1] > run(.6)[1][0]
scores=[2.,1.,0.]
softmax=lambda a:[math.exp(x-max(a))/sum(math.exp(z-max(a)) for z in a) for x in a]
assert all(abs(a-b)<1e-12 for a,b in zip(softmax(scores),softmax([x+10 for x in scores])))
print('共同平移的概率:',softmax(scores))
继续一步:修改一个数值或条件,先写变化方向,再运行核对。不要删除断言来让代码“通过”;若主动改变了断言的前提,应同时写出新预期。机制小算例通过,只说明这一小段计算与预期一致,不等于完整图像实验或新架构训练成功。